Kun PDF ei upota fonttia, HotPDF-komponentti renderöi kyseisen tekstin asennetulla Windows-fontilla, jonka valitsee HPDFMapBaseFontToSystem: se dekoodaa /BaseFont-nimen, irrottaa tyyliosan, kokeilee useita kirjoitusasuja kunnes GDI vahvistaa perheen olevan asennettuna, mittaa puuttuvat standardin 14 -leveydet metriikoiltaan yhteensopivista fonteista ja muuntaa yksitavuiset koodit Unicodeen ennen piirtämistä. Jokainen noista vaiheista on olemassa, koska naiivi versio kaatui oikeisiin tiedostoihin. RenderLoadedPageToBitmap-sivurenderoija hoitaa upotetut ohjelmat hyvin; tämä on tarina fonteista, jotka eivät ole tiedostossa lainkaan
Miksi GDI piirtää hiljaa väärän kirjasintyypin upottamattomalle fontille?
GDI ei koskaan raportoi puuttuvaa fonttia: anna CreateFontIndirectille kirjasinnimi, jota se ei tunne, ja se valitsee hiljaa sijaisen, usein eri serifin ilman lihavuutta. Varhainen renderoija välitti PDF-nimen melkein sellaisenaan, joten TimesNewRoman,Bold, TimesNewRomanPS-BoldMT ja SegoeUI-Semibold eivät täsmänneet mihinkään ja tulivat ulos siinä, minkä GDI poimi. Nimet voivat olla vielä pahempiakin. ISO 32000-1 §7.3.5 antaa nimen kirjoittaa minkä tahansa tavun muodossa #xx, ja CJK-tuottajat kirjoittavat fonttinimet rutiininomaisesti eskapoituna UTF-8:na tai vanhempina koodisivutavuina; ennen v2.766.69 eskapot itsestä tuli kirjasinnimi. HPDFMapBaseFontToSystem dekoodaa nyt eskapot ensin, palauttaa kelvollisen UTF-8-tavusekvenssin merkkeinään ja lukee muut ylätavut järjestelmän koodisivulla
Tyylin irrottaminen on kohta, jossa heuristiikka puree. Pilkku päättää aina perheen (Arial,Bold antaa Arialin), mutta väliviiva vain silloin, kun sitä seuraava sana on tyyli: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra tai Condensed. Tuo sääntö pitää MS-Minchon ehjänä muuttaessaan Calibri-Lightin Calibriksi. HotPDF kokeilee sitten perheen kirjoitusasuja ja sen jälkeen perheen kirjoitusasuja ilman PSMT-, MT- tai PS-päytettä. Versiosta v2.768.18 alkaen nämä kirjoitusasut kattavat jokaisen välilyöntivalinnan paikoissa, jossa sana voi alkaa: ennen versaalia, jota pieni kirjain seuraa (MyriadPro muuttuu muodoksi Myriad Pro), ajon viimeisen versaalin kohdalla, jota pieni kirjain seuraa (UIGothic), ja alkavan MS:n jälkeen (MSPGothic), täysin välilyönnillisestä muodosta nimeen sellaisenaan kirjoitettuna; yli neljän tällaisen paikan jälkeen kokeillaan vain täysin välilyönnillistä ja yhteenliitettyä nimeä. Välilyöntejä ei voi soveltaa sokkona, koska Windows pitää jotkin sanat yhteenliitettyinä: SimSun on asennettuna täsmälleen tuolla kirjoitusasulla, kun taas MicrosoftYaHei, MicrosoftJhengHei ja MSPGothic kuuluvat fontteihin Microsoft YaHei, Microsoft JhengHei ja MS PGothic. Ennen v2.768.18 mappaaja laittoi välilyönnin jokaisen sisemmän versaalin eteen, joten MicrosoftYaHei haettiin muodossa Microsoft Ya Hei eikä sitä koskaan löytynyt. Ehdokas laskeutuu asennetuksi, kun CreateFontIndirectin jälkeen kutsuttu GetTextFace palauttaa pyydetyn nimen tai, versiosta v2.768.18 alkaen, kun valitun fontin name-taulukko listaa sen perheeksi, kokonaiseksi tai typografiseksi perheenimeksi millä tahansa kielellä; vastaus on välimuistissa nimeä kohden, joten asiakirjat, joissa on monta asentamatonta fonttia, eivät enää kysele Windowsia jokaisesta nimestä jokaisella sivulla
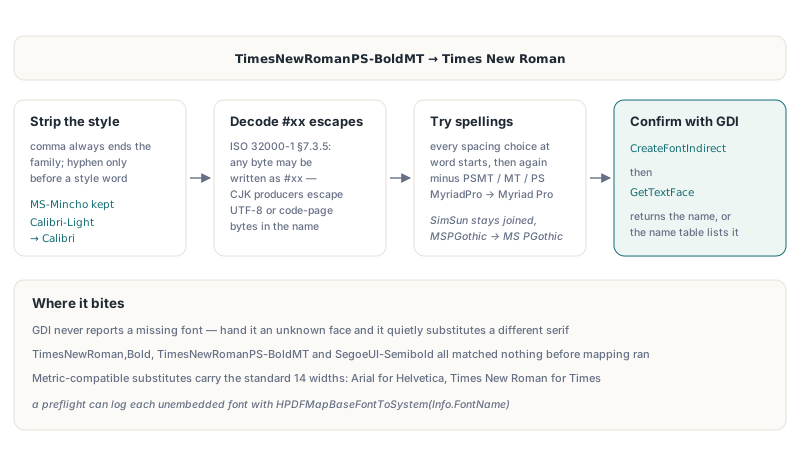
Koska mappausfunktio on julkinen HPDFRenderFontMetrics-yksikössä, esitarkistusraportti voi näyttää, millä asennetulla perheellä jokainen upottamaton fontti renderöityy, hyödyntäen fonttiluettelointia, jonka THotPDF jo näyttää ladatuille asiakirjoille:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Miten HotPDF mittaa standardin 14 fonttien leveydet ilman /Widthsia?
HotPDF mittaa puuttuvat etenemät asennetulla fontilla, jolla on samat metriikat, koska ISO 32000-1 §9.6.2.2 sallii standardin 14 fonttien jättää /Widthsin pois ja kirjasto ei toimita mukanaan AFM-taulukoita. Arial kantaa Helvetica-metriikat, Times New Roman kantaa Timesin ja Courier New kantaa Courierin, joten HPDFMeasureBaseFontWidths luo vastaavan kirjasintyypin arvolla lfHeight = -1000 ja kutsuu funktiota GetCharWidth32W; tuolla korkeudella tulos on jo PDF-leveyksien käyttämissä 1/1000 em -yksiköissä. Renderoija muuntaa ensin jokaisen koodin Unicodeen /Encodingin, /BaseEncodingin ja /Differencesin kautta olettaen StandardEncodingin. SVG-vienti ja tekstin poiminta komistuivat yhteen lisäansaan: standardi Type 1 -fontti ilman /Encodingia ylipäätään tuotti dekooderin ilman koodaustietoa, SVG-vienti ei koskaan rekisteröinyt sitä, ja jokainen mitattu leveys meni käyttämättä. Implisiittisen StandardEncodingin toimittaminen korjasi asian, kunhan se merkittiin ennalta määritellyksi koodaukseksi; reitittäminen CMap-nimen polulle dekoodaa jokaisen koodin arvoksi 0, ja jokainen leveys seuraa perässä
Lihavoitu, kursiivi ja yhdellä pielessä fonttikuvaajan lipuissa
Fonttikuvaajan /Flags-merkintä numeroi bitinsä ykkösestä, eivät nollasta, joten ForceBold on bitti 19 ($40000) ja Italic on bitti 7 ($40), ISO 32000-1 taulukon 123 mukaan. Vanha koodi testasi arvoa $20000, joka on bitti 18, SmallCap. Virhe selvisi hengissä versiosta v2.345.0 versioon v2.766.53, koska /FontDescriptor on lähes aina epäsuora viittaus ja fontin rakentaja luki vain suorat objektit, joten koko lippuhaara ei koskaan ajanut, ja sama sokeus ohitti /Widths 12 0 R:in ja ladot tekstin 500-yksikköisellä varajäsen-etenemällä. Kun v2.766.53 alkoi ratkaista epäsuoria viittauksia renderoijan kautta, bitti piti korjata samassa muutoksessa, muuten jokainen kapiteelifontti olisi yhtäkkiä renderöitynyt lihavana:
const
  // ISO 32000-1 taulukko 123 laskee bittipaikat ykkösestä
  FD_ITALIC     = $00040;  // bitti 7
  FD_SMALLCAP   = $20000;  // bitti 18, ei paino
  FD_FORCEBOLD  = $40000;  // bitti 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;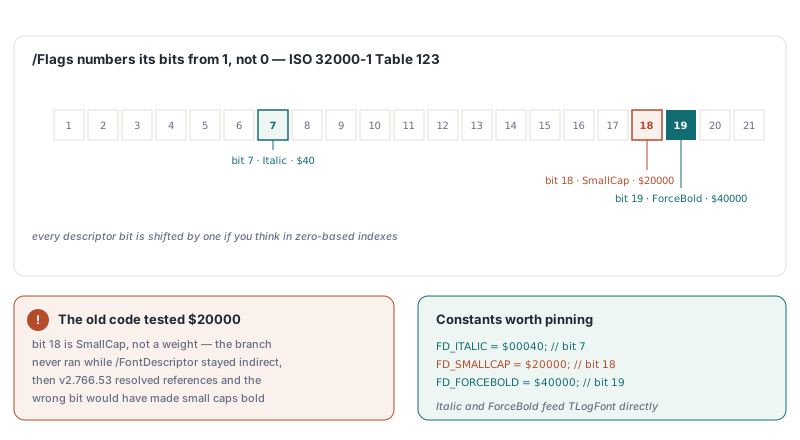
Miksi UCS2-CMapin CJK-fontit saavat väärät leveydet?
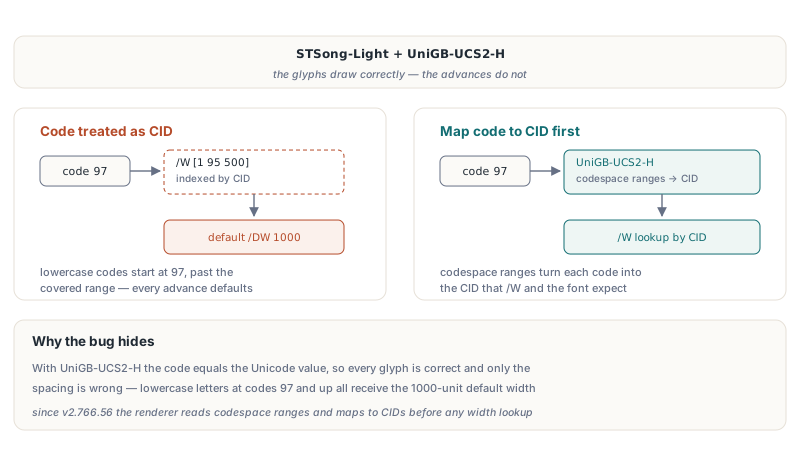
Ennalta määritellyn UCS2-CMapin CJK-teksti piirtää oikeat glyyfit mutta väärän välityksen, kun renderoija käsittelee koodia CID:nä, koska /W indeksoidaan CIDeillä, eivät merkkikoodeilla. Arvoilla STSong-Light ja UniGB-UCS2-H koodi sattuu olemaan yhtä kuin Unicode-arvo, joten GDI piirtää oikeat merkit ja vika piiloutuu etenemiin: pienet kirjaimet saapuvat koodina 97 ja siitä ylöspäin, putoavat ulos /W-merkinnän kuten [1 95 500] alueelta, ja kaikki saavat oletusleveyden /DW arvon 1000. Versiosta v2.766.56 alkaen HotPDF:n renderoija lukee koodit CMapin codespace-alueiden kautta (ISO 32000-1 §9.7.6.2) ja mapaa ne CIDeiksi ennen leveyksien hakua. Vain sisäänrakennetut UCS2- ja UTF16-taulukot ja upotetut CMap-streamit ovat käytössä; identiteettiarvio jollekin kuten GBK-EUC-H näyttäisi vain tuetulta tuottaen väärää tulosta, joten renderoija ei teeskentele
Miksi aksenttimerkit muuttuvat kysymysmerkeiksi kiinalaisessa Windowsissa?
Yksitavuiset koodit eivät saa koskaan päätyä ANSI-("A")-GDI-funktioille, koska GetGlyphOutlineA ja GetGlyphIndicesA tulkitsevat tavut järjestelmän koodisivulla, kun taas TextOutA käyttää valitun fontin merkistöä. Kiinalaisessa järjestelmässä Arialin tavu $A9 (copyright-merkki Windows-1252:ssa) muuttui GBK-johtotavuksi ja renderöityi merkiksi "?", ansaan, johon v2.766.83:ssa lisätty vihjeetön ääriviivapolku komistui suoraan. v2.767.3 kysyy toteutuneelta fontilta sen merkistön funktiolla GetTextCharset, muuntaa sen koodisivuksi funktiolla TranslateCharsetInfo, ajaa tavun läpi funktiolla MultiByteToWideChar ja kutsuu W-funktioita; symbolifontit käyttävät sen sijaan arvoa U+F000 plus koodi. Koodaukset, jotka eroavat Windows-1252:sta — /Differences, StandardEncoding, MacRomanEncoding — mapataan Unicodeen ennen kuin mikään järjestelmäfontti näkee ne
Mitkä ovat piirtämisen rajat järjestelmäfonteilla?
Järjestelmäfonteilla renderöinti on aproksimaatio, ja HotPDF-komponentti on rehellinen siitä, missä se pysähtyy. Ennen v2.768.18 asennustarkistus vertasi vain nimeä, jonka GetTextFace palauttaa, ja lokalisoitua Windowsia käytettäessä kyseinen funktio raportoi perheen nimen järjestelmän kielellä, joten Microsoft YaHei kiinalaisessa Windowsissa tai Yu Mincho japanilaisessa Windowsissa todettiin puuttuvaksi ja piirrettiin GDI-sijaisella; versiosta v2.768.18 alkaen toisella nimellä palaava kirjasintyyppi haetaan myös fontin name-taulukosta, ja tällaiset fontit löytyvät. Metriikkayhteensopivuus on taattu vain Helvetica-, Times- ja Courier-perheille; Symbol mappautuu Symboliin ja ZapfDingbats Wingdingsiin, mikä on paikkatäyttö eikä vastine. Yllä oleva esitarkistus näkee myös vain kunkin sivun /Resources-sanakirjan fontit, eivät niitä, joihin viitataan form-XObjectien sisältä. Kun koodia ei yhä voi piirtää, kirjoituksen piirtohetken ratkaisemattomien glyyfien seuranta raportoi sen, mikä on parempi signaali kuin pikkukuvien tuijottaminen
Kestävä korjaus asuu laatimispuolella. HotPDF itse kirjoittaa oletuksena arvolla FontEmbedding True, sijaistaen upotetun Arialin silloinkin, kun koodi kutsuu SetFontia arvolla Helvetica, ja upotettu teksti kulkee kirjoituksen upotettujen fonttien glyyfirenderoijan kautta minkään yllä olevan arvauksen sijaan. Halpa vartiointi saapuville tiedostoille on varoittaa ennen renderöintiä, kun mapattu perhe ei ole näyttöfonttiluettelossa:
// VCL: Screen.Fonts listaa asennettujen perheiden nimet (Forms-yksikkö)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Koko komponentin, mukaan lukien sivujen renderöinti, tekstin poiminta ja fonttisubsetting kirjoituspuolella, näet tuotteesta HotPDF Delphi PDF component tuotesivulta