Sivun tekstin poimiminen on ongelman helppo puolisko. Sillä hetkellä, kun käyttäjä kirjoittaa sanan hakukenttään ja odottaa katseluohjelman hyppäävän siihen ja piirtävän sen ympärille keltaisen laatikon, tarvitset jotain, mitä litteä tekstimerkkijono ei voi antaa: sivun, jolla kukin osuma sijaitsee, ja suorakulmion, jonka se vie PDF-koordinaateissa. Sivun yli ketjutettu merkkijono on menettänyt tuon geometrian. Voit löytää alimerkkijonon, mutta et voi osoittaa sitä
PDF Library for Delphi on natiivi Object Pascal -PDF-kirjasto Delphille ja C++Builderille, ja versiosta 3.78.0 alkaen se vastaa juuri tähän kysymykseen. Kolme kyselyrajapintaa istuu olemassa olevan tekstilohkopoimijan päällä: SearchText käy läpi sivuvälin ja palauttaa jokaisen osuman sivun ja akseleihin suuntautuneen suorakulmion kera, EnumPageElements luetteloi kaiken yhdellä sivulla (sekä tekstilohkot että upotetut kuvat), ja GetTextInAreaEx ilmoittaa jokaisen alueen sisällä olevan lohkon suorakulmion sen sijaan, että litistäisi ne merkkijonoluetteloksi. Yksikään niistä ei koske kirjoituspolkua; ne ovat puhtaita lukupuolen lisäyksiä koneiston päälle, joka kirjastolla jo oli
Miksi geometria elää tekstilohkoluettelossa, ei suppilossa
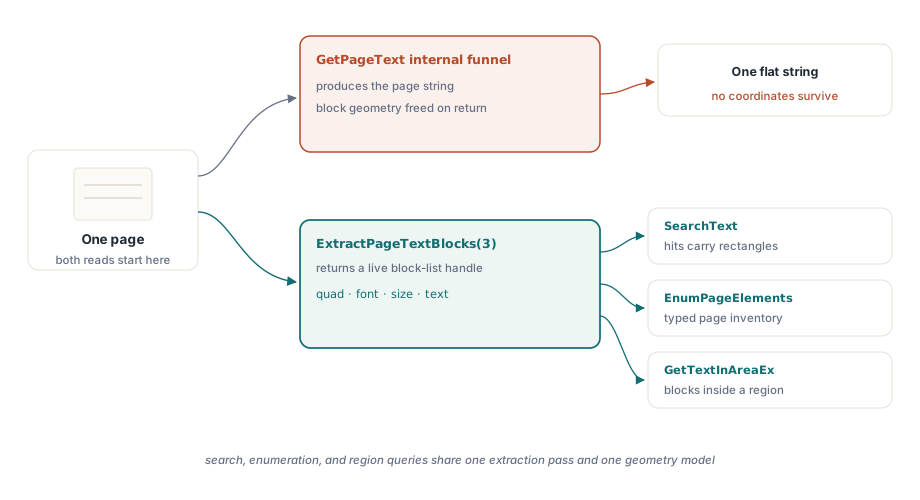
Luonnollinen vaisto on käyttää uudelleen sitä, mitä GetPageText ajaa sisäisesti. Tuo polku kulkee väliaikaisen poiminta"suppilon" kautta, joka tuottaa sivun merkkijonon ja vapauttaa itsensä ennen kuin kutsu palautuu. Siinä vaiheessa, kun sinulla on tulos hallussasi, lohkokohtaiset koordinaatit ovat jo poissa. Ne eivät koskaan olleet sinun pidettäväksesi
Koordinaatit kuitenkin säilyvät toisenlaisessa rakenteessa. ExtractPageTextBlocks(3) palauttaa tekstilohkoluettelon kahvan, jonka jokainen alkio kantaa mukanaan kahdeksan double-arvon rajaavan nelikulmion, fontin nimen, fontin koon ja lohkon tekstin. Tuo kahva on ainoa paikka, jossa geometria säilyy poiminnan jälkeen, minkä vuoksi jokainen uusista kyselyrajapinnoista on rakennettu sen, ei suppilon, päälle. Lohkoluettelon uudelleenkäyttö tarkoittaa, että haku, luettelointi ja aluekyselyt jakavat kaikki saman poimintakierroksen ja saman määritelmän siitä, missä lohko sijaitsee
Näin SearchText-funktion muoto seuraa tuosta rajoitteesta. Jokaisella sivulla välillä se poimii lohkoluettelon, lukee kunkin lohkon tekstin GetTextBlockText-funktiolla, testaa sen kyselyä vasten ja osuvien lohkojen kohdalla pelkistää nelikulmion suorakulmioksi. Palautettu osuma on pieni tietue:
type
  TPDFlibSearchHit = record
    Page: Integer;                       // osuman sivu, 1-pohjainen
    Left, Top, Right, Bottom: Double;    // akseleihin suuntautunut osuman suorakulmio
    MatchText: WideString;               // lohkon teksti, joka sisälsi kyselyn
  end;
Sidottu taulukko on X/Y-lomitettu, ei neljää kulmaa
Tämä on yksityiskohta, joka puree ensimmäisenä. GetTextBlockBound(ListID, Index, BoundIndex) ottaa BoundIndex-parametrin väliltä 1–8, eivätkä nuo kahdeksan arvoa ole "kulma 1, kulma 2, kulma 3, kulma 4" kahden kentän ryhminä, kuten saattaisi arvata. Ne ovat X, Y, X, Y, X, Y, X, Y: parittomat indeksit ovat X-koordinaatteja, parilliset indeksit ovat Y-koordinaatteja, neljä pistettä kaikkiaan. Lue ne väärässä parituksessa, ja suorakulmiostasi tulee hölynpölyä
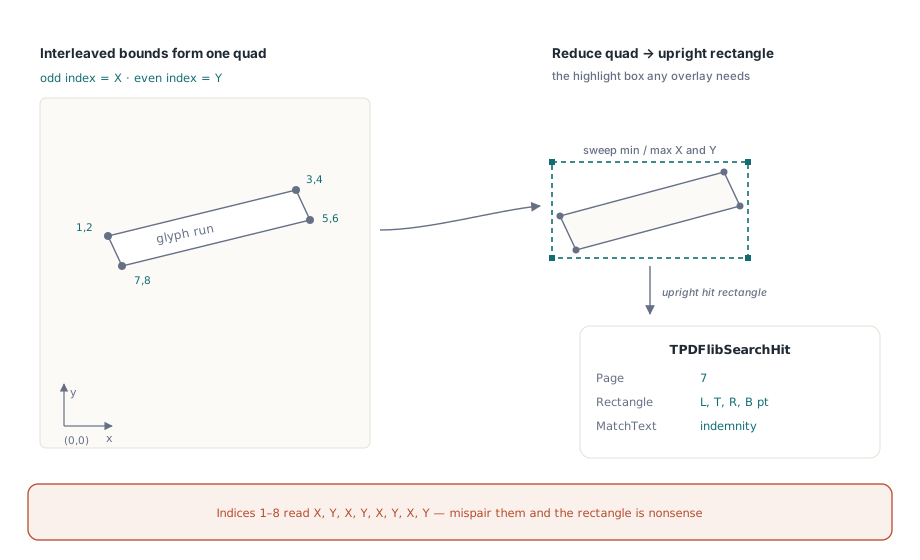
Syy siihen, että kyseessä on ylipäätään nelikulmio eikä pelkkä suorakulmio, on kierto. Kulmassa olevalla tekstilohkolla on aito neljän pisteen rajaava monikulmio, ja kahdeksan double-arvoa kuvaavat sen uskollisesti. Korostus-ja-hyppy-käyttötapauksessa haluat lähes aina sen sijaan pystysuoran laatikon, joten kirjasto pelkistää nelikulmion akseleihin suuntautuneeksi suorakulmioksi käymällä läpi neljä pistettä niiden minimi- ja maksimi-X:n ja -Y:n löytämiseksi. Kierretty teksti litistyy pystysuoraksi laatikoksi, joka sulkee sen sisäänsä, ja juuri sitä korostuspeite tarvitsee:
var
  Pdf: TPDFlib;
  Hits: array[0..255] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('contract.pdf', '');
    // Etsi sivut 1–10, ei kirjainkoosta riippuvainen, alimerkkijonohaku.
    Found := Pdf.SearchText('indemnity', [], '1-10', Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Format('p%d: [%.1f %.1f %.1f %.1f] %s',
          [Hits[I].Page, Hits[I].Left, Hits[I].Top,
           Hits[I].Right, Hits[I].Bottom, Hits[I].MatchText]));
  finally
    Pdf.Free;
  end;
end;
Huomaa, että suorakulmio on PDF:n käyttäjätilan pisteinä, joiden origo on sivun vasemmassa alakulmassa — sama koordinaatisto, jota käytät piirto- ja merkintäkutsuissa. Tämä on tietoinen valinta: hakuosumasta saatava suorakulmio on suorakulmio, jonka voit antaa suoraan korostusmerkinnälle tai "vieritä tähän" -komennolle ilman mitään muunnoksia
Kirjainkoon herkkyys, koko sana ja missä CJK eroaa
Toinen parametri on TPDFlibSearchOptions-joukko, joka koostuu arvoista soCaseSensitive ja soWholeWord. Tyhjä joukko [] on yleisin tapaus: ei kirjainkoosta riippuvainen alimerkkijonohaku. Lisää soCaseSensitive, jotta Indemnity ja indemnity erotetaan toisistaan, lisää soWholeWord, jotta sign ei täsmää sanan signature sisällä, tai yhdistä molemmat
Koko sanan täsmäys tarvitsee määritelmän sille, mikä on sananraja, ja tässä sääntö kannattaa sanoa suoraan, koska se on suunnittelultaan ASCII-keskeinen. Merkki lasketaan osaksi sanaa, kun se on ASCII-kirjain, ASCII-numero tai alaviiva: tunnisteiden säännöistä tuttu [A-Za-z0-9_]-luokka. Osuma täyttää koko sanan ehdon vain, kun sitä välittömästi edeltävät ja seuraavat merkit eivät ole sanamerkkejä (tai osuma on lohkon reunalla)
Seuraus muille kuin latinalaisille kirjoitusjärjestelmille on hyvä tietää, ennen kuin julkaiset monikielisen hakukentän. Koska han-merkit, kana ja muut ei-ASCII-kirjaimet jäävät tuon luokan ulkopuolelle, jokainen niiden vieressä oleva raja luetaan sanattomaksi reunaksi. Käytännössä tämä tarkoittaa, että koko sanan haku CJK-tekstissä käyttäytyy ikään kuin jokainen kohta olisi kelvollinen sanaraja, jolloin lippu käytännössä taantuu siellä alimerkkijonohauksi. Tämä on dokumentoitu rajoitus, ei virhe, ja se vastaa käytöstä, jonka mallin mukaan ominaisuus rakennettiin. Jos korpuksesi on pääosin CJK-tekstiä, koko sanan tila ei anna sinulle segmentointia, jonka erillinen tokenisoija antaisi; suunnittele sen mukaan sen sijaan, että luotat siihen
Yksi toteutuksen alaviite, joka selittää muualla ilmenevän hienovaraisten virheiden luokan: kirjainkoosta riippumaton vertailu käyttää UpperCase-funktiota WideString-arvolle, ei AnsiUpperCase-funktiota. Ansi-versio palauttaa AnsiString-arvon, joka ei sopisi yhteen loppupolun käyttämän WideString-tyypin kanssa, ja näiden kahden sekoittaminen tuottaa tyyppiristiriitoja ja, mikä pahempaa, häviöllistä muunnosta merkeille, jotka jäävät aktiivisen koodisivun ulkopuolelle. Unicode sisään, Unicode ulos, koko matkan
Yksi sivuväliparsija koko kirjastolle
Kolmas parametri on sivuvälimerkkijono, kuten "1,3,5-9". Sen jäsentämisessä ei ole mitään erikoista: sama PLParsePageRangeList, joka tukee PrintPages-funktiota ja sivujenkopiointirutiineja, käsittelee sen myös täällä, joten väli, joka tulostuu oikein, hakee myös oikein. Tyhjä välimerkkijono on tunniste kohdalle "jokainen sivu", jolloin SearchText rakentaa täydellisen listan itse
Laajuudella on merkitystä kustannuksen kannalta. Kymmenen sivun siivun hakeminen tuhatsivuisesta asiakirjasta poimii lohkot kymmeneltä sivulta, ei tuhannelta, koska silmukka valitsee ja poimii vain ne sivut, jotka väli nimeää. Kun jo tiedät, että jokin lauseke sijaitsee liitteessä, sano se välissä ja jätä loput tiedostosta väliin
Sisäisesti sekä haku että luettelointi vaihtavat valittua sivua iteroidessaan, joten kumpikin tallentaa kutsujan valitun sivun kutsun alussa ja palauttaa sen finally-lohkossa. Kutsu SearchText-funktiota kesken sivun rakentamisen, ja valintasi on täsmälleen siinä, mihin sen jätit, kun kutsu palautuu. Tämä tallenna-ja-palauta-sopimus on sellainen asia, jonka huomaa vain silloin, kun se puuttuu, ja juuri siksi se on olemassa
Koko sivun luettelointi: teksti ja kuvat yhdessä listassa
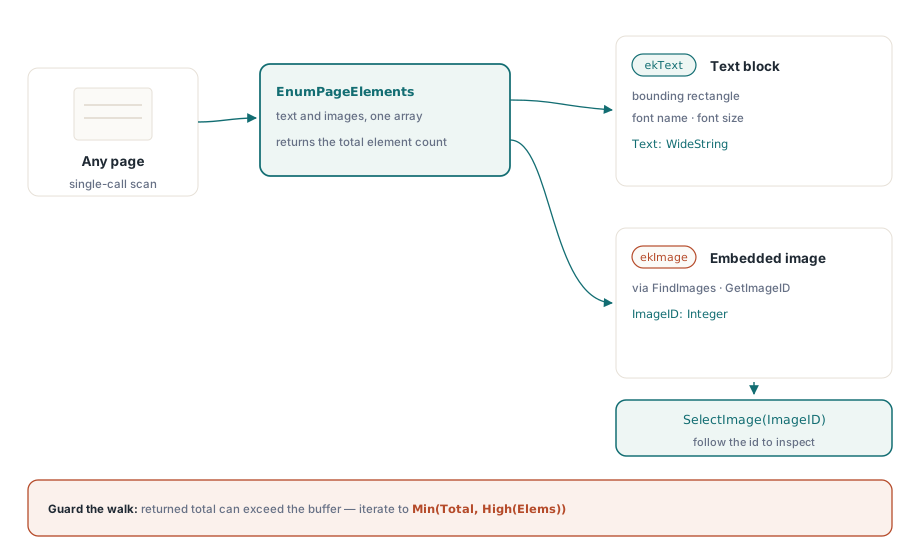
Haku vastaa kysymykseen "missä tämä sana on". Toinen puoli itsetutkiskelusta on "mitä tällä sivulla ylipäätään on", ja se on EnumPageElements. Se palauttaa yhden yhtenäisen listan, jossa jokainen alkio on joko tekstilohko tai upotettu kuva, erotettuna Kind-kentällä:
type
  TPDFlibPageElementKind = (ekText, ekImage);

  TPDFlibPageElement = record
    Kind: TPDFlibPageElementKind;
    Page: Integer;
    Left, Top, Right, Bottom: Double;
    Text: WideString;        // ekText
    FontName: WideString;    // ekText
    FontSize: Double;        // ekText
    ImageID: Integer;        // ekImage; käytettävissä SelectImage-/GetImageID-funktioiden kanssa
  end;
Tekstielementit tulevat samasta ExtractPageTextBlocks-kierroksesta, joten kukin niistä saapuu suorakulmionsa, fonttinsa nimen ja kokonsa jo täytettynä. Kuvaelementit tulevat sivun upotettujen kuvien listasta FindImages- ja GetImageID-funktioiden kautta; niiden mukana kulkeva ImageID on kahva, jonka syötät SelectImage-funktiolle kuvan tarkempaa tarkastelua varten. Molemmat lajit päätyvät yhteen taulukkoon, joten yksi kierros sivun yli näkee kaiken sillä olevan
var
  Pdf: TPDFlib;
  Elems: array[0..511] of TPDFlibPageElement;
  Total, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('report.pdf', '');
    Total := Pdf.EnumPageElements(1, Elems);
    for I := 0 to Total - 1 do
      if I <= High(Elems) then
        if Elems[I].Kind = ekText then
          WriteLn(Format('text  %s/%.1f  "%s"',
            [Elems[I].FontName, Elems[I].FontSize, Elems[I].Text]))
        else
          WriteLn(Format('image id=%d', [Elems[I].ImageID]));
  finally
    Pdf.Free;
  end;
end;
Tässä on laskentakäytäntö, joka noudattaa kirjaston muuta tapaa ja jota on kunnioitettava, tai muuten luet alustamatonta muistia. Paluuarvo on elementtien kokonaismäärä, joka voi olla suurempi kuin antamasi taulukko. Funktio täyttää vain niin monta paikkaa kuin mahtuu ja jatkaa lopun laskemista, aivan samoin kuin allekirjoitusten luettelointi toimii. Suoja on siis aina sama: rajoita silmukkasi pienempään palautetusta määrästä ja arvosta High(array), älä koskaan iteroi määrään sokeasti. Yllä olevat esimerkit näyttävät tästä syystä tarkistuksen I <= High(...). Jos paluuarvo ylittää puskurisi, mitoita suurempi taulukko ja kutsu uudelleen
Jos olet käyttänyt kirjaston matalamman tason tekstilohkokutsuja, tämä on tyypitetty, geometriatietoinen kerros niiden päällä; taustalla oleva poiminta on sama, joka on kuvattu artikkelissa Delphi PDF -tekstin, kuvien ja fonttien poiminta PDF Library for Delphi:lla. Ja kun tavoitteena ei ole "missä tämä teksti on" vaan "miten tämä asiakirja on rakennettu avustavaa teknologiaa varten", rinnakkainen lukupuolen tarina on tagatun PDF:n rakennepuu, joka paljastaa loogisen lukujärjestyksen fyysisen lohkoasettelun sijaan
Aluekyselyt, kun tiedät jo mistä etsiä
Joskus sinulla ei ole lainkaan hakusanaa; sinulla on suorakulmio. Lomakemalli sijoittaa laskun numeron aina oikeaan yläkulmaan, tai skannattu asettelu varaa kiinteän kaistaleen taulukolle. GetTextInAreaEx palvelee tätä tapausta. Se on GetTextInArea-funktion rajoja kantava vastine: siinä missä vanhempi kutsu palauttaa alueelle litteän merkkijonolistan, uusi palauttaa jokaisen säilytetyn lohkon suorakulmion tekstin ohella, joten opit paitsi mitä laatikossa on, myös missä kohtaa sen sisällä kukin rivi sijaitsee
var
  Pdf: TPDFlib;
  Hits: array[0..63] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('invoice.pdf', '');
    Pdf.SelectPage(1);
    // Left, Top, Width, Height PDF-pisteinä valitulla sivulla.
    Found := Pdf.GetTextInAreaEx(360, 720, 180, 60, Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Hits[I].MatchText);
  finally
    Pdf.Free;
  end;
end;
Kaksi asiaa kannattaa pitää selvänä. GetTextInAreaEx toimii sillä hetkellä valitulla sivulla, joten kutsu ensin SelectPage-funktiota; toisin kuin SearchText, se ei ota väliä parametrina. Ja lohko säilytetään, kun se leikkaa kyselysuorakulmion, ei vain silloin kun se sisältyy siihen kokonaan, joten rajan yli menevä rivi tulee silti mukaan. Se on yleensä se, mitä haluat käsin piirretylle valintalaatikolle, mutta jos tarvitset tiukkaa sisältymistä, voit suodattaa palautetut suorakulmiot itse, koska sinulla on ne nyt käytössäsi
Käytännössä
Kaikkia kolmea kutsua yhdistävä punainen lanka on se, ettei geometriaa enää tarvitse jälkikäteen rakentaa uudelleen. Hakuosuma tietää sivunsa ja laatikkonsa. Sivuelementti tietää suorakulmionsa ja, tekstin osalta, fonttinsa. Aluekysely kertoo, mihin kukin rivi osuu. Se riittää oikean etsi-ja-korosta-ominaisuuden, klikkaa-ja-paikanna-indeksin tai asettelutietoisen poimijan rakentamiseen ilman, että pitää pudota julkisen API:n alapuolelle tai rakentaa tekstinpoimintaputkea uudelleen käsin
Nämä kyselyrajapinnat toimitetaan osana PDF Library for Delphi Delphi PDF Library -kirjastoa, yhdessä täyden tekstilohkojen poimintakerroksen kanssa, jonka päälle ne on rakennettu, sekä muun Delphille ja C++Builderille tarkoitetun lukupuolen itsetutkiskelupinnan kanssa