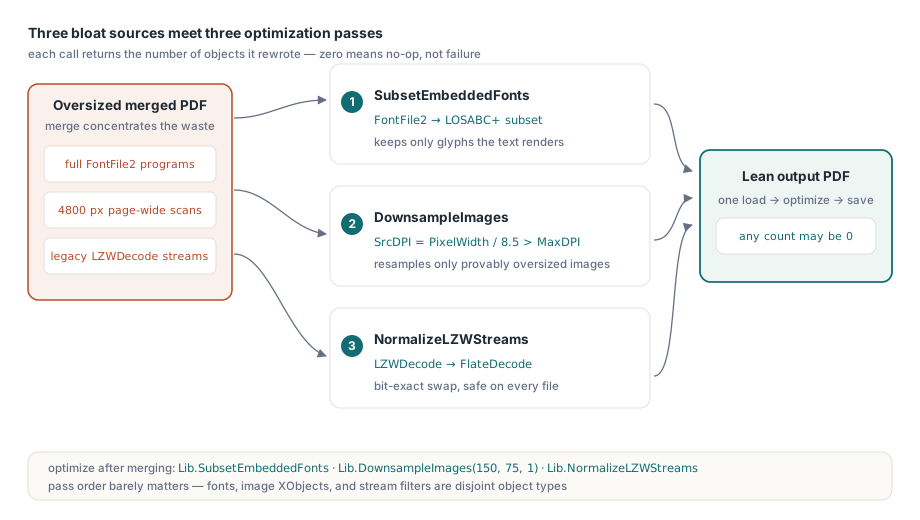
PDF-tiedoston koon pienentämiseen Delphissä losLab PDF Library tarjoaa kolme rajapintaa, jotka käyvät kolmen suurimman turvotuksen lähteen kimppuun: SubsetEmbeddedFonts kirjoittaa jokaisen upotetun TrueType-fonttiohjelman uudelleen niihin glyfeihin, jotka dokumentti todella piirtää, DownsampleImages uudelleennäytteistää rasterikuvat, jotka ylittävät tavoite-DPI:n, ja NormalizeLZWStreams korvaa vanhan LZWDecode-pakkauksen FlateDecodella. Kukin palauttaa muutettujen objektien määrän, joten nolla kertoo, että ajo oli tyhjä operaatio (no-op) eikä hiljainen epäonnistuminen
Miksi yhdistetty PDF-tiedostoni on suurempi kuin sen lähdetiedostot?
Yhdistetty tai ohjelmallisesti luotu PDF on yleensä ylisuuri yhdestä kolmesta syystä: täysin upotetut fontit, kuvat jotka on näytteistetty kauas näyttöresoluutionsa yläpuolelle, ja virrat (streams) jotka on yhä pakattu vanhalla LZW-suotimella. ISO 32000-1 §9.9 sallii tuottajan upottaa täydellisen fonttiohjelman, ja useimmat tuottajat tekevät juuri niin, koska se on turvallinen oletus. Täydellinen Arialin FontFile2 vie satoja kilotavuja; upota se tusinaan lähdetiedostoon, yhdistä ne, ja kannat mukanasi tusinaa kopiota glyfiääriviivoista merkeille, joita kukaan ei kirjoittanut. Yhdistäminen itsessään ei luo hukkaa, se vain tiivistää sen yhteen tiedostoon, jossa kokonaismäärä vihdoin tulee näkyviin
Kuvat ovat toinen syyllinen. Neljännessivun kehykseen sijoitettu 4800 pikseliä leveä skannaus kuljettaa noin 40 kertaa enemmän pikselidataa kuin 300 DPI:n painoputki pystyy käyttämään. Kolmas on hiljaisempi: LZWDecode-suotimella suodatetut virrat. ISO 32000-1 §7.4.4 määrittelee sekä LZWDecoden että FlateDecoden ja huomauttaa, että Flate pakkaa yleensä vähintään yhtä hyvin; käytännössä Flaten tuloste on samalla datalla johdonmukaisesti pienempi, ja LZW elää lähinnä tiedostoissa, jotka ovat jossain vaiheessa historiaansa kulkeneet 1990-luvun työkalujen läpi. Tämän artikkelin loppuosa käy läpi ne kolme losLab PDF Libraryn ajoa, jotka korjaavat kunkin ongelman, ja yhdistää ne sitten yhdeksi liukuhihnaksi
Fonttien osajoukotus SubsetEmbeddedFonts-metodilla
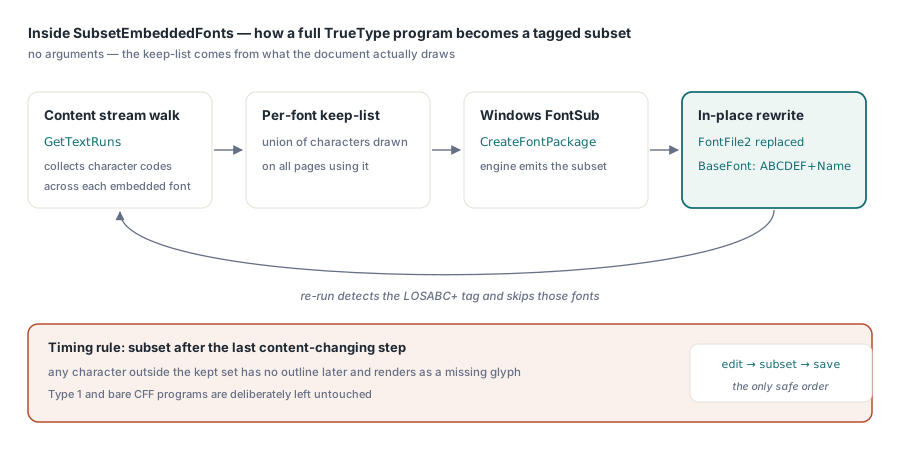
SubsetEmbeddedFonts kutistaa jokaisen ladatun dokumentin upotetun TrueType-fontin niihin merkkeihin, joita dokumentti todella käyttää, eikä se tarvitse argumentteja, koska se johtaa säilytettävien merkkien listan (keep-list) suoraan sisältövirroista. Sisäisesti ajo kävelee jokaisen sivun sisältövirran läpi GetTextRuns-metodilla, kerää kunkin fonttiresurssin alla viitatut merkkikoodit, rakentaa säilytyslistan ja luovuttaa alkuperäisen fonttiohjelman Windowsin FontSub-moottorille (CreateFontPackage) osajoukon tuottamiseksi. Uudelleenkirjoitettu ohjelma korvaa FontFile2-virran paikallaan, ja BaseFont-nimi saa LOSABC+-tunnisteen, eli sen kuuden ison kirjaimen ja plusmerkin käytännön, jonka ISO 32000-1 §9.6.4 määrittelee osajoukotetuille fonteille. Juuri tuo etuliite tekee kutsusta idempotentin: aja ajo kahdesti, ja jo osajoukotetut fontit tunnistetaan ja ohitetaan, joten sen kytkeminen eräajoon, joka saattaa käydä tiedostoissa uudelleen, on turvallista
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = uudelleenkirjoitettujen FontFile2-ohjelmien määrä;
      // 0 tarkoittaa, ettei mitään ole upotettu tai kaikki on jo osajoukotettu
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Kaksi toteutusyksityiskohtaa kannattaa tietää, koska ne selittävät rajapinnan rajat. Ensinnäkin ajo kohdistuu FontFile2-virtaan, joten se kattaa upotetut TrueType-ohjelmat; Type 1 -muodossa tai paljaana CFF:nä upotetut fontit jätetään koskematta eikä niillä riskeerata. Toiseksi se nojaa FontSubiin, mikä tekee SubsetEmbeddedFonts-metodista vain Windowsissa toimivan. Hienovaraisempi seikka toteutuksesta: se, kelpaako fontti, ratkaistaan purkamalla FontDescriptor → FontFile2 -viiteketju oikeasti, ei luottamalla upotuslipun heuristiikkaan, koska ladatun dokumentin fontit eivät koskaan käyneet läpi sitä luontipuolen kirjanpitoa, joka tuollaiset liput asettaa. Jos ratkaistu virta on olemassa, fontti on ehdokas; jos ei, se ohitetaan ilman virhettä
Rehellinen kompromissi: osajoukkofontti sisältää vain ne glyfit, jotka olivat läsnä osajoukotushetkellä. Jos myöhempi työkalu tai oma koodisi lisää myöhemmin tekstiä samalla fontilla, jokaiselta osajoukon ulkopuoliselta merkiltä puuttuu ääriviiva ja se piirtyy puuttuvana glyfinä. Osajoukota viimeisenä sisältöä muuttavana vaiheena, älä koskaan ennen muokkausvaihetta. Sama varoitus pätee, jos aiot vetää fontin myöhemmin ulos uudelleenkäyttöä varten; artikkeli tekstin, kuvien ja fonttien poiminta PDF Library for Delphillä kertoo, mitä poimittu osajoukko-ohjelma voi ja ei voi antaa sinulle
Miten DownsampleImages päättää, mitkä kuvat kutistetaan?
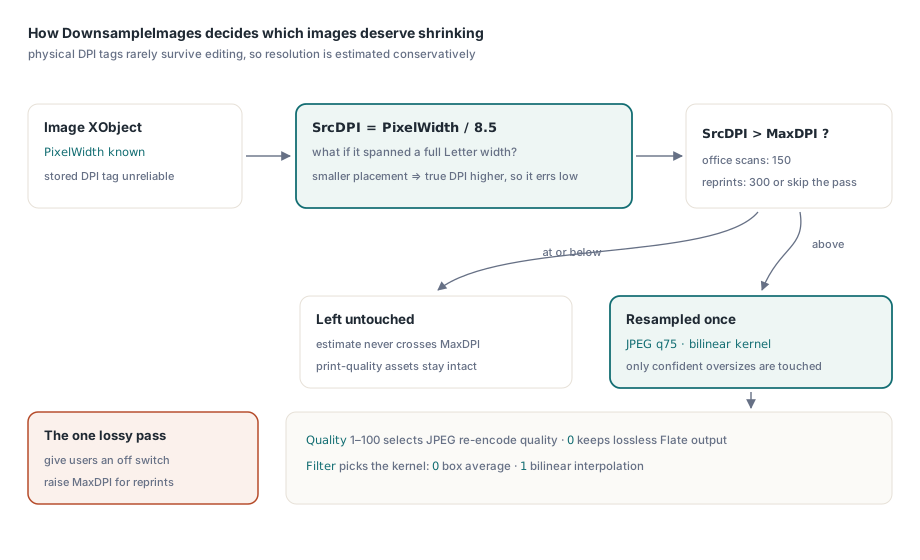
DownsampleImages(MaxDPI, Quality, Filter) uudelleennäytteistää vain ne kuvat, joita se voi luottavaisesti kutsua ylinäytteistetyiksi, käyttäen tarkoituksella varovaista DPI-arviota. PDF:n kuva-XObject tallentaa pikselimitat mutta ei luotettavaa fyysistä resoluutiota, ja lähdekuvan DPI-merkintä harvoin selviää lataa-muokkaa-tallenna-kierroksesta. Niinpä ajo arvioi SrcDPI = PixelWidth / 8.5 eli kysyy käytännössä: jos tämä kuva kattaisi Letter-sivun koko leveyden, mikä sen resoluutio olisi? Vain kuviin, joiden arvio ylittää MaxDPI-arvon, kosketaan. Vinouma on tarkoituksellinen: pienenä sivulle sijoitetun kuvan todellinen DPI on arviota korkeampi, joten ajo laukeaa mieluummin liian harvoin kuin heikentää painolaatuista aineistoa, jota se ei pysty mittaamaan
Quality väliltä 1-100 valitsee JPEG-uudelleenkoodauksen laadun, kun taas 0 pitää tulosteen häviöttömänä PNG-tyylisenä Flatena; Filter valitsee uudelleennäytteistyksen ytimen (kernel), 0 laatikkokeskiarvolle ja 1 bilineaariselle. Skannatulle toimistopaperille DownsampleImages(150, 75, 1) on järkevä lähtökohta; kaikelle, mikä saatetaan tulostaa uudelleen, nosta MaxDPI-arvo 300:aan tai ohita ajo kokonaan. Alinäytteistys on kolmesta ainoa häviöllinen vaihe, joten se kuuluu asetuksen taakse, jonka käyttäjäsi voivat kytkeä pois
Vanhojen LZW-virtojen muunto NormalizeLZWStreams-metodilla
NormalizeLZWStreams on ilmainen voitto: se purkaa häviöttömästi jokaisen LZWDecode-virran ja pakkaa sen uudelleen FlateDecodella paikallaan, palauttaen muunnettujen virtojen määrän. Se käsittelee sekä yksittäisen /Filter /LZWDecode -merkinnän että suodinketjun taulukossa esiintyvän LZW:n, jolloin vain LZW-lenkki korvataan ja muu ketju säilytetään. Ennustinparametrit (Predictor, Columns, Colors, BitsPerComponent) luetaan virran DecodeParms-merkinnästä ja välitetään purkajalle, joten ennustinkoodattu kuvadata kulkee edestakaisen matkan oikein. Koska molemmat suotimet ovat bittitarkkoja koodekkeja, puretut tavut ovat identtiset ennen ja jälkeen; vain säiliön pakkaus muuttuu, minkä vuoksi tämä ajo on turvallista suorittaa ehdoitta jokaiselle tiedostolle
Dokumentilla, jossa ei ole LZW-virtoja, kutsu palauttaa yksinkertaisesti 0 eikä koske mihinkään, mitä kirjaston regressiotestit harjoittavat eksplisiittisesti: tuoreena luodun, pelkkää Flatea sisältävän tiedoston on raportoitava nolla muunnosta. Tuo tyhjän operaation takuu merkitsee silloin, kun ajo istuu liukuhihnassa, joka käsittelee tuhansia keskenään erilaisia tiedostoja, joista osa on vuodelta 2024 ja osa vuodelta 1998
Täydellinen koon optimoinnin liukuhihna Delphissä
Kolme ajoa yhdistyvät yhdeksi lataa-optimoi-tallenna-funktioksi, ja järjestyksellä on vähemmän väliä kuin luulisi, koska ne toimivat erillisillä objektityypeillä: fontit, kuva-XObjectit ja virtasuotimet. Osajoukotuksen ajaminen ensin on silti siisti valinta, koska se on se ajo, jolla on muokkausjärjestystä koskeva rajoite
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> osajoukko
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineaarinen
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Kirjaa Fonts/Images/Streams: kolme nollaa tarkoittaa jo kevyttä tiedostoa
  finally
    Lib.Free;
  end;
end;
Todenna liukuhihna samalla tavalla kuin kirjasto todentaa itsensä: edestakaisella matkalla. Version v3.130 regressiotestit luovat dokumentin, tallentavat sen, lataavat sen uudelleen, ajavat optimoinnin, tallentavat uudelleen ja väittävät sitten kolme asiaa: tuloste on pienempi, palautetut määrät vastaavat odotuksia, ja optimoidun tiedoston uudelleenlataus jäsentyy ja piirtyy yhä. Tuon luo-optimoi-lataa-silmukan toistaminen omien tuotantotiedostojesi otokselle ja poimitun tekstin vertaaminen ennen ja jälkeen on tunnin investointi, joka nappaa integrointivirheet kauan ennen kuin asiakas avaa rikkinäisen laskun
// Edestakainen tarkistus: optimoidun tiedoston on yhä latauduttava puhtaasti
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Mihin liukuhihna sopii yhdistämistyönkulussa? Yhdistämisen jälkeen, ei sen aikana. Ensin yhdistäminen ja sitten yksittäisen tuloksen optimointi tarkoittaa, että kukin upotettu fontti osajoukotetaan kerran kaikkien käytettyjen merkkien yhdisteestä lähdetiedostokohtaisen työn sijaan. Jos yhdistämisen läpimeno on pullonkaula, PDF Library for Delphi tarjoaa tavutason nopean reitin, joka välttää täyden objektien jäsennyksen ja jota kuvataan artikkelissa nopeasta PDF-yhdistämisestä tavuviitteiden siirrolla; ja syötteille, jotka ovat liian suuria pidettäväksi kokonaan muistissa, suoran pääsyn yhdistäminen ja jakaminen suurille PDF-tiedostoille kattaa suoratoistoreitin. Molemmat sopivat luontevasti yhteen yhdistetyn tulosteen loppuoptimointiajon kanssa
Mitä kolme ajoa eivät tee
losLab PDF Libraryn optimointikolmikko sulkee tarkoituksella pois kaiken, mikä muuttaa dokumentin semantiikkaa. SubsetEmbeddedFonts ei yhdistä yhdistettyjen lähteiden päällekkäisiä fontteja yhdeksi ohjelmaksi, vaan kutistaa kunkin itsenäisesti; kaksoiskappaleiden poisto on eri ja riskialttiimpi muunnos. DownsampleImages ohittaa kuvan, jonka varovainen DPI-arvio jää kynnyksen alle, vaikka ihminen näkisi sen olevan ylisuuri kehykseensä nähden. Eikä yksikään ajo koske dokumentin rakenteeseen, joten tuhansien orpojen objektien turvottama tiedosto tarvitsee uudelleenkirjoittavan tallennuksen näiden virtatason ajojen sijaan. Noiden rajojen sisällä fonttien osajoukotuksen, kuvien alinäytteistyksen ja LZW-Flate-normalisoinnin yhdistelmä poistaa PDF-turvotuksen kolme klassista lähdettä yhdellä ennustettavalla API-kutsulla kutakin kohti. Nämä kolme funktiota toimitetaan osana losLab PDF Librarya Delphille, C#:lle ja VB.NETille, edellä käsiteltyjen yhdistämis-, poiminta- ja renderöintirajapintojen rinnalla