HotPDF یعنی Tesseract را داخل فرایند Delphi تو از طریق HPDFCreateTesseractDLLOCREngine اجرا میکند، یک factory که در v2.772.0 اضافه شد و یک DLL سازگار با Tesseract 5 را بهشکل پویا load میکند، C API اش را میراند (TessBaseAPIInit2 و TessBaseAPIRecognize و result iterator) و یک IHPDFOCREngine برمیگرداند. THotPDF.ApplyLoadedOCRTextLayer از آن موتور برای اضافه کردن یک لایهٔ متنی Unicode نامرئی و قابلجستوجو به صفحات PDF اسکنشده استفاده میکند
همان بازشناس از قبل از طریق آداپتور بیرونی tesseract.exe که یک BMP مینویسد و TSV را parse میکند در دسترس بود. آن مسیر کار میکند اما هر صفحه هزینهٔ راهاندازی یک فرایند و یک فایل بیتمپ موقت و یک فرمت متنی بدون baseline و بدون کنترل صفحهبندی را میدهد. صدا زدن DLL هر سه را حذف میکند. دیوار فرایند را هم حذف میکند، یعنی یک binding در Pascal مستقیم روی ساختارهای C و بولینهای C و رشتههای تخصیصیافته در C مینشیند. بیشتر آنچه دربارهٔ این آداپتور ارزش دانستن دارد این است که آن binding کجا میتواند بیسروصدا اشتباه برود
با HotPDF چطور Tesseract را درونفرایندی از Delphi اجرا میکنی؟
اجرای Tesseract درونفرایندی با HotPDF یک فراخوانی factory در یونیت HPDFTesseractRecognition و همان فراخوانی ApplyLoadedOCRTextLayer میخواهد که هر موتور OCR در HotPDF استفاده میکند. factory مشتاقانه اعتبارسنجی میکند. فایل DLL و پوشهٔ tessdata باید موجود باشند، شناسهٔ زبان فقط میتواند حروف ASCII و ارقام و _ و + داشته باشد، هر مدل در ترکیبی مثل chi_sim+eng باید یک فایل .traineddata منطبق داشته باشد، و هر 21 export الزامی باید قبل از برگرداندن موتور حل شوند. اشتباهات پیکربندی EArgumentException بالا میدهند؛ یک DLL که load نشود EOSError با کد خطای Windows و یک سرنخ برای چک کردن معماری و وابستگیها بالا میدهد
uses
SysUtils, HPDFDoc, HPDFTesseractRecognition;
procedure MakeSearchable(const SourceFile, TargetFile: string);
var
Doc: THotPDF;
Engine: IHPDFOCREngine;
Options: THPDFOCRTextLayerOptions;
Info: THPDFOCRTextLayerInfo;
begin
// یک اپ Win64 به یک DLL یعنی 64 بیتی نیاز دارد؛ DLLهای وابستگی کنارش میروند
Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
'C:\OCR\tessdata', 'chi_sim+eng'); // THPDFTesseractOptions.Default
Doc := THotPDF.Create(nil);
try
Doc.AutoLaunch := False;
if Doc.LoadFromFile(SourceFile) < 1 then
raise Exception.Create('Cannot load ' + SourceFile);
Options := THPDFOCRTextLayerOptions.Default; // 300 DPI، MinimumConfidence برابر 0.5
// یک فهرست صفحهٔ خالی یعنی همهٔ صفحات؛ صفحاتی که از قبل متن دارند skip میشوند
if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
raise Exception.Create(string(Info.Diagnostic));
Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
' words accepted, ', Info.DroppedWordCount, ' dropped');
Doc.SaveLoadedDocument(TargetFile);
finally
Doc.Free;
end;
end;THPDFTesseractOptions.Default مقدار PageSegMode را روی tpsAuto و EngineMode را روی temDefault و TimeoutMilliseconds را روی 60,000 و MaxPixels را روی 16,777,216 میگذارد. بودجهٔ پیکسل بیشتر از ظاهرش مهم است. یک صفحهٔ US Letter در 300 DPI پیشفرض به 2,550 × 3,300 پیکسل یعنی حدود 8.4 میلیون رندر میشود که جا میشود. همان صفحه در 600 DPI یعنی 5,100 × 6,600، حدود 33.7 میلیون، و آداپتور قبل از اینکه Tesseract یک پیکسل ببیند ردش میکند. MaxPixels را بالا ببر (سقفش 67,108,864 است) یا DPI را سر جای نگه دار؛ هر بعت هم به 32,767 پیکسل کپ میشود
DLL با LoadLibraryEx با فلگهای جستوجو برای پوشهٔ خود DLL بهعلاوهٔ دایرکتوریهای امن پیشفرض load میشود، پس کتابخانههای تصویری که Tesseract به آنها وابسته است میتوانند کنارش زندگی کنند بدون دست زدن به PATH یا پوشهٔ فعلی. HotPDF هیچ runtime یا مدل OCR ای را باندل یا دانلود نمیکند؛ هر دو را تو فراهم میکنی
در مقایسه با آداپتور tesseract.exe چه چیزی عوض میشود؟
آداپتور DLL جداسازی فرایند را با خروجی غنیتر و سربار کمتر بهازای هر صفحه معامله میکند. هر دو آداپتور به همان خط لولهٔ لایهٔ متنی وصل میشوند، پس نگاشت مختصات و فیلتر اطمینان و ثبت همه-یا-هیچ یکساناند؛ چیزی که فرق میکند این است که پیکسلها چطور وارد و کلمات چطور خارج میشوند
| جنبه | آداپتور tesseract.exe | آداپتور DLL یعنی Tesseract |
|---|---|---|
| Factory | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| پیکسلهای ورودی | فایل BMP در یک پوشهٔ موقت خصوصی | بافر خاکستری 8 بیتی در حافظه |
| کلمات خروجی | TSV سطح-کلمه، سقف 64 مگابایت | result iterator، UTF-8 بهازای هر کلمه |
| baselineها | در دسترس نیست | از TessPageIteratorBaseline عبور داده میشوند |
| صفحهبندی و حالت موتور | فقط صفحهبندی خودکار | THPDFTesseractPageSegMode، THPDFTesseractEngineMode |
| تایماوت | سخت: فرایند فرزند خاتمه میشود | مشارکتی: باید Tesseract متوجه شود |
| جداسازی crash و حافظه | فرایند جدا | هیچ، فضای آدرس تو را شریک میشود |
یک هزینه ناپدید نمیشود. هر فراخوانی Recognize یک instance API خودش را میسازد و TessBaseAPIInit2 را صدا میزند، پس مدلهای زبانی بهازای هر صفحه مقداردهی میشوند نه یک بار بهازای هر موتور. کش فایل سیستمعامل reload را نرم میکند اما روی مجموعههای مدل چندزبانهٔ بزرگ همچنان هزینهٔ ثابت غالب بهازای هر صفحه است و ضربالاجل بازشناسی را مصرف میکند. موتور DLL یعنی RapidOCR درونفرایندی طراحی معکوس میگیرد و مدلهای ONNX اش را برای عمر موتور مقیم نگه میدارد؛ مشکلات مرزی (C ABI و بافرهای قرضی و کار بومی غیرقابلوقفه) از یک خانوادهاند
چرا Delphi نمیتواند ساختار مانیتور یعنی Tesseract را کپی کند؟
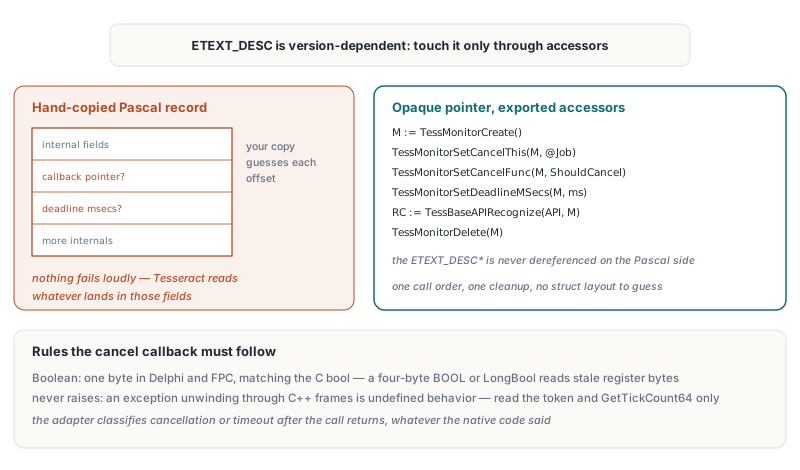
Delphi نمیتواند مانیتور پیشرفت یعنی Tesseract را بهطور امن آینه کند چون ETEXT_DESC فیلدهای داخلی وابسته به نسخه دارد، پس یک رکورد کپیدستی callback لغو و ضربالاجل را روی بعضی بیلدها در آفستهای اشتباه میگذارد. وقتی آن میشود هیچ چیز بلند شکست نمیخورد. Tesseract بهسادگی اشارهگر callback تو را از فیلدی میخواند که حالا چیز دیگری دارد، یا اصلاً ضربالاجل را نمیبیند
برای همین HotPDF مانیتور را بهشکل یک اشارهگر مات تلقی میکند و فقط از طریق توابع صادرشده به آن دست میزند: TessMonitorCreate و TessMonitorSetCancelThis و TessMonitorSetCancelFunc و TessMonitorSetDeadlineMSecs و TessMonitorDelete. اگر C API را خودت برای هدف دیگری bind میکنی همین الگو صدق میکند. طرح زیر کد binding خودت است، نه API یعنی HotPDF، و declareهایی را که HotPDF داخلاً استفاده میکند آینه میکند
type
// C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
TTessMonitorCreate = function: Pointer; cdecl; // ETEXT_DESC*، هرگز dereference نمیشود
TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;
TOCRJob = record
CancelRequested: Boolean;
DeadlineTick: UInt64;
end;
POCRJob = ^TOCRJob;
function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
// روی پشتهٔ Tesseract اجرا میشود: فلگها و ساعت را بخوان، هرگز raise نکن
Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
(GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;
// استفاده، با اشارهگرهای تابعی که GetProcAddress حل کرده:
// Monitor := MonitorCreate();
// try
// MonitorSetCancelThis(Monitor, @Job);
// MonitorSetCancelFunc(Monitor, ShouldCancel);
// MonitorSetDeadlineMSecs(Monitor, RemainingMs);
// RC := BaseAPIRecognize(API, Monitor);
// finally
// MonitorDelete(Monitor);
// end;دو جزئیات در آن طرح عمدیاند. callback یک Boolean برمیگرداند که در هر دو Delphi و Free Pascal یک بایتی است، منطبق با bool یعنی C در TessCancelFunc. BOOL چهاربایتی Windows یا LongBool یعنی Delphi قابلجایگزین به نظر میرسد و نیست: وقتی یک سمت یک بایت تکی مینویسد و سمت دیگر چهار تا میخواند، بایتهای بالای ثبات بازگشت هر چیزی بوده که آنجا مانده بود و یک false میتواند بهشکل true برسد. همان هدر کار را پیچیدهتر میکند، چون توابعی مثل TessPageIteratorBoundingBox یک int برمیگردانند که HotPDF بهشکل Integer declare میکند. نوع C هر مقدار بازگشتی را بخوان بهجای اینکه برای کل API یک قرارداد را فرض کنی
جزئیات دوم این است که callback هرگز raise نمیکند. یک exception یعنی Delphi که از فریمهای C++ یعنی Tesseract باز شود رفتار تعریفنشده است، پس callback یعنی HotPDF فقط توکن لغو و یک مقدار یکنوای GetTickCount64 را میخواند. آداپتور بعد از برگشتن TessBaseAPIRecognize نتیجه را به یک تشخیص لغو یا تایماوت تبدیل میکند و آن چک را فارغ از کد بازگشت بومی انجام میدهد
سمت Delphi مالک کدام اشارهگرهای بومی است؟
آداپتور DLL یعنی Tesseract در HotPDF بهازای هر درخواست مالک سه شیء بومی است، instance API و مانیتور و result iterator، و هر چیز دیگری را قرض میگیرد. هر فراخوانی Recognize مجموعه خودش را میسازد و در یک بلوک finally آزاد میکند: TessResultIteratorDelete، بعد TessMonitorDelete، بعد TessBaseAPIDelete. آزاد کردن interface موتور کتابخانه را بارگیری میکند
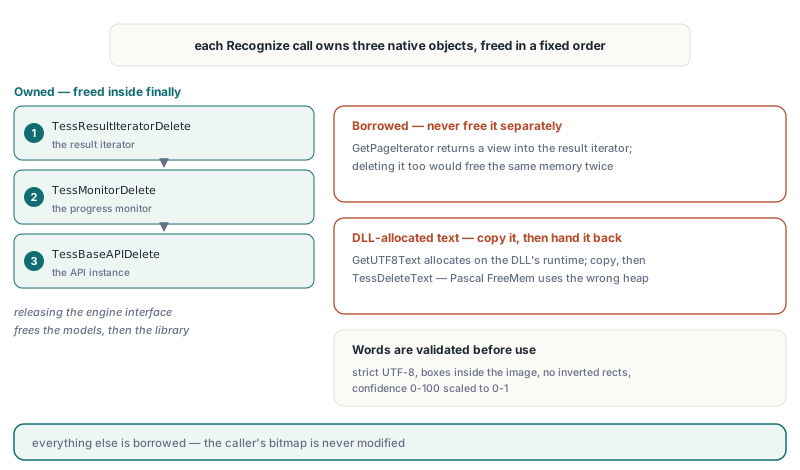
TessResultIteratorGetPageIteratorیک نمای قرضی داخل result iterator برمیگرداند نه یک شیء جدید. HotPDF از آن برایTessPageIteratorBoundingBoxوTessPageIteratorBaselineاستفاده میکند و هرگز آزادش نمیکند؛ حذف جداگانهاش همان حافظه را دو بار آزاد میکردTessResultIteratorGetUTF8Textرشتهای برمیگرداند که runtime خود DLL تخصیصش داده. HotPDF کپیاش میکند و از طریقTessDeleteTextدر یک بلوکfinallyپس میدهد؛ FreeMemیعنی Pascal آن را روی heap اشتباه آزاد میکرد- متن کلمه با اعتبارسنجی سختگیرانهٔ UTF-8 decode و قبل از تبدیل از نظر طول چک میشود. کلماتی با نویسههای کنترلی یا UTF-8 بدشکل یا جعبههای بیرون تصویر یا مستطیلهای وارونه یا اطمینان بیرون 0–100 درخواست را شکست میدهند بهجای اینکه بیصدا وصله شوند
- متن کل بهازای هر درخواست سقف 1,048,576 واحد کد یعنی UTF-16 دارد و شمارش کلمه باید در بودجهٔ درخواستی که
ApplyLoadedOCRTextLayerپایین میدهد جا شود
اطمینان بهشکل 0–100 میرسد و به 0–1 مقیاس میشود، پس THPDFOCRTextLayerOptions.MinimumConfidence برای هر موتور همان معنا را دارد. وقتی Tesseract یک baseline گزارش میکند هر دو نقطهٔ پایانی عبور داده میشوند؛ وگرنه خط لولهٔ لایهٔ متنی به تخمین هندسیاش برمیگردد، دقیقاً همانطور که برای ورودی TSV میکند
چرا یک enum را قبل از رسیدن به DLL اعتبارسنجی میکنی؟
HotPDF ترتیب خام PageSegMode و EngineMode را قبل از چک بازه داخل یک Integer کپی میکند، چون کامپایلر ممکن است فرض کند یک متغیر enum همیشه مقدار declareشده دارد و Ord(X) > Ord(High(T)) را به یک false ثابت فولد کند. آن ترتیبها تزئین نیستند: THPDFTesseractPageSegMode از شمارهگذاری صفحهبندی یعنی Tesseract از 0 تا 13 پیروی میکند، THPDFTesseractEngineMode از شمارهگذاری حالت موتور از 0 تا 3، و هر دو بهشکل اعداد صحیح خام به DLL میروند. یک رکورد آپشن که با FillChar ساخته شده یا از یک استریم پر شده یا با یک عدد صحیح cast شده از C++Builder رسیده میتواند بایتی مثل 200 حمل کند. اعتبارسنجی ترتیب کپیشده آن را در زمان factory به یک EArgumentException تبدیل میکند بهجای یک حالت تعریفنشده داخل کد بومی. factory tpsOSDOnly و tpsAutoOnly را هم رد میکند که هیچ کلمهای تولید نمیکنند و برای tpsAutoOSD و tpsSparseTextOSD یک osd.traineddata میخواهد
تایماوت بازشناسی در واقع چه چیزی را تضمین میکند؟
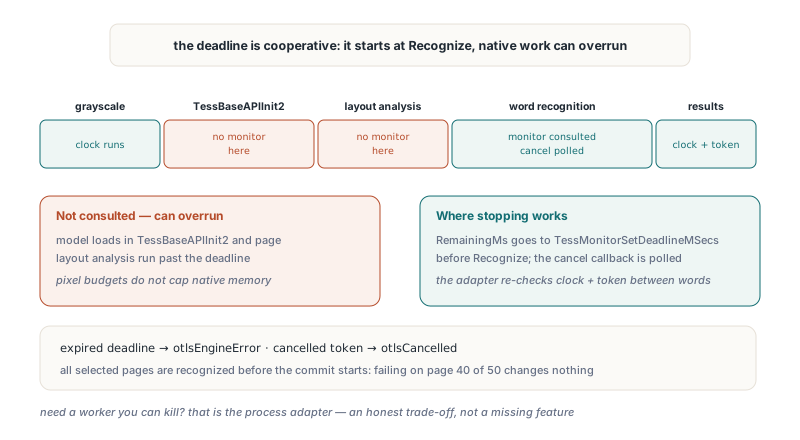
تایماوت DLL یعنی Tesseract مشارکتی است: HotPDF میتواند کار خودش را متوقف و از Tesseract بخواهد بایستد اما نمیتواند کد بومی را مجبور به برگشتن کند. ساعت وقتی Recognize شروع میشود راه میافتد، پس تبدیل بیتمپ و مقداردهی مدل همان بودجهٔ بازشناسی را مصرف میکنند. HotPDF زمان سپریشده و توکن لغو را در حین تبدیل خاکستری و بین کلمات هنگام پیمایش نتایج چک میکند و میلیثانیههای باقیمانده را قبل از صدا زدن TessBaseAPIRecognize به TessMonitorSetDeadlineMSecs میدهد
شکاف داخل فراخوانی بومی است. مانیتور یعنی Tesseract حین بازشناسی کلمه مشورت میشود، نه حین TessBaseAPIInit2 یا تحلیل چیدمان صفحه، پس یک load کند مدل یا یک چیدمان پاتولوژیک میتواند قبل از گزارش تایماوت از ضربالاجل عبور کند. بودجههای پیکسل و خروجی هم مصرف حافظهٔ خود کتابخانهٔ بومی را کپ نمیکنند. اگر worker ای لازم داری که بتوان کشتش، از آداپتور فرایندی استفاده کن؛ آن معاملهٔ صادقانه است، نه یک قابلیت جاافتاده
صفحهبندی جایی است که آداپتور DLL روی ورودی دشوار ارزش خودش را نشان میدهد. فرمها و برچسبها و جدولهای اسکنشده با فیلدهای پراکنده اغلب با tpsSparseText بهتر از صفحهبندی خودکار بازشناسی میشوند، که سعی میکند ستونها و پاراگرافهایی را مونتاژ کند که وجود ندارند
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
Engine: IHPDFOCREngine;
TessOptions: THPDFTesseractOptions;
LayerOptions: THPDFOCRTextLayerOptions;
Info: THPDFOCRTextLayerInfo;
begin
TessOptions := THPDFTesseractOptions.Default;
TessOptions.PageSegMode := tpsSparseText; // فیلدهای پراکنده، بدون مونتاژ ستون
TessOptions.EngineMode := temLSTMOnly; // مدلهای LSTM در tessdata لازم است
TessOptions.TimeoutMilliseconds := 20000; // شامل مقداردهی مدل
Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
'C:\OCR\tessdata', 'eng+deu', TessOptions);
LayerOptions := THPDFOCRTextLayerOptions.Default;
LayerOptions.MinimumConfidence := 0.6;
if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
case Info.Status of
otlsCancelled:
Writeln('OCR cancelled, document unchanged');
otlsEngineError:
Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
else
Writeln(string(Info.Diagnostic));
end;
end;یک تایماوت بهشکل otlsEngineError با تشخیص Tesseract DLL OCR timed out خودش را نشان میدهد و توکن لغوشده بهشکل otlsCancelled. در هر دو حالت ApplyLoadedOCRTextLayer قبل از شروع تراکنش ثبت، همهٔ صفحات انتخابشده را بازشناسی کرده، پس شکست در صفحهٔ 40 از 50 سند بارگذاریشده را دقیقاً همانطور که بود باقی میگذارد. توجه کن tpsSingleLine و tpsSingleBlock و tpsSparseText فقط صفحهبندی را عوض میکنند؛ هیچکدام یک اسکن کج را صاف نمیکنند
Free Pascal و Lazarus: پیکسلهای کهنه و چینیِ گمشده
هر دو factory یعنی Tesseract از v2.772.1 در بیلدهای Win32 و Win64 یعنی Free Pascal و Lazarus در Windows کار میکنند، بعد از دو فیکس مخصوص FPC. اول بستهٔ Lazarus را برای معماری هدف دوباره بیلد کن؛ port عمومی در HotPDF روی Free Pascal و Lazarus Win64 پوشش داده شده
فیکس اول مربوط به پیکسلهاست. یک TBitmap یعنی LCL که از طریق scanlineها نوشته میشود میتواند تصویر خامش را بدون تازهسازی handle بیتمپ Windows بهروز کند، پس GetDIBits روی آن handle پیکسلهای قدیمی را برمیگرداند. علامت گیجکننده بود: متنی که مستقیم روی یک بیتمپ کشیده شده بود بازشناسی میشد، در حالی که صفحهای که توسط renderer PDF یعنی HotPDF رندر شده بود یک فهرست کلمهٔ خالی تولید میکرد. روی FPC آداپتور حالا یک snapshot حساس-به-فرمت از طریق CreateIntfImage میخواند که فرمت پیکسل و ترتیب ردیف تصویر خام را محترم میشمارد. بیلد Delphi مسیر GetDIBits را روی یک کپی خصوصی 24 بیتی نگه میدارد. هیچکدام از دو بیلد بیتمپ فراخواننده را تغییر نمیدهند
فیکس دوم مال آداپتور یعنی tesseract.exe است. TStringList یعنی FPC رشتههای ANSI ذخیره میکند، پس منتسب کردن متن TSV یعنی UTF-8 decodeشده به Lines.Text بیسروصدا هر نویسهٔ چینی یا صفحهٔ مکملی را که code page ANSI سیستم نمیتوانست نشان بدهد میانداخت. مسیر FPC حالا TSV را بهشکل بایتهای UTF-8 نگه میدارد، BOM را در سطح بایت میتراشد و هر کلمه را جداگانه به UnicodeString decode میکند. آداپتور DLL هرگز این مشکل را نداشت چون هر کلمه را مستقیم از iterator decode میکند
مرجع سریع
- factory:
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])درHPDFTesseractRecognition، اضافهشده در v2.772.0، پشتیبانی FPC در v2.772.1 - پیشفرضها:
tpsAutoوtemDefaultو 60,000 میلیثانیه و 16,777,216 پیکسل؛ بازهٔ تایماوت 1 تا 3,600,000 میلیثانیه، سقف پیکسل 67,108,864 - bitness یعنی DLL را با برنامه بخوان و DLLهای وابستگی را کنار DLL یعنی Tesseract بگذار
- مانیتور را مات تلقی کن؛ هرگز
ETEXT_DESCرا داخل یک رکورد Pascal کپی نکن - callback لغو را
cdeclبا نتیجهٔBooleanیکبایتی declare کن و هرگز نگذار یک exception از آن فرار کند - متن iterator را با
TessDeleteTextآزاد کن؛ page iterator ای که از result iterator گرفتی را هرگز آزاد نکن - انتظار ضربالاجل مشارکتی را داشته باش: مقداردهی مدل و تحلیل چیدمان میتوانند از آن عبور کنند
- وقتی خاتمه سخت یا جداسازی crash لازم داری از آداپتور یعنی tesseract.exe استفاده کن
آداپتور DLL یعنی Tesseract و آداپتورهای فرایندی و موتور OCR داخلی همه با کامپوننت HotPDF Delphi PDF برای Delphi و C++Builder و Free Pascal عرضه میشوند؛ برای ویرایشها و دانلودها صفحهٔ محصول HotPDF را ببین