کامپوننت HotPDF Delphi میتواند متن درون یک PDF موجود را از دلفی و C++Builder جستوجو و جایگزین کند. SearchLoadedPageText و SearchLoadedDocumentText هر رخداد یک رشته را با دقت سطح گلیف مییابند، و ReplaceLoadedPageText و ReplaceLoadedDocumentText بایتهای منطبق را در جا بازنویسی میکنند — به شرطی که هر کاراکتر جایگزین بتواند از راه قلم اصلی دوباره کدگذاری شود، محدودیتی فیزیکی که این مقاله بهجای پنهانکردنش در پانوشت، صادقانه با آن روبهرو میشود
درخواستی که پشت این قابلیت است همیشه پیشپاافتاده است. شرکتی نامش را عوض میکند و سه هزار فاکتور بایگانیشده هنوز نام قدیمی را دارند. قالب قراردادی با تاریخ انقضای سال گذشته منتشر شده است. کد یک محصول بازنشسته شده و هر برگه مشخصات که نامش را میبرد باید کد جانشین را داشته باشد. در یک واژهپرداز هرکدام از اینها کاری سیثانیهای است. در یک PDF مسئلهای واقعاً دشوار است، و فهمیدن چراییاش تفاوت میان استفاده درست از API و ثبت گزارش باگی است که در واقع نقل یک بند استاندارد است
چرا جایگزینی متن در یک PDF اینقدر سخت است؟
جایگزینی متن در PDF سخت است چون صفحه PDF متن قابل ویرایش ندارد — گلیفهای جانماییشده دارد. زیر مدل نمایش متن در ISO 32000-1 §9.4، یک جریان محتوا عملگرهایی مانند Tj و TJ را میراند که دنبالههایی از کدهای کاراکتر را در مختصاتی که ماتریس متن تعیین کرده نقاشی میکنند. آن کدها یونیکد نیستند؛ اندیسهایی در هر کدگذاریای هستند که قلم صفحه اعلام کرده، و نگاشت برگشتی به کاراکترهای خوانا ممکن است در یک CMap از نوع /ToUnicode، یک آرایه تفاوت کدگذاری، یا یک زنجیره نگاشت CID زندگی کند. نه شیء پاراگرافی هست، نه جریان متنی، و نه هیچ تضمینی که یک واژه دیداری اصلاً بهصورت یک رشته ذخیره شده باشد
جایگزینی روی رمزگشایی یک لایه دشواری دیگر میافزاید: باید دقیقاً بدانید کدام بایتهای جریان اصلی هر گلیف را تولید کردهاند تا بتوانید بایتهای تازه را درست در همان بازه و نه جای دیگری بچسبانید. یک استخراجکننده متن میتواند پس از بیرونکشیدن یونیکد، موقعیت بایتها را دور بریزد. یک جایگزینکننده نمیتواند. به همین دلیل HotPDF کار را میان دو انتشار تقسیم کرد — v2.251.0 لایه ردیابی افست و جستوجو را ساخت، و v2.252.0 لایه بازنویسی را روی آن
یافتن متن: جستوجوی سطح گلیف با ردیابی افست بایت
تابع SearchLoadedDocumentText در HotPDF هر رخداد یک عبارت را با تطبیق در برابر دنباله گلیف یونیکد رمزگشاییشده هر صفحه مییابد، نه در برابر بایتهای خام جریان، پس یک تطبیق تطبیق است، فارغ از اینکه قلم چطور کدگذاریاش کرده باشد. زیرساخت زیرین در v2.251.0 معرفی شد: نشانهگذار جریان محتوا برای هر عملوند رشتهای یک بازه بایتی StartOfs/EndOfs ثبت میکند — شامل جداکنندههای ( ) یا < > آن — و هر گلیف رمزگشاییشده یک سهتایی TokenIndex/ItemIndex/ByteOffset با خود دارد که به عملوند، قلم آرایه TJ و واحد کد دقیقی که تولیدش کرده اشاره میکند. همان مفسر گلیف، رابط استخراجی را هم میراند که در استخراج متن از یک PDF بارگذاریشده در دلفی شرح داده شده؛ جستوجو صرفاً همان اصلونسبی را نگه میدارد که استخراج دور میریزد
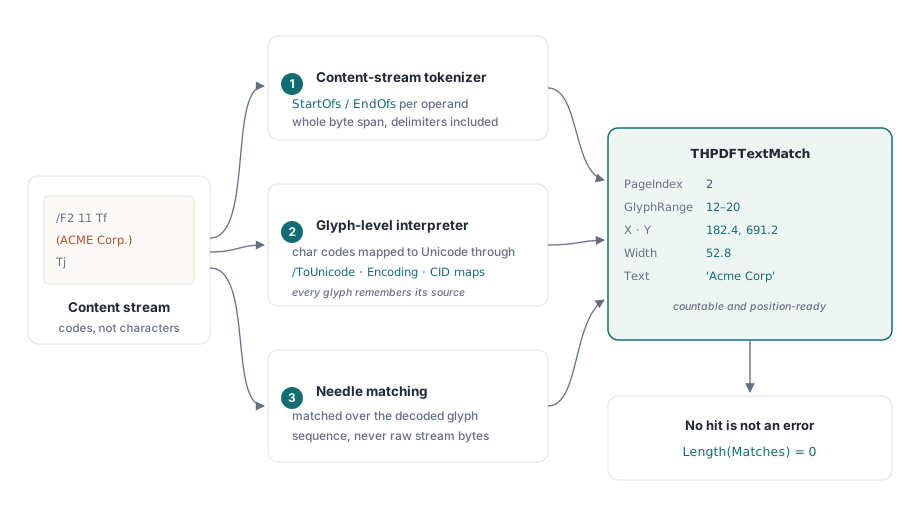
هر تطبیق بهصورت یک رکورد THPDFTextMatch برمیگردد که اندیس صفحه، بازه شامل گلیفها، مبدأ X/Y در فضای کاربر و عرض تطبیق، اندیس نشانه و قلم مبدأ، و خود متن تطبیقیافته را حمل میکند. همین برای راندن یک روکش برجستهسازی، یک رابط بازبینی، یا گام جایگزینی کافی است. جستوجویی که چیزی نیابد بهجای شکست یک آرایه خالی برمیگرداند، پس الگوی فراخوانی ساده میماند
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
    begin
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to Length(Matches) - 1 do
          WriteLn(Format('page %d at (%.1f, %.1f): "%s"',
            [Matches[I].PageIndex, Matches[I].X, Matches[I].Y,
             Matches[I].Text]));
    end;
  finally
    Pdf.Free;
  end;
end;
یک انتخاب طراحی عامدانه ارزش یادداشت دارد. وقتی CaseSensitive برابر False است، مقایسه فقط برای کاراکترهای ASCII بزرگی و کوچکی حروف را نادیده میگیرد، و این عمدی است: تاکردن کامل حالت حروف در یونیکد در زنجیره ابزارهای دلفی 5 تا XE که HotPDF پشتیبانی میکند رفتار متفاوتی دارد، و رابطی که بسته به اینکه کدام کامپایلر برنامه شما را ساخته تطبیقهای متفاوتی بیابد بدتر از رابطی است با محدودیتی مستند و پیشبینیپذیر. برای متن تجاری لاتین — نامها، کدها، تاریخها — تاکردن ASCII موارد عملی را پوشش میدهد
جایگزینی متن: کدگذاری وارون و چسباندن جراحی
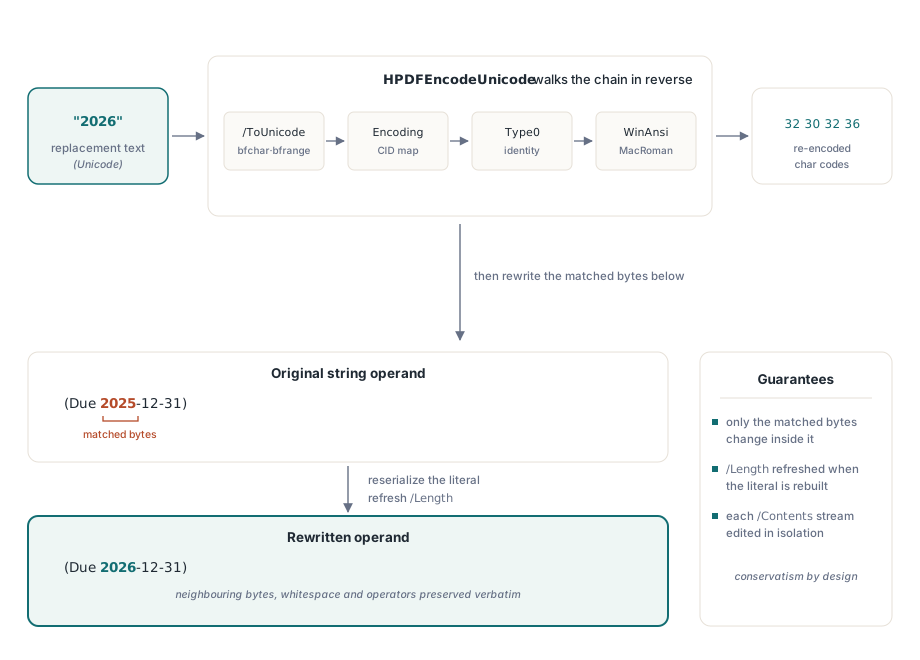
تابع ReplaceLoadedDocumentText که در HotPDF v2.252.0 افزوده شد، هر رخداد یک عبارت را با اجرای وارونه ماشین رمزگشایی بازنویسی میکند. تابع HPDFEncodeUnicode وارون رمزگشای کد کاراکتر است: همان زنجیره راهبردها را وارونه میپیماید — جستوجوی bfchar و bfrange در /ToUnicode، نگاشت CID در جریان کدگذاری، نگاشتهای همانی Type0، و جدولهای از پیش تعریفشده WinAnsi و MacRoman — تا هر کاراکتر جایگزین را به بایتهای کد کاراکتری که قلم اصلی انتظار دارد بازگرداند. بایتهای کدگذاریشده سپس در یک رشته لفظی یا رشته هگز خوشساخت سریال میشوند و قواعد گریز خود نشانهگذار را آینه میکنند تا رفتوبرگشت تجزیه ← سریالسازی دوباره پایدار بماند
خود چسباندن جراحی است نه یکجا. تنها بازه بایتهای کد که تطبیق پوششش میدهد درون عملوند رشتهای جایگزین میشود؛ بایتهای نامنطبق در همان عملوند، فاصله میان نشانهها، و هر عملگر پیرامون بایتبهبایت دستنخورده میمانند. جایگزینی bca درون abcabc نتیجهاش a + جایگزین + bc است، نه عملوندی خرابشده. جایگزینها میتوانند کوتاهتر یا بلندتر از عبارت باشند — رشته لفظی دوباره سریال میشود و /Length جریان تازه میشود — و هر جریان /Contents در صفحهای چندجریانی جداگانه پردازش میشود تا صفحه خوشساخت بماند
var
  Pdf: THotPDF;
  ReplaceCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, ReplaceCount) then
        WriteLn(Format('%d operand rewrites performed', [ReplaceCount]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
توجه کنید API چه کاری نمیکند: صفحه را دوباره حروفچینی نمیکند. PDF بازچینش ندارد، پس جایگزینی که از نظر دیداری پهنتر از اصل باشد صرفاً فضای افقی بیشتری اشغال میکند و ممکن است هرچه سمت راستش نقاشی شده را تنگ کند. جایگزینیهای همطول یا نزدیکبههمطول — تاریخها، رشتههای نسخه، شماره قطعهها، تصحیح نامها — نقطه شیرین کارند. بازنویسی یکجای عبارتها به سند مبدأ تعلق دارد، نه به PDF
چرا نمیتوان متن را با کاراکترهایی جایگزین کرد که زیرمجموعه قلم هرگز شاملشان نبوده؟
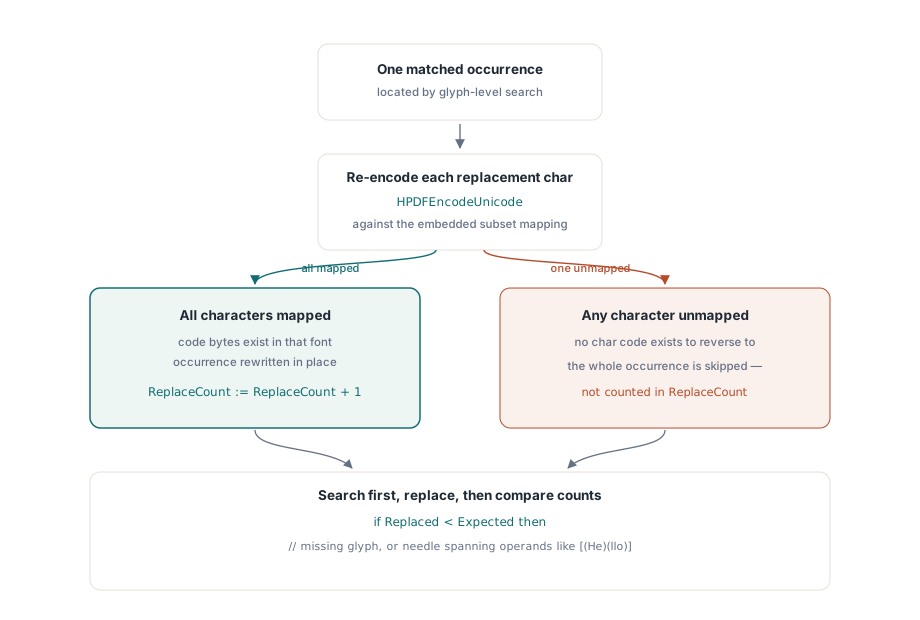
نمیتوانید متن را با کاراکتری جایگزین کنید که زیرمجموعه قلم جاسازیشده هرگز شاملش نبوده، چون دنباله بایتی که آن کاراکتر را انتخاب میکند اصلاً در جدولهای نگاشت قلم وجود ندارد. وقتی تولیدکننده PDF یک قلم زیرمجموعه را جاسازی میکند، CMap از نوع /ToUnicode و ساختارهای کدگذاری آن فقط گلیفهایی را پوشش میدهند که سند اصلی واقعاً به کار برده است. تابع HPDFEncodeUnicode فقط میتواند نگاشتی را وارونه کند که حاضر باشد: اگر سند هرگز حرف E را در آن قلم نداشته، هیچ کد کاراکتری برای E نیست که به آن بازگردیم. این خاصیتی فیزیکی از فایل است، نه محدودیت یک کتابخانه خاص — هیچ ابزاری نمیتواند نگاشت گلیفی را که هرگز جاسازی نشده از هوا بسازد
HotPDF این شکست را محافظهکارانه اداره میکند. اگر حتی یک کاراکتر از جایگزین قابل کدگذاری دوباره نباشد، کل آن رخداد عبارت رد میشود — نه استثنایی، نه متن آشغال ناقصی، و آن رخداد صرفاً در ReplaceCount شمرده نمیشود. پیامد عملی: مقدار ReplaceCount را در برابر شمار تطبیقهای یک جستوجوی پیشین بسنجید و کسری را یک علامت بدانید. در همان مثال تاریخ بالا، رقم 6 باید جایی در متن سند و در همان قلم آمده باشد تا بازنویسی موفق شود — در یک فاکتور محتمل است، اما در حالت کلی هرگز تضمینشده نیست. وقتی کاراکترهای موردنیازتان اصلاً در دسترس نیستند و هدف حذف متن حساس است نه بازنویسیاش، حذف واقعی محتوا بههرحال ابزار بهتری است؛ برای آن مسیر حذف اطلاعات و بازساختاردهی PDFهای بارگذاریشده در دلفی را ببینید
var
  Matches: THPDFTextMatchArray;
  Expected, Replaced: Integer;
begin
  Pdf.SearchLoadedDocumentText('Acme Corp', True, Matches);
  Expected := Length(Matches);
  Pdf.ReplaceLoadedDocumentText('Acme Corp', 'Apex Corp', True, Replaced);
  if Replaced < Expected then
    WriteLn(Format('%d occurrence(s) skipped: characters missing ' +
      'from the font subset, or match spans multiple operands',
      [Expected - Replaced]));
end;
شرط دوم رد در آن پیام، همان مرز مستند دیگر است: عبارتی که روی چند عملوند رشتهای کشیده شده — مثلاً Hello که میان قلمهای [(He)(llo)] TJ شکسته شده — با جستوجو یافت میشود، چون جستوجو دنباله گلیف رمزگشاییشده را تطبیق میدهد، اما جایگزینی ردش میکند، چون بازنویسی از مرز عملوندها نیازمند ادغام بازههای بایتی مجاور است. جستوجو و بعد راستیآزمایی، هر دو محدودیت را بهجای بیصدا نگهداشتن، دیدنی میکند
هنگام ذخیره چه چیزی در فایل تغییر میکند؟
جریان /Contents جایگزینشده بدون فشردهسازی ذخیره میشود. جریانهای فشرده با FlateDecode برای ویرایش از فشردگی درمیآیند، و وقتی HotPDF بایتهای بازساخته را مینویسد بهجای فشردهسازی دوباره، درایه /Filter جریان را میاندازد و /Length را تازه میکند. PDF حاصل کاملاً معتبر است و در نمایشگرهای اصلی عادی رندر میشود؛ معاملهاش فایل بزرگتر برای هر جریان ویرایششده است. برای خط لولهای دستهای که هزاران سند را پردازش میکند، برای این رشد بودجه بگذارید یا یک گذر فشردهسازی جدا در پاییندست اجرا کنید. اینکه اشیای بازنویسیشده هنگام ذخیره چگونه با ساختار ارجاع متقاطع سند تعامل میکنند موضوع خودش است و در جریانهای شیء و بهروزرسانیهای افزایشی در HotPDF پوشش داده شده است
هر چیز دیگری در فایل دستنخورده میماند. جریانهای دستنخورده فشردهسازیشان را نگه میدارند، قلمها و تصویرها بازنویسی نمیشوند، و چسباندن در سطح عملوند یعنی حتی جریانهای ویرایششده هم فقط جایی که تطبیقی افتاده با اصل فرق دارند. این محافظهکاری عامدانه است: هرچه کتابخانه بخش بیشتری از سند بارگذاریشده را بازنویسی کند، فرصت بیشتری برای شکستن ویژگی عجیب تولیدکنندهای پیدا میکند که پیشبینیاش نکرده بود
جستوجو و جایگزینی متن در جعبهابزار سند بارگذاریشده HotPDF به استخراج، حذف اطلاعات و رندر صفحه میپیوندد، و همه با همان مفسر جریان محتوا رانده میشوند و از دلفی 5 تا انتشارهای جاری RAD Studio بدون وابستگی بیرونی در دسترساند. مرجع کامل API و دانلود نسخه آزمایشی در صفحه محصول HotPDF Delphi Component است