وقتی PDF ای فونتی را embed نمیکند، کامپوننت HotPDF آن متن را با یک فونت نصبشدهٔ Windows رندر میکند که HPDFMapBaseFontToSystem انتخابش میکند: نام /BaseFont را دیکود میکند، بخش استایل را میتراشد، چند املا را امتحان میکند تا GDI تأیید کند خانواده نصب است، عرضهای گمشدهٔ 14 فونت استاندارد را از فونتهای متریک-سازگار اندازه میگیرد و کدهای تکبایتی را قبل از کشیدن به Unicode تبدیل میکند. تکتک آن مراحل به این دلیل وجود دارند که نسخهٔ سادهلوح روی فایلهای واقعی شکست میخورد. رندرکنندهٔ صفحهٔ RenderLoadedPageToBitmap برنامههای embed شده را خوب هندل میکند؛ این داستان فونتهایی است که اصلاً داخل فایل نیستند
چرا GDI برای یک فونت غیر embed شده بیسروصدا typeface اشتباه میکشد؟
GDI هرگز فونت گمشده را گزارش نمیکند: به CreateFontIndirect یک نام face بده که نمیشناسد و بیسروصدا یک جایگزین انتخاب میکند، اغلب یک serif دیگر بدون وزن bold. رندرکنندهٔ اولیه نام PDF را تقریباً عیناً پاس میداد، پس TimesNewRoman,Bold و TimesNewRomanPS-BoldMT و SegoeUI-Semibold همه هیچ تطبیقی نمییافتند و در هر چه GDI انتخاب میکرد بیرون میآمدند. نامها میتوانند بدتر از این هم باشند. ISO 32000-1 §7.3.5 اجازه میدهد نام هر بایتی را بهشکل #xx بنویسد و تولیدکنندههای CJK اسم فونتها را بهطور معمول بهشکل UTF-8 اسکیپشده یا بایتهای code page قدیمی مینویسند؛ قبل از v2.766.69 خود اسکیپها به نام face تبدیل میشدند. HPDFMapBaseFontToSystem حالا اول اسکیپها را دیکود میکند، یک دنبالهٔ بایت UTF-8 معتبر را بهعنوان نویسههایش برمیگرداند و بایتهای بالای دیگر را در code page سیستم میخواند
بریدن استایل جایی است که هیوریستیک گاز میگیرد. یک کاما همیشه خانواده را تمام میکند (Arial,Bold میدهد Arial)، ولی خط تیره فقط وقتی تمام میکند که کلمهٔ بعدش یک استایل باشد: Bold، Italic، Oblique، Regular، Roman، Medium، Light، Black، Heavy، Semi، Demi، Thin، Extra، Ultra یا Condensed. این قاعده MS-Mincho را کامل نگه میدارد در حالی که Calibri-Light را به Calibri تبدیل میکند. HotPDF بعد املای خانواده را امتحان میکند و بعد املای خانواده با پسوند PSMT یا MT یا PS حذفشده. از v2.768.18 این املها همهٔ انتخابهای فاصله در مکانهایی که یک کلمه میتواند شروع شود را پوشش میدهند: قبل از یک حرف بزرگ که بعد از یک حرف کوچک میآید (MyriadPro میشود Myriad Pro)، در آخرین حرف بزرگ یک ران که حرف کوچک بعدش میآید (UIGothic)، و بعد از یک MS پیشوندی (MSPGothic)، از شکل کاملاً فاصلهدار تا نام همانطور که نوشته شده؛ بعد از چهار مکان از این قبیل فقط شکل کاملاً فاصلهدار و نام چسبیده امتحان میشوند. فاصلهگذاری را نمیشود کورکورانه اعمال کرد، چون Windows بعضی کلمهها را چسبیده نگه میدارد: SimSun دقیقاً با همین املا نصب است، در حالی که MicrosoftYaHei و MicrosoftJhengHei و MSPGothic مالِ Microsoft YaHei و Microsoft JhengHei و MS PGothic هستند. قبل از v2.768.18 نگاشتکننده قبل از هر حرف بزرگ داخلی یک فاصله میگذاشت، پس MicrosoftYaHei بهشکل Microsoft Ya Hei جستوجو میشد و هرگز پیدا نمیشد. یک نامزد وقتی نصبشده حساب میشود که CreateFontIndirect و بعدش GetTextFace همان نامی را برگرداند که درخواست شده بود یا، از v2.768.18، وقتی جدول name فونت انتخابشده آن را بهشکل خانواده، نام کامل یا نام خانوادهٔ تایپوگرافیک در هر زبانی فهرست کند؛ جواب بهازای هر نام کش میشود، پس اسنادی با فونتهای زیاد که نصب نیستند دیگر در هر صفحه برای هر نام ویندوز را پروب نمیکنند
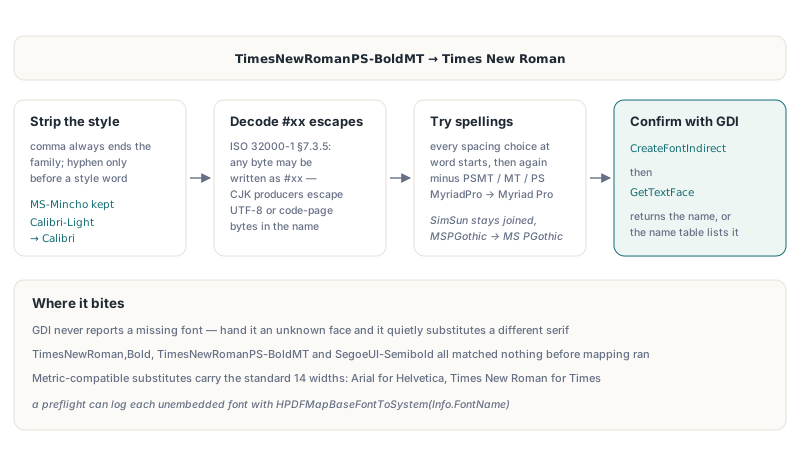
چون تابع نگاشت عمومی در یونیت HPDFRenderFontMetrics است، یک گزارش preflight میتواند نشان بدهد هر فونت غیر embed با کدام خانوادهٔ نصبشده رندر خواهد شد، با استفاده از شمارش فونتی که THotPDF از قبل برای اسناد بارگذاریشده در اختیار میگذارد:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
HotPDF فونتهای 14 تای استانداردی که /Widths ندارند را چطور اندازه میگیرد؟
HotPDF پیشرویهای گمشده را روی فونت نصبشده با همان متریکها اندازه میگیرد، چون ISO 32000-1 §9.6.2.2 اجازه میدهد 14 فونت استاندارد /Widths را حذف کنند و کتابخانه هیچ جدول AFM ای حمل نمیکند. Arial متریکهای Helvetica را حمل میکند، Times New Roman متریکهای Times را و Courier New متریکهای Courier را، پس HPDFMeasureBaseFontWidths face متناظر را در lfHeight = -1000 میسازد و صدایش میزند GetCharWidth32W را؛ در آن ارتفاع نتیجه از قبل در واحدهای 1/1000 em است که عرضهای PDF استفاده میکنند. رندرکننده اول هر کد را از طریق /Encoding و /BaseEncoding و /Differences با پیشفرض StandardEncoding به Unicode تبدیل میکند. export از SVG و استخراج متن به یک دام دیگر میخورند: یک فونت Type 1 استاندارد بدون هیچ /Encoding ای یک دیکودر بدون هیچ اطلاعات انکودینگ تولید میکرد، export از SVG هرگز آن را ثبت نمیکرد و هر عرض اندازهگیریشده بلااستفاده میماند. فراهم کردن StandardEncoding ضمنی آن را تعمیر کرد، به شرطی که بهعنوان یک انکودینگ از پیش تعریفشده علامت بخورد؛ فرستادنش به مسیر نام-CMap هر کد را بهشکل 0 دیکود میکرد و همهٔ عرضها دنبالهرو میشدند
Bold و ایتالیک و یک off-by-one در فلگهای descriptor فونت
درایهٔ /Flags در descriptor فونت موقعیت بیتهایش را از 1 میشمارد، نه از 0، پس ForceBold بیت 19 است ($40000) و Italic بیت 7 ($40)، طبق ISO 32000-1 جدول 123. کد قدیمی $20000 را تست میکرد که بیت 18 یعنی SmallCap است. این اشتباه از v2.345.0 تا v2.766.53 دوام آورد چون /FontDescriptor تقریباً همیشه یک ارجاع غیرمستقیم است و سازندهٔ فونت فقط اشیای مستقیم را میخواند، پس کل شاخهٔ فلگها هرگز اجرا نمیشد، و همان کوری /Widths 12 0 R را هم نادیده میگرفت و متن را با یک پیشروی fallback برابر 500 واحد میچید. وقتی v2.766.53 شروع به حل کردن ارجاعهای غیرمستقیم از طریق رندرکننده کرد، بیت باید در همان تغییر اصلاح میشد، وگرنه هر face با حروف کوچک بزرگنماییشده ناگهان bold رندر میشد:
const
// ISO 32000-1 جدول 123 موقعیت بیتها را از 1 میشمارد
FD_ITALIC = $00040; // بیت 7
FD_SMALLCAP = $20000; // بیت 18، نه یک وزن
FD_FORCEBOLD = $40000; // بیت 19
procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
if (Flags and FD_FORCEBOLD) <> 0 then
LF.lfWeight := FW_BOLD;
if (Flags and FD_ITALIC) <> 0 then
LF.lfItalic := 1;
end;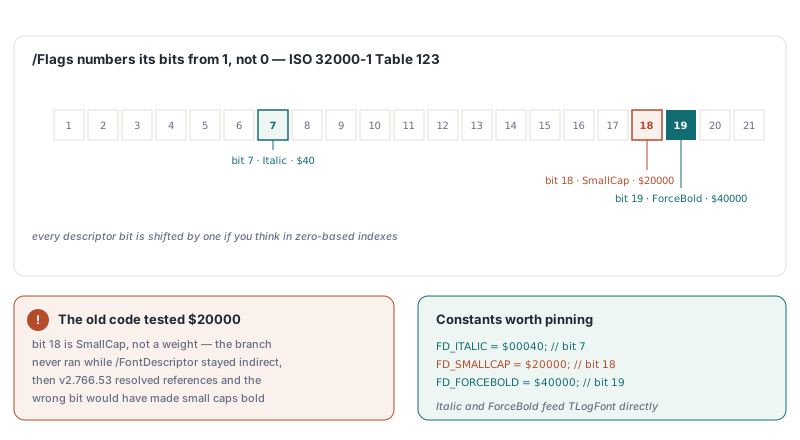
چرا فونتهای CJK با CMap از نوع UCS2 عرضهای اشتباه میگیرند؟
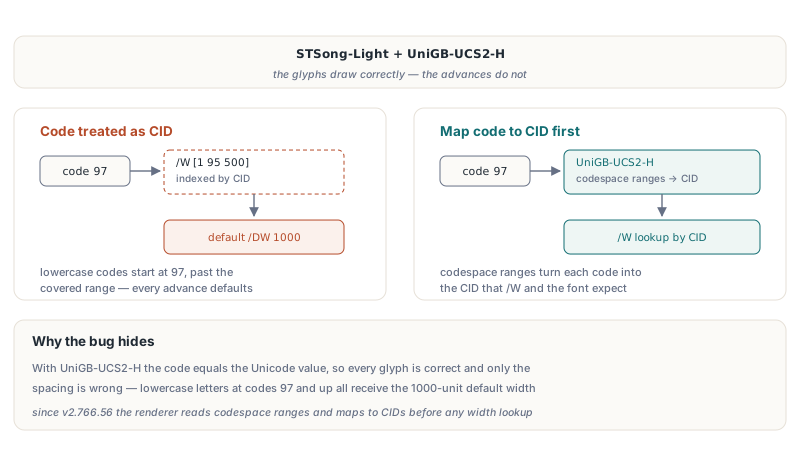
متن CJK با یک CMap از پیش تعریفشدهٔ UCS2 گلایفهای درست را با فاصلهگذاری غلط میکشد وقتی رندرکننده کد را همان CID بگیرد، چون /W با CID ایندکس میشود نه با کد نویسه. با STSong-Light و UniGB-UCS2-H، اتفاقاً کد برابر مقدار Unicode است، پس GDI نویسههای درست را میکشد و باگ در پیشرویها پنهان میشود: حروف کوچک بهشکل کدهای 97 به بالا میرسند، بیرون از یک درایهٔ /W مثل [1 95 500] میافتند و همه عرض پیشفرض /DW یعنی 1000 را میگیرند. از v2.766.56 رندرکنندهٔ HotPDF کدها را از طریق بازههای codespace مربوط به CMap (ISO 32000-1 §9.7.6.2) میخواند و قبل از جستوجوی عرضها به CID نگاشت میکند. فقط جدولهای داخلی UCS2 و UTF16 و streamهای CMap embed شده استفاده میشوند؛ یک تقریب همانی برای چیزی مثل GBK-EUC-H فقط شبیه پشتیبانیشده به نظر میرسید در حالی که خروجی غلط تولید میکرد، پس رندرکننده ادعای بیپایه نمیکند
چرا نویسههای دارای اعراب روی Windows چینی به علامت سؤال تبدیل میشوند؟
کدهای تکبایتی هرگز نباید به توابع GDI از نوع ANSI یعنی «A» برسند، چون GetGlyphOutlineA و GetGlyphIndicesA بایتها را در code page سیستم تفسیر میکنند در حالی که TextOutA از مجموعهنویسهٔ فونت انتخابشده استفاده میکند. روی یک سیستم چینی، بایت $A9 مربوط به Arial (نشانهٔ copyright در Windows-1252) یک بایت آغازین GBK میشد و بهشکل «؟» رندر میشد، دامی که مسیر outline بدون hint که v2.766.83 اضافه کرد مستقیم داخلش افتاد. v2.767.3 با GetTextCharset از فونت تحققیافته مجموعهنویسهاش را میپرسد، با TranslateCharsetInfo به یک code page تبدیلش میکند، بایت را از MultiByteToWideChar میگذراند و توابع W را صدا میزند؛ فونتهای symbol بهجایش از U+F000 بهعلاوهٔ کد استفاده میکنند. انکودینگهایی که با Windows-1252 ناسازگارند یعنی /Differences و StandardEncoding و MacRomanEncoding قبل از اینکه هر فونت سیستمی آنها را ببیند به Unicode نگاشت میشوند
محدودیتهای کشیدن با فونتهای سیستم چیست؟
رندر با فونت سیستم یک تقریب است و کامپوننت HotPDF صادقانه میگوید کجا تمام میشود. قبل از v2.768.18 چک نصب فقط نامی را مقایسه میکرد که GetTextFace برمیگرداند، و روی Windows محلیسازیشده آن تابع نام خانواده را به زبان سیستم گزارش میکند، پس Microsoft YaHei روی Windows چینی یا Yu Mincho روی Windows ژاپنی غایب قضاوت میشد و با یک جایگزین GDI کشیده میشد؛ از v2.768.18 یک face که زیر نام دیگری برمیگردد هم در جدول name فونت جستوجو میشود و چنین فونتهایی پیدا میشوند. سازگاری متریک فقط برای خانوادههای Helvetica و Times و Courier تضمین شده؛ Symbol به Symbol نگاشت میشود و ZapfDingbats به Wingdings، که یک چسب زخم است نه یک تطبیق. preflight بالا هم فقط فونتهای داخل dictionary مربوط به /Resources هر صفحه را میبیند، نه آنهایی که از داخل form XObjectها ارجاع میشوند. وقتی کدی هنوز قابل کشیدن نیست، ردیابی گلایف حلنشده در زمان رسم گزارشش میکند، که سیگنال بهتری از نگاه کردن به thumbnailهاست
fix ماندگار سمت نگارش است. خود HotPDF با FontEmbedding روی True بهصورت پیشفرض مینویسد و حتی وقتی کد با Helvetica صدایش میزند SetFont را، یک Arial embed شده جایگزین میکند، و متن embed شده از رندرکنندهٔ گلایف فونت embed شده میگذرد بهجای هر کدام از حدسهای بالا. یک گارد ارزان برای فایلهای ورودی این است که وقتی یک خانوادهٔ نگاشتشده در فهرست فونتهای صفحه نیست قبل از رندر هشدار بدهی:
// VCL: Screen.Fonts نام خانوادههای نصبشده را فهرست میکند (یونیت Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;برای کامپوننت کامل، شامل رندر صفحه و استخراج متن و font subsetting در سمت نگارش، به صفحهٔ محصول HotPDF Delphi PDF component نگاه کن