Un archivo de facturas puede renderizar limpio, imprimir, incrustar todas las fuentes y llevar un output intent válido, y un validador PDF/A seguirá rechazándolo porque un diccionario de recursos tiene 4.096 entradas. El techo es 4.095. PDF/A hereda una pequeña tabla de límites de implementación del PDF Reference, y un archivo una unidad por encima de cualquiera de ellos falla la conformidad aunque ningún visor se queje
El otro fallo que aterriza en el mismo saco de «pero se ve bien» es una fuente TrueType simbólica que lleva una entrada /Encoding. Checkboxes, códigos de barras y dingbats salen bien en pantalla, y el validador igualmente marca el diccionario de la fuente. Ambos problemas viven en el grafo de objetos más que en cualquier cosa que una persona vea en la página, así que vale la pena comprobarlos mecánicamente antes de que un documento entre en el almacén
Los números que PDF/A hereda, y dónde se sienta la frontera
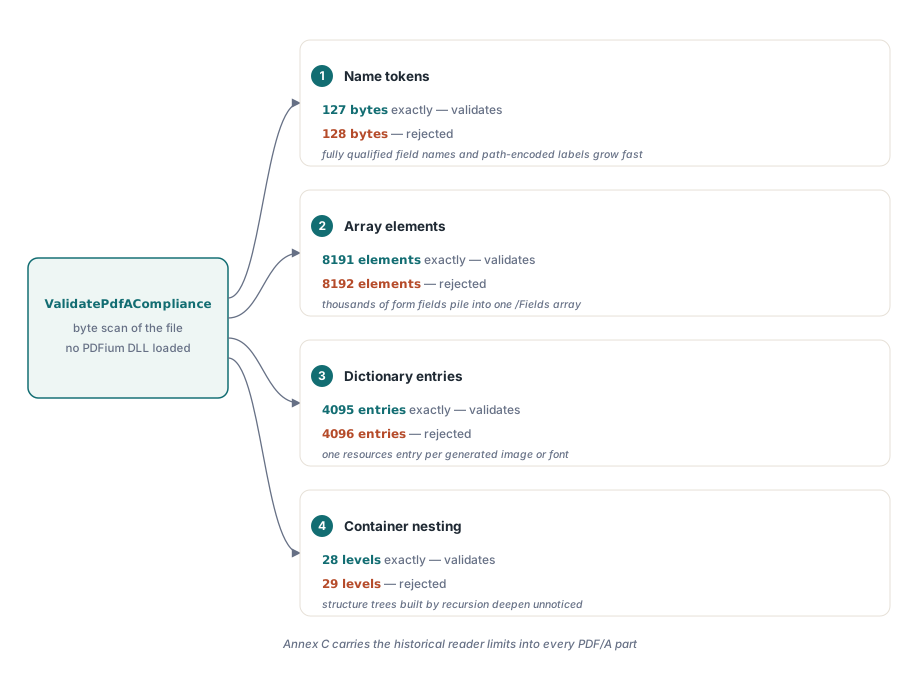
PDFium Component comprueba cuatro límites de contenedor en cada validación PDF/A: un token de nombre puede medir como máximo 127 bytes, un array puede llevar como máximo 8.191 elementos, un diccionario puede llevar como máximo 4.095 entradas, y arrays y diccionarios pueden anidar como máximo 28 niveles. Las cuatro fronteras son inclusivas. Un nombre de 127 bytes pasa y uno de 128 falla; un array de exactamente 8.191 elementos pasa y uno más lo tumba
Los límites de nombre, array y diccionario vienen de la época en que solo se exigía a un lector conforme manejar estructuras hasta esos tamaños. Un visor de escritorio actual puede abrir un array mucho mayor sin queja, pero se supone que un archivo de archivado debe abrirse en lectores que nadie ha probado aún, incluidos los viejos que un sistema de gestión documental puede seguir ejecutando. Por eso PDF/A conserva los techos históricos en lugar de relajarlos
Inclusivo frente a exclusivo es donde suelen fallar las comprobaciones hechas a mano. Un test escrito como Count >= 8191 en lugar de Count > 8191 rechaza archivos que cumplen, y un validador que rechaza archivos conformes tiende a creérsele igualmente, así que el generador se «arregla» para un problema que nunca tuvo. La función ValidatePdfACompliance de la unidad FPdfPdfa cuenta estrictamente pasado el límite, y lee los bytes del archivo directamente, así que la comprobación corre sin cargar la DLL de PDFium
uses
  System.Classes, FPdfPdfa;

procedure CheckContainerLimits(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Res: TPdfAValidationResult;
begin
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfACompliance(Src);   // escaneo de bytes, sin necesidad de la DLL de PDFium
    if pvaiNameOverLimit in Res.Issues then
      Log.Add('A name token is longer than 127 bytes');
    if pvaiArrayOverLimit in Res.Issues then
      Log.Add('An array holds more than 8191 elements');
    if pvaiDictOverLimit in Res.Issues then
      Log.Add('A dictionary holds more than 4095 entries');
    if pvaiNestingOverLimit in Res.Issues then
      Log.Add('Arrays and dictionaries nest deeper than 28 levels');
    if Res.IsCompliant then
      Log.Add('No PDF/A findings');
  finally
    Src.Free;
  end;
end;
Los cuatro flags son miembros del conjunto Issues de TPdfAValidationResult, junto al resto de hallazgos PDF/A, y IsCompliant devuelve True solo cuando se encontró una identificación PDF/A y el conjunto está vacío. Un archivo que no lleva identificación PDF/A alguna se comprueba contra el conjunto de reglas estricto de PDF/A-1, así que los límites de contenedor también le aplican
¿Qué generadores se topan con estos límites?
Casi siempre los que construyen estructura en un bucle. Un formulario con varios miles de campos produce un array /Fields de AcroForm, o un array /Annots de página, que rebasa los 8.191. Un motor de informes que registra un recurso de fuente o imagen por objeto generado, y nunca reutiliza una entrada existente, hace crecer un sub-diccionario /Resources pasado de 4.095 claves. Un documento etiquetado cuyo árbol de estructuras se produce recursando sobre un modelo de datos anidado puede pasar de 28 niveles sin que nadie mire
Los nombres largos tienen otro origen: datos empaquetados en tokens de nombre. Un colorante de separación nombrado por una referencia de cliente, un grupo de contenido opcional nombrado por una ruta de archivo, una etiqueta de campo armada con seis niveles de jerarquía. Los nombres no cuestan nada de generar, y 127 bytes se van rápido en cuanto hay una etiqueta UTF-8 con caracteres acentuados, porque cada uno de esos caracteres ocupa dos o tres bytes. Los 127 bytes se cuentan tras el introductor /, hasta el siguiente delimitador o espacio
El remedio es estructural siempre. Parte el array, parte el diccionario, aplana la recursión, acorta el nombre. Inyectar marcadores PDF/A en el archivo no puede ayudar con ninguno de estos hallazgos, porque el problema es la forma del grafo de objetos y los metadatos XMP no dicen nada de ello
Cómo cuenta el escaneo elementos y entradas
La regla de recuento importa cuando intentas reproducir un hallazgo en un editor hexadecimal. Un array o diccionario anidado cuenta como un elemento de su padre, que es como está formulado el límite: un array de 10 elementos de arrays de 1.000 elementos está bien, porque ningún array individual supera 8.191. Dentro de un diccionario solo se cuentan las claves, así que un valor que resulte ser un nombre no hincha el total de entradas. Las cadenas hexadecimales como <FEFF0041> se saltan como tokens únicos, así que sus corchetes angulares jamás se confunden con anidamiento de diccionario
El escaneo cubre la estructura de objetos de todo el archivo, incluidos los objetos guardados dentro de streams de objetos comprimidos, que se expanden antes de contar. Los cuerpos de los streams propiamente dichos, como contenido de página y datos de imagen, se blanquean primero, así que una racha de bytes binarios que por casualidad contenga un / o un [ no puede disparar un hallazgo falso de nombre o array
Hay un límite numérico colindante que la misma validación informa bajo su propio flag. Cuando el archivo declara PDF/A-2 o una parte posterior, pvaiIntegerImplementationLimit se dispara para cualquier token entero fuera del rango con signo de 32 bits, es decir fuera de -2.147.483.648 a 2.147.483.647. Los generadores que escriben offsets de byte o contadores grandes como enteros planos son la fuente habitual
¿Por qué una fuente TrueType simbólica debe soltar /Encoding?
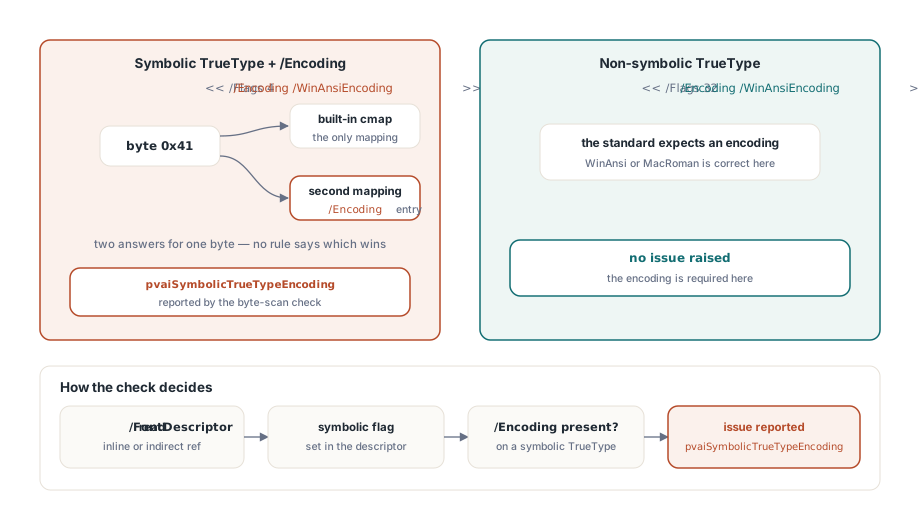
ISO 19005-1 §6.3.7 admite solo el cmap incorporado en el programa de fuente como mapeo de caracteres para una fuente TrueType simbólica. Una fuente simbólica mapea códigos a glifos a su manera; eso es lo que declara el flag Symbolic. Añade una entrada /Encoding y el archivo da ahora dos respuestas a la pregunta «qué glifo selecciona el byte 0x41», sin nada en el archivo que diga cuál gana. Los lectores resuelven el conflicto de formas distintas, y el mismo checkbox puede salir como una marca en un visor y como la letra A en otro
ValidatePdfACompliance encuentra cada diccionario de fuente con /Subtype /TrueType, comprueba si tiene una clave /Encoding y después lee el bit 3 (valor 4) de la entrada /Flags del descriptor de fuente. El descriptor se sigue tanto si va escrito en línea en el diccionario de fuente como si se referencia como objeto indirecto. A una fuente TrueType no simbólica que conserva /WinAnsiEncoding o /MacRomanEncoding no la marca esta comprobación, porque para fuentes no simbólicas PDF/A espera exactamente esa codificación
// Res viene de ValidatePdfACompliance como en el primer ejemplo
if pvaiSymbolicTrueTypeEncoding in Res.Issues then
  Log.Add('A symbolic TrueType font carries /Encoding; PDF/A admits only ' +
    'the font''s built-in cmap (ISO 19005-1 6.3.7)');

// Una regla de fuente vecina con disparador distinto: una fuente TrueType
// NO simbólica cuyo diccionario Encoding lleva /Differences
if pvaiTrueTypeDifferencesForbidden in Res.Issues then
  Log.Add('A non-symbolic TrueType Encoding dictionary carries /Differences');
Las fuentes que tropiezan con esta regla son predecibles: Symbol, Wingdings, fuentes de códigos de barras, fuentes de iconos. Aparecen en documentos de negocio como checkboxes, estrellas de valoración y códigos de barras, y un paso de subsetting que trata todas las fuentes TrueType igual les escribe una codificación también. Son además las fuentes que nadie mira cuando un validador dice «problema de fuentes», porque las fuentes del cuerpo del texto se comprueban primero
El error contrario también aparece en la naturaleza: un productor pone el flag Symbolic en una fuente de texto ordinaria que en realidad está codificada en WinAnsi. La comprobación PDF/A sigue la cláusula tal como está escrita y reporta esa fuente, y aquí el arreglo pertenece al descriptor: corrige el flag en el descriptor en lugar de borrar la codificación. Quitar la /Encoding a una fuente de texto mal etiquetada dejaría el texto dependiente del cmap que el subconjunto traiga, que es un archivo peor que el que tenías. Mira el conjunto de glifos de la fuente antes de elegir qué mitad de la contradicción vas a soltar
Leer los hallazgos en un informe de preflight
La unidad de informes de preflight viaja con la edición Enterprise, mientras que ValidatePdfACompliance está en todas las ediciones. El informe de la unidad FPdfPreflightReport clasifica los cuatro límites de contenedor en la categoría Structure y el problema de codificación TrueType simbólica en la categoría Content. Esa división es deliberada. Los hallazgos de estructura suelen volver con quien mantiene el generador, mientras que los de contenido suelen irse con quien suministró las fuentes y las plantillas, y un informe que los mezcla manda a los dos detrás de problemas que no son suyos
Cada problema lleva su nombre de enum como Code y una recomendación que nombra el remedio en términos concretos, por ejemplo «Split dictionaries so none carries more than 4095 entries». Fíjate en que la categoría Structure también guarda otros dos hallazgos, una estructura etiquetada ausente en una reclamación de Level A y streams de referencia cruzada u objetos PDF 1.5 en un archivo PDF/A-1, así que filtra por código cuando solo quieras los cuatro límites
uses
  System.SysUtils, System.Classes, PDFium, FPdfPreflightReport;

procedure ReportStructureFindings(const FileName: string; Log: TStrings);
var
  Pdf: TPdf;
  Report: TPdfPreflightReport;
  Issues: TPdfPreflightIssues;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;          // esta ruta carga la DLL de PDFium
    if not Pdf.Active then
      Exit;
    Report := BuildPdfPreflightReport(Pdf, [ppsPdfA]);
    Issues := Report.FilterByCategory('Structure').FlattenIssues;
    for I := 0 to High(Issues) do
      Log.Add(Issues[I].Code + ': ' + Issues[I].Recommendation);
    Report.SaveJsonToFile(ChangeFileExt(FileName, '.preflight.json'));
  finally
    Pdf.Free;
  end;
end;
Las dos rutas responden preguntas ligeramente distintas. BuildPdfPreflightReport pasa por TPdf.ValidatePdfA, que guarda el documento abierto en una copia temporal, corre el mismo escaneo de bytes sobre esa copia y después añade comprobaciones que necesitan el motor PDFium, como fuentes que se usan en una página pero no están incrustadas. ValidatePdfACompliance juzga los bytes exactos en disco. Para límites de implementación, la vía de bytes sobre el archivo original es la que hay que fiarse: informa sobre el archivo que estás a punto de archivar, y corre en un paso de build o en un servicio blindado donde una DLL nativa no se puede desplegar. Usa la vía del informe cuando además quieras las comprobaciones a nivel de motor y la salida JSON, SARIF o JUnit para un pipeline
Por dónde seguir
Correr estas comprobaciones sobre una carpeta, decidir qué hallazgos bloquean una entrega y convertir el resultado en un informe que la gente lea están cubiertos en el recorrido de la validación preflight PDF/A en Delphi y en la CLI de informes preflight por lotes. Qué parte PDF/A y nivel de conformidad apuntar en primer lugar es el tema de las notas sobre el cumplimiento de archivado PDF/A; esa elección decide, entre otras cosas, si el límite de enteros se aplica
Los validadores mostrados aquí viajan con PDFium Component para Delphi, C++Builder y Lazarus, junto al renderizado, el relleno de formularios y la edición sobre el motor PDFium. La página de producto de PDFium Component lista los estándares de conformidad soportados, las ediciones y las versiones de compiladores