Una búsqueda de un número de factura en un PDF escaneado encuentra el resultado, pero el resaltado queda media pulgada a la izquierda de los dígitos impresos y media pulgada por debajo. Media pulgada son 36 puntos, y la página en cuestión tiene un CropBox de [36 36 576 756]. Quien construyó esa capa de texto convirtió posiciones de píxel en posiciones de página dividiendo por el ancho del mapa de bits y multiplicando por el ancho de la página, lo que supone que el área visible empieza en el origen. En una página con /Rotate 90 la misma fórmula lo hace aún peor: el eje x del mapa de bits pasa a discurrir por el eje y de la página, y las palabras caen en la parte equivocada de la página
Qué es realmente una capa de texto invisible
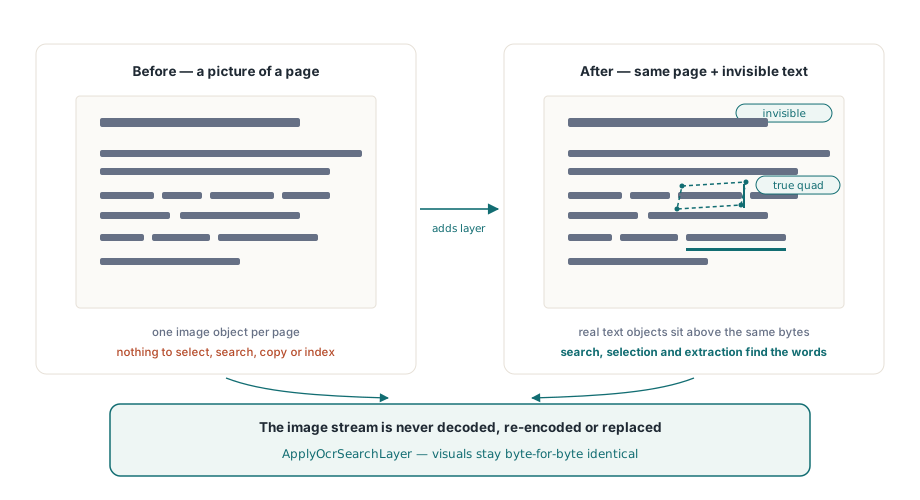
Una página escaneada es una única imagen grande pintada por el content stream. No hay nada que seleccionar, buscar, copiar o indexar. Una capa de texto buscable añade objetos de texto ordinarios sobre esa imagen y les fija el modo de renderizado de texto en 3, que la ISO 32000-1 §9.3.6 (Tabla 106) define como ni relleno ni trazo: los glifos existen para la selección, la búsqueda y la extracción, y un visor no pinta nada por ellos. Bien hecho, el lector ve el escaneado original y Ctrl+F encuentra las palabras justo donde están impresas
En PDFium Component todo el trabajo es una única llamada, TPdf.ApplyOcrSearchLayer. Renderiza cada página seleccionada, pasa los píxeles a un proveedor de OCR, filtra las palabras reconocidas por confianza y escribe las supervivientes como objetos de texto invisibles. La imagen de la página se deja como está: el escaneado no se decodifica, no se recodifica ni se sustituye, así que una imagen JBIG2 o CCITT G4 conserva los bytes comprimidos exactos con los que llegó. El método se incluye en las ediciones Small Business y Enterprise, de modo que el proyecto necesita Lib\SmallBusiness en el search path y FPdfSmallBusiness en una cláusula uses; sin esa unidad la llamada lanza EPdfSmallBusinessRequired
Escribir un IPdfOcrProvider
El reconocimiento en sí se esconde tras una única interfaz. IPdfOcrProvider.RecognizePage recibe un TPdfOcrImage (número de página, ancho, alto, stride, DPI, formato de píxel y un buffer TBytes con filas BGRA de arriba hacia abajo), más un token de cancelación, y devuelve un array de records TPdfOcrWord: texto Unicode, una confianza entre 0 y 1 y un cuadrilátero de cuatro esquinas en píxeles de imagen. La edición incluye un proveedor listo para usar, CreatePdfTesseractOcrProvider en FPdfOcrTesseract, que se enlaza a una librería Tesseract y a un directorio traineddata que vosotros facilitáis. Cualquier otro motor, una API en la nube o un SDK comercial, se enchufa mediante una clase como esta:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // Las rutinas Engine* de abajo representan el enlace con vuestro propio motor de OCR
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // informad una cancelación como cancelación

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // Muchos motores informan 0..100; la capa espera 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Un proveedor que deja pasar el 87,5 de Tesseract tal cual consigue que se rechace cada palabra. Tesseract, por poner un caso, informa de la confianza de palabra como porcentaje, y el adaptador incluido la divide antes de devolverla; un proveedor propio tiene que hacer lo mismo, porque ApplyOcrSearchLayer trata una confianza por encima de 1 como entrada no válida. El síntoma es inconfundible una vez que sabéis dónde mirar: Report.RejectedWordCount iguala a Report.DetectedWordCount y el archivo guardado no contiene texto alguno
La llamada al token importa por otra razón. Si el proveedor detecta la cancelación y simplemente devuelve False, la página queda registrada como popsFailed con el mensaje que hayáis fijado. Llamando a ThrowIfCancelled se lanza en su lugar EPdfOperationCancelled, que la capa captura y registra como popsCancelled, con Report.Cancelled activado y el bucle detenido. El token nunca es nil dentro de un proveedor; cuando quien llama no pasa ninguno, se suministra un token que nunca se cancela
Cuadriláteros y palabras que la capa rechaza
Los escaneados rara vez están cuadrados con la página, así que una palabra en una hoja ligeramente torcida ocupa un paralelogramo. TPdfOcrQuad lleva los puntos TopLeft, TopRight, BottomRight y BottomLeft precisamente para ese caso, y FromRectangle construye la versión alineada a ejes para motores que solo informan de cajas. Una palabra se salta y se cuenta en RejectedWordCount cuando su texto está vacío o supera MaxWordCharacters, cuando su confianza es NaN, está por debajo de MinConfidence o por encima de 1, cuando alguna esquina cae fuera del mapa de bits, o cuando el cuadrilátero colapsa en una astilla más estrecha de 0,01 pt tras el mapeado
Por qué el escalado proporcional descentra las palabras del OCR
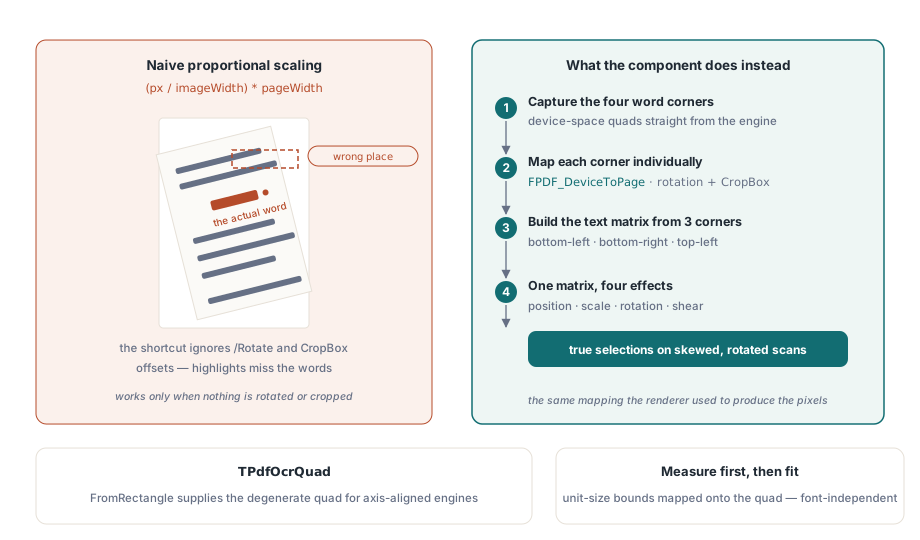
El escalado proporcional solo es correcto cuando la página no tiene entrada /Rotate y su CropBox empieza en (0, 0). Montones de escaneados fallan alguna de esas condiciones: una hoja apaisada se guarda a menudo como página vertical con /Rotate fijado, y las cajas de recorte se desplazan cuando alguien recorta los márgenes en un editor. El ejemplo de la apertura es el fallo leve; con rotación el error deja de ser un desplazamiento y se convierte en un eje intercambiado
ApplyOcrSearchLayer hace pasar cada una de las cuatro esquinas por FPDF_DeviceToPage, usando el mismo tamaño de mapa de bits y la misma rotación que produjeron los píxeles que vio el proveedor. La rotación y los desplazamientos del CropBox quedan así en manos de la misma transformación que empleó el renderizador. Las esquinas se redondean a píxeles enteros a la entrada, lo que a los 300 DPI por defecto es un paso de cuantización de 0,24 pt, muy por debajo de lo que un resaltado de selección puede mostrar
A partir de los puntos mapeados, las esquinas inferior izquierda, inferior derecha y superior izquierda definen una matriz afín. Tres puntos bastan para expresar posición, escala, rotación y cizalla, y por eso la cuarta esquina solo se valida, nunca se usa para el ajuste. El objeto de texto se crea con tamaño de fuente 1, se miden sus límites reales y la matriz lleva esos límites medidos hasta el cuadrilátero objetivo. Adivinar un tamaño en puntos desde la altura del cuadrilátero derivaría con el ascendente y el descendente de cada fuente; medir primero hace el ajuste independiente de la fuente que nombre Options.FontName
La fuente sigue importando para la extracción aunque no se dibuje nada. TPdfOcrOptions.Default la fija en Arial. Si esa fuente no puede cargarse, la capa recurre a la Helvetica estándar, una de las 14 fuentes estándar, cuya codificación integrada cubre solo texto latino. Para salida en cirílico, griego o CJK, fijad FontName a una fuente instalada que cubra ese sistema de escritura
Ejecutar la capa y leer el informe
ApplyOcrSearchLayer devuelve True solo cuando ninguna página falló y nada se canceló. Ese valor de retorno es lo equivocado para decidir el guardado. Con ContinueOnError en su valor por defecto True, un trabajo de 300 páginas con una página ilegible devuelve False mientras 299 páginas llevan una capa correcta, y la página fallida ya se ha dejado como estaba. Decidid el guardado por el informe:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // dejadlo donde un botón de cancelar pueda alcanzarlo
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0.5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
No guardar tras una cancelación es una decisión de criterio, y es la que se toma aquí. Un trabajo cancelado deja un archivo que es buscable en su primera parte y está en blanco en el resto, y nada en el PDF le dice al siguiente lector dónde se detiene la capa. Relanzar el documento entero más adelante cuesta menos que explicar un archivo medio indexado
SkipPagesWithText vale True por defecto y comprueba si la página ya produce algún carácter extraíble. Eso mantiene fuera del OCR las páginas nacidas digitales, evita una segunda capa en archivos procesados antes y convierte una repetición sobre la misma salida en un no-op. La contrapartida es que un solo carácter real ya cuenta: un escaneado con un sello Bates estampado como texto real se informa como popsSkippedExistingText y no recibe capa. Los archivos construidos así necesitan SkipPagesWithText := False y un rango de páginas cuidado a través de FirstPage y LastPage, de lo contrario las páginas procesadas antes adquieren una capa duplicada y la extracción devuelve cada palabra dos veces
Presupuestos de píxeles, cancelación y rollback por página
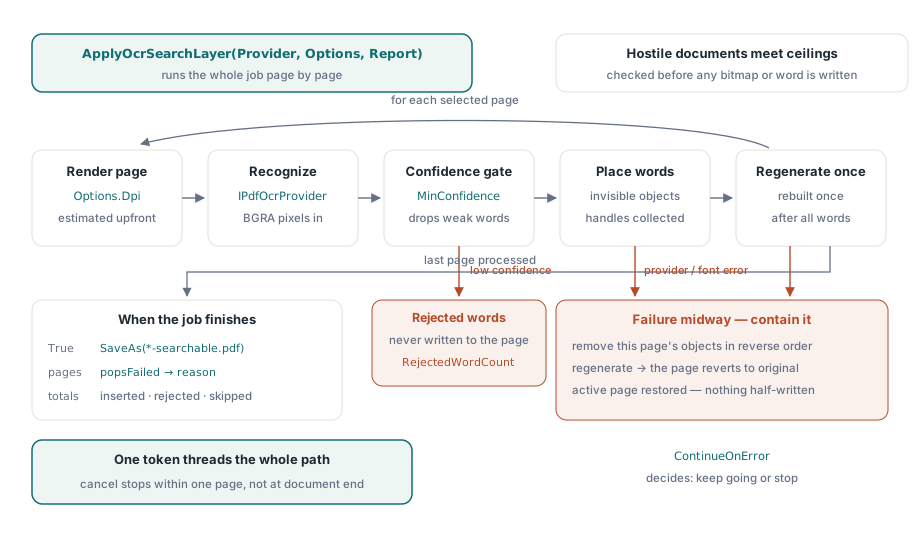
Toda cantidad que un documento hostil o sencillamente enorme pueda inflar tiene un techo en TPdfOcrOptions, y las comprobaciones de píxeles se ejecutan antes de asignar mapa de bits alguno. El tamaño de renderizado es Ceil(PageWidth * Dpi / 72) por Ceil(PageHeight * Dpi / 72), así que los números se pueden calcular por adelantado:
| Página a 300 DPI | Mapa de bits | Píxeles |
|---|---|---|
| US Letter, 612 × 792 pt | 2550 × 3300 | 8,415,000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8,702,320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17,415,167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139,493,228 |
Los valores por defecto son 100 millones de píxeles por página y 1000 millones para el trabajo entero. Un plano A0 a 300 DPI supera por sí solo MaxPixelsPerPage. El presupuesto de todo el trabajo se agota antes que el por página: a 8.415.000 píxeles por página Letter, 118 páginas caben bajo 1000 millones y la página 119 falla con un mensaje que nombra MaxTotalPixels, y con ella todas las siguientes. Para archivos escaneados largos, subid MaxTotalPixels como hace el ejemplo de arriba, o dividid el trabajo en rangos con FirstPage y LastPage. Las páginas saltadas nunca se renderizan y no cuentan. El adaptador de Tesseract incluido añade su propio límite, TPdfTesseractOptions.MaxPixels, que vale 16.777.216 por defecto; una hoja A3 a 300 DPI queda justo por encima, así que los lotes A3 necesitan subir el límite del adaptador o bajar los DPI
Los DPI deben estar entre 36 y 1200. Doblarlos de 300 a 600 cuadruplica el mapa de bits, y cada píxel cuesta 4 bytes, así que una página Letter pasa de unos 34 MB de BGRA a unos 135 MB. Para escaneados de oficina corrientes, 300 DPI equilibra calidad de reconocimiento contra memoria; 600 merece la pena para letra pequeña y notas al pie, no para archivos enteros. Los recuentos de palabras tienen techo en MaxWordsPerPage y MaxTotalWords, y un proveedor que devuelva más palabras de las que la página permite tumba esa página en lugar de quedarse truncado
El token de cancelación alcanza el renderizado progresivo, la llamada al proveedor y el bucle que inserta palabras. Cancelar durante el reconocimiento de la página 212 de un archivo de 400 se detiene en la página 212, siempre que el proveedor honre el token que le entregaron. El adaptador de Tesseract va un paso más allá y registra un callback de cancelación con el motor, junto a un timeout por página de 60.000 ms por defecto
La contención es por página. La capa guarda el handle de cada objeto de texto que inserta y llama a FPDFPage_GenerateContent una vez, tras colocar la última palabra de esa página. Si algo falla en medio, una fuente que rechaza un carácter o una cancelación que llega a mitad de bucle, los objetos ya insertados en esa página se retiran en orden inverso y el contenido de la página se regenera, de modo que la página vuelve a llevar solo lo que tenía antes. El bucle continúa o se detiene según ContinueOnError, y la página que estuviera activa antes de la llamada vuelve a estarlo después
Comprobar el resultado
Dos comprobaciones cubren la mayor parte de lo que puede salir mal. La primera es visual: renderizad una página del archivo original y la misma página del archivo procesado al mismo tamaño con TPdf.RenderPage, y comparad los mapas de bits. Lo esperado: idénticos, porque el modo 3 no pinta nada y el stream de imagen no se tocó; cualquier diferencia de píxeles significa que algo distinto de la capa de texto cambió la página. La segunda comprueba que las palabras existen y están donde el escaneado las muestra:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Elegid una palabra sonda que podáis localizar a ojo en el escaneado, un encabezado o un total, y comparad las coordenadas informadas con su posición en una imagen renderizada. En la página con CropBox de la apertura, el valor x debería empezar en 36 o más, nunca cerca de cero. El lado de la extracción se cubre con más profundidad en extraer texto de documentos PDF, el renderizado de páginas para una superposición de alineación en convertir páginas PDF a JPEG, y el patrón de token usado por todas partes en renderizado progresivo cancelable
La superposición de OCR convive con el renderizado, la extracción de texto y la edición de páginas en el mismo objeto TPdf, en Delphi, C++Builder y Lazarus. Las ediciones y la lista completa de la API están en la página de producto de PDFium Component para Delphi