Con la comprobación de desbordamiento apagada, 2000000000 + 2000000000 evalúa a -294.967.296 cuando ambos operandos son valores Integer de Delphi. Ese número deja de ser una curiosidad en el momento en que un parser de contenedores lee un offset y una longitud de una cabecera de registro y los suma para ver si un PDF incrustado cabe dentro del búfer. La suma se envuelve a negativo, la comparación contra Length(Data) pasa, y la línea siguiente toma la dirección de un byte unos dos gigabytes más allá del final del array. Cargar un PDF desde el medio de un búfer mayor necesita una comprobación de rango que nunca sume, y una respuesta clara a quién le pertenecen los bytes una vez el documento está abierto
Este artículo cubre documentos que ya están en RAM, situados en un offset conocido dentro de otra cosa. Los documentos demasiado grandes para mantener en memoria son otro problema, resuelto tirando bloques de disco bajo demanda como describe el streaming de PDF grandes bajo demanda con PDFium VCL. La última sección traza la línea
Un PDF incrustado en un offset conocido
Un almacén de correo guarda cuerpos de mensaje y adjuntos en un registro. Un contenedor de archivo concatena un manifiesto, unas imágenes y un PDF. Un protocolo de red personalizado enmarca un documento detrás de una cabecera con prefijo de longitud. Supón que el registro es de 40 MB, el PDF empieza en el byte 1.182.336 y dura 312 KB. El código habitual llama a Copy(Data, Index, Count) para cortar una rebanada, y luego le entrega esa rebanada a un loader que la copia otra vez a su propio búfer. Contando el contenedor, los mismos 312 KB existen ahora tres veces, y un escaneo de buzón repite eso por cada mensaje
PDFium Component direcciona la ventana directamente. TPdf declara LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True), donde Index es una posición de byte de base cero y Count una longitud en bytes. El método valida ambos números, calcula un único puntero, y reenvía a la sobrecarga con puntero LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean), que abre el documento a través de FPDF_LoadMemDocument64. La forma de array completo LoadDocument(const Data: TBytes; Buffered: Boolean) es una llamada de una línea a la forma de rango de bytes con 0 y Length(Data), así que cada carga de TBytes pasa por la misma validación
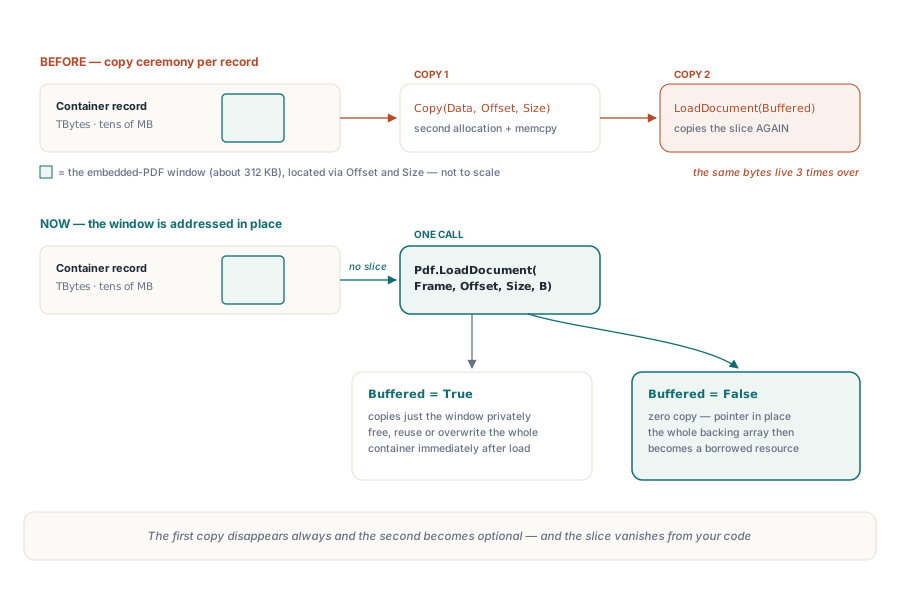
En código, la rebanada sencillamente desaparece. LocateEmbeddedPdf representa a tu propio parser de contenedores
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // registro contenedor completo, decenas de megabytes
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // tu parser, no forma parte del componente

  Pdf := TPdf.Create(nil);
  try
    // No hay Copy(Frame, Offset, Size): la ventana se direcciona en su sitio
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered vale True por defecto
    Frame := nil;  // bien aquí: solo se copió la ventana del PDF
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // cierra el documento
  end;
end;
Cuando el EnableV8Engine global sigue en False y la librería PDFium aún no se ha cargado, los loaders de memoria escanean los bytes de entrada buscando marcadores XFA y activan EnableV8Engine si encuentran alguno, para que se cargue la DLL con capacidad V8. Con la llamada de rango de bytes ese escaneo solo ve la ventana. Un manifiesto o un segundo documento en otra parte del mismo registro no pueden dispararlo
¿Por qué Index más Count desborda la comprobación de límites?
Porque Index y Count son ambos valores Integer con signo de 32 bits, y sumar dos positivos grandes no produce de forma fiable un resultado positivo grande. Cuando el offset y la longitud vienen de una cabecera de fichero, un atacante o un registro corrupto controla ambos. La misma trampa espera en tu propio parser de contenedores, que calcula esos números primero
// Un helper para tu propio parser de contenedores (sugerido, no forma parte del componente)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // MAL: Index + Count se evalúa como Integer y puede envolverse a negativo
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // BIEN: rechaza los signos, acota Index por su cuenta, y luego compara Count
  // contra el resto; la única aritmética es una resta que no puede envolverse
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;
Recorre el caso que falla. Con Index = 2000000000 y Count = 2000000000, la suma real es cuatro mil millones, pero la aritmética con signo de 32 bits la guarda como -294.967.296. Ese valor está cómodamente por debajo de cualquier Length(Data), así que la comprobación equivocada pasa y @Data[Index] apunta muy fuera del array, con una longitud de dos gigabytes colgada. Un crash es el buen desenlace. El malo es que PDFium parsee la memoria de proceso que casualmente viva ahí
El orden correcto nunca suma. Los valores negativos se rechazan antes de indexar nada. Index se acota después contra Length(Data) solo, lo que garantiza que Length(Data) - Index es un Integer no negativo, y solo entonces se compara Count con ese resto. Delphi evalúa and con lógica de cortocircuito por defecto ({$B-}), así que cada término posterior solo se ejecuta cuando los anteriores se cumplen. No te apoyes en {$Q+} como red de seguridad: los builds de release se distribuyen rutinariamente con la comprobación de desbordamiento apagada, y con ella encendida solo has cambiado un agujero de seguridad de memoria por un EIntOverflow escapando del medio de una rutina de validación
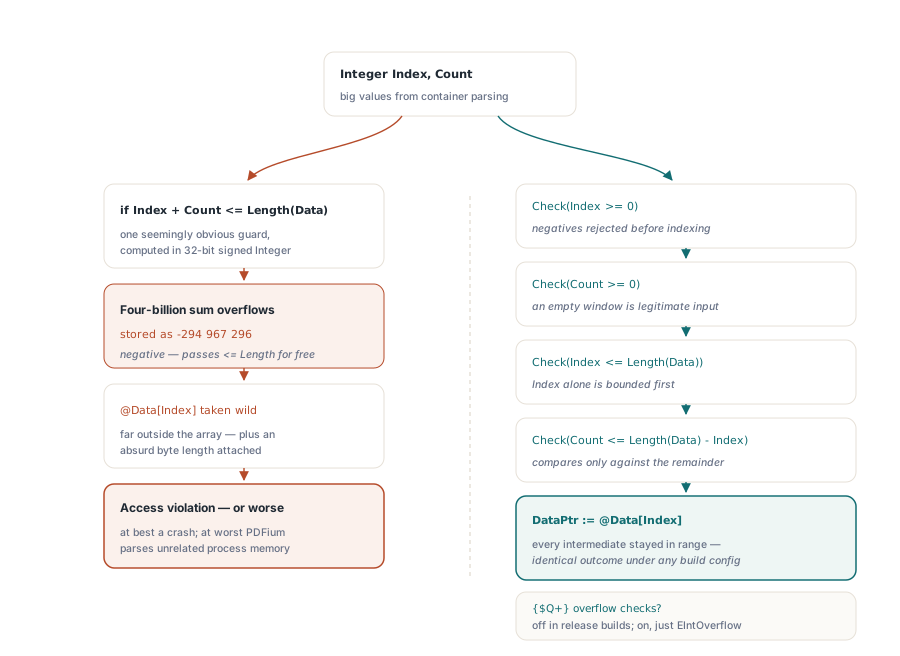
El LoadDocument de rango de bytes ejecuta las mismas cuatro pruebas en el mismo orden y lanza EPdfError con un mensaje que nombra la regla fallada: "PDF byte range index cannot be negative", "PDF byte range count cannot be negative", "PDF byte range index exceeds data length" y "PDF byte range exceeds data length". Puedes reproducir cada una con un array de cuatro bytes. Index = 5, Count = 0 dispara el tercer mensaje, Index = 2, Count = 3 dispara el cuarto, y tras cada rechazo Pdf.Active sigue siendo False. El mismo tratamiento de longitudes no confiables a través del límite nativo está cubierto más ampliamente en reforzar el ABI de PDFium VCL y la seguridad de memoria en Delphi
Una ventana de longitud cero sigue siendo una llamada legal
Una ventana vacía pasa un puntero nil, porque @Data[Index] no es una expresión legal para todo Index que la validación acepta. Index = Length(Data) con Count = 0 es una ventana vacía bien formada al final del búfer, y un TBytes vacío da Index = 0 sobre un array que no tiene elemento cero. Tomar la dirección en cualquiera de los dos casos lee más allá del final o desreferencia un array dinámico nil, y con la comprobación de rango activada, Delphi lanza ERangeError antes incluso de que el loader se ejecute
Así que la sobrecarga de rango de bytes se bifurca: Count = 0 produce nil, cualquier otro recuento produce @Data[Index]. La sobrecarga con puntero acepta nil solo junto a un tamaño de cero, PDFium entonces declina abrir un búfer vacío, y la llamada acaba en un EPdfError ordinario con el texto de último error de PDFium, o "Cannot load PDF document" cuando PDFium no reporta ninguno. Una cabecera que afirma un adjunto de cero bytes recibe la misma excepción capturable que cualquier otra entrada errónea. Rechazarla en tu parser, con el número de registro en el mensaje, sigue leyéndose mejor en un log de soporte
Buffered decide quién es dueño de los bytes
Buffered es el único parámetro de aquí cuyas consecuencias sobreviven a la llamada. Con Buffered = True, el componente copia la ventana seleccionada, y solo la ventana, a su propio búfer antes de cargar. En el ejemplo de 40 MB se copian 312 KB y el contenedor se queda quieto. Una vez que LoadDocument devuelve, puedes liberar, reutilizar o sobrescribir el contenedor inmediatamente
Con Buffered = False, @Data[Index] va directo a FPDF_LoadMemDocument64, y PDFium sigue leyendo a través de ese puntero mientras el documento esté abierto. Todo el TBytes de respaldo pasa a estar prestado. Tiene que seguir vivo y sin modificar hasta que pongas Active := False o liberes el TPdf. Importa el array entero, no solo la ventana: un array dinámico de Delphi tiene recuento de referencias como un solo bloque, así que soltar la última referencia en cualquier parte de tu código libera la memoria que PDFium sigue leyendo. SetLength es igual de fatal. Una reasignación puede mover el bloque
Dos detalles de Delphi hacen esto más fácil de equivocar de lo que parece. Los arrays dinámicos no tienen copy-on-write, a diferencia de las strings, así que Other := FFrame; Other[0] := 0; escribe en los mismos bytes que PDFium está parseando. Y un búfer de recepción que tu código de red reutiliza para la siguiente trama se sobrescribe bajo el documento abierto. Pasar un resultado de función directamente, como en Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False), deja el array sostenido solo por un temporal oculto que muere con la rutina llamante, mientras el documento sigue vivo
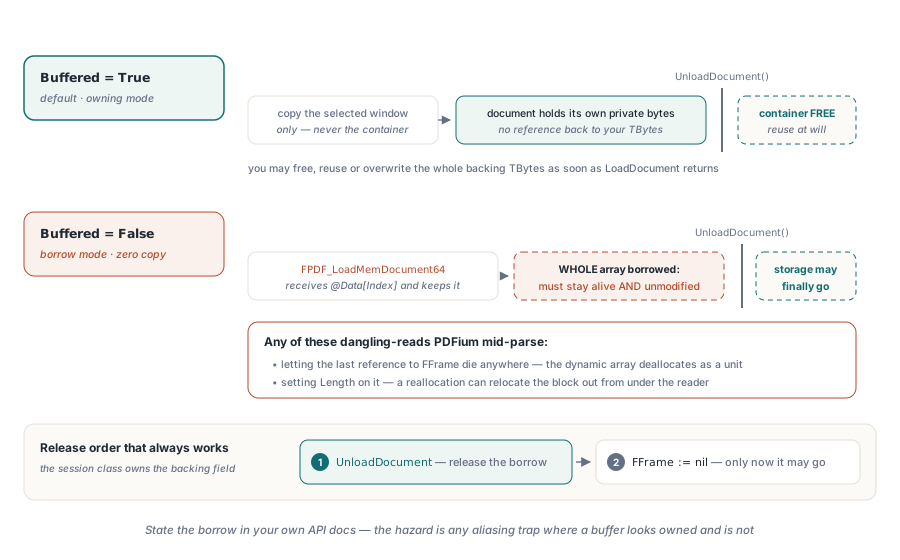
Deja Buffered = True para todo lo que cruce un hilo, viva detrás de un búfer reutilizable, o sobreviva a la rutina que lo cargó. El coste extra es una copia del tamaño del propio PDF, y compra la libertad de soltar un registro de 40 MB en el momento en que la llamada devuelve. Tomar prestado gana su sitio solo cuando el contenedor ya es un campo de vida larga que sostienes durante toda la sesión de todos modos, como un visor que mantiene un registro de archivo abierto mientras el usuario hojea el adjunto. En ese caso, haz la propiedad explícita en una sola clase
type
  TFrameSession = class
  private
    FFrame: TBytes;   // es dueño del almacenamiento subyacente mientras FPdf tenga un documento abierto
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // comparte el array; nadie más puede escribir en él ahora
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // cierra antes cualquier ventana previa
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame debe sobrevivir a este documento
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. libera el préstamo
  FPdf.Free;
  FFrame := nil;         // 2. solo ahora puede irse el almacenamiento
  inherited;
end;
El constructor comparte el array del llamante en lugar de copiarlo, así que el llamante tiene que dejar de escribir en él. Si no puedes prometerlo, pasa Copy(AFrame) al constructor y vuelves a una copia, hecha una vez por sesión en lugar de una por carga
Comprobar que la ventana empieza en %PDF-
Una ventana desplazada unos bytes es el fallo sutil, porque el documento puede seguir abriendo. La ISO 32000-1 §7.5.4 define cada entrada de la tabla de referencias cruzadas como un offset de byte desde el principio del fichero, y §7.5.2 pone la cabecera %PDF- al inicio. Cuando tu parser cuenta mal un prefijo y la ventana empieza ocho bytes antes, esos offsets están ocho bytes desplazados. PDFium busca la cabecera dentro de los primeros 1024 bytes y compensa la basura inicial; una ventana que empieza tarde o acaba pronto puede empujarle a reconstruir la tabla de referencias cruzadas desde los marcadores de objeto que encuentra. En cualquier caso el recuento de páginas parece correcto. El offset de tu parser sigue estando mal, y el próximo lector de ese registro puede ser menos indulgente
La sobrecarga LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) hace eso visible. Report.HeaderOffset es dónde se encontró %PDF- dentro de los primeros 1024 bytes de la ventana, o -1 cuando no se encontró. Report.UsedRecovery es True cuando PDFium no aceptó la tabla de referencias cruzadas como válida. Todos los offsets del reporte cuentan desde el primer byte de la ventana, no desde el contenedor. Un Count demasiado corto corta el %%EOF final, y TPdfLoadOptions.Default(plmStrict) activa RequireFinalEndOfFileMarker, así que el modo estricto rechaza esa ventana sin más
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning es tu rutina de registro
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
La auditoría detrás de esos campos tiene un coste que importa para las cargas prestadas. Cuando la ventana cabe dentro de Options.AuditByteLimit (256 MB por defecto), la auditoría lee una copia temporal de la ventana, así que Buffered = False combinado con un reporte deja de estar libre de copias durante la carga. Poner AuditByteLimit a 0 se salta la auditoría y la copia, y deja HeaderOffset en -1. Usa la forma auditada mientras desarrollas el parser de contenedores y contra fuentes nuevas de registros; pásate a la sobrecarga simple una vez los offsets son de confianza. El resto del reporte está cubierto en capturar fallos de carga de PDF con un reporte de carga de PDFium
Cuándo un rango de bytes es la herramienta equivocada
La sobrecarga de rango de bytes asume que el contenedor entero ya está en memoria, y como Count es un Integer, una ventana no puede superar MaxInt bytes. Un archivo de 6 GB en disco, o un socket que no puedes rebobinar, no encaja en esa forma, y leerlo todo a TBytes solo para direccionar una ventana dentro anula el propósito. Para esos casos LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) deja que PDFium tire bloques de un stream posicionable bajo demanda. Un pequeño descendiente de TStream tuyo que sume el offset de inicio del PDF a cada Seek presenta el documento incrustado como si empezara en la posición cero, como muestra el artículo de streaming bajo demanda
El otro desajuste es contenido que aún no es un PDF plano. Si los bytes incrustados están comprimidos, cifrados por el contenedor, o envueltos en otra codificación, una copia transformada es inevitable, y cargar ese array nuevo con el Buffered = True por defecto es la respuesta directa. El rango de bytes compensa en una forma: bytes de PDF contiguos, sin modificar, ya residentes, en un offset que tu parser validó sin sumar
La llamada de rango de bytes se sienta al lado de la carga por fichero, stream, puntero crudo y bajo demanda en el mismo componente TPdf. La página del producto PDFium Component lista las versiones de Delphi y C++Builder soportadas, las opciones de licencia y el resto de la API de carga