Una tabla que atraviesa tres páginas de una exportación de Word nunca se acerca a menos de 72 puntos del borde inferior del papel. Los márgenes de una pulgada son 72 puntos, y el procesador deja de colocar filas en el margen. Un enlazador que une fragmentos solo cuando se sitúan a 36 puntos de los bordes de página ve tres tablas sin relación con columnas idénticas. La pregunta que funciona es otra: ¿hay algo aparte de una cabecera o pie de página corriente entre el final de un fragmento y el inicio del siguiente?
Esa pregunta trae dos trampas propias. Un formulario puede acabar una tabla al final de la página 1 y abrir otra tabla distinta con los mismos anchos de columna en lo alto de la página 2. Y una rejilla con líneas puede empujar una sola fila al otro lado del salto, demasiado corta para un detector que quiere dos filas antes de llamar tabla a algo
Dos pruebas de borde en ExtractDocumentTables
PDFium Component marca continuaciones en TPdf.ExtractDocumentTables, el homólogo a nivel de documento del ExtractTables por página cubierto en el artículo de detección y extracción de tablas. Con DetectContinuations activo, como está en TPdfTableExtractionOptions.Default, el método extrae todas las páginas, ordena las tablas por número de página y después de arriba abajo dentro de cada página, y comprueba cada par de vecinos de esa lista. Solo se comparan vecinos. Un candidato a continuación es por tanto siempre la tabla más baja de la página N emparejada con la más alta de la página N+1, y una tabla pequeña colocada bajo una larga en la página N ocupa el lugar de la larga en ese emparejamiento. Cuando una tabla de notas corta se sienta debajo de una larga, enlaza esos fragmentos en tu propio código a partir de números de página y ColumnCount
La primera prueba es puramente geométrica. El borde inferior del fragmento anterior debe quedar a menos de ContinuationMargin puntos del borde inferior de la página, y el borde superior del fragmento posterior a la misma distancia del borde superior de la página siguiente. El valor por defecto es 36 puntos, media pulgada. Los informes de motores de layout que rellenan una caja de contenido fija lo pasan con facilidad. Una exportación de Word con márgenes de una pulgada falla por al menos 36 puntos a cada lado, y agrandar el margen hasta que pase sale mal, porque el mismo número fija las bandas de cabecera y pie de la segunda prueba
Esa segunda prueba, la que mira el contenido, es la que maneja la salida de procesadores de texto. Las dos se combinan con OR: cualquiera de las dos abre la puerta
¿Qué cuenta como texto entre dos fragmentos?
Toda palabra de una página cuenta como texto del cuerpo salvo que yaga por completo dentro de la banda de cabecera corriente o de la de pie, y ambas bandas tienen ContinuationMargin puntos de profundidad. Por página, ExtractDocumentTables registra el borde inferior más bajo entre las palabras cuyo top está por encima de la banda de pie y el borde superior más alto entre las palabras cuyo bottom está por debajo de la banda de cabecera, incluido el texto de celda de la propia tabla. Cuando la tabla es el último contenido de cuerpo de la página N, su borde inferior queda en o por debajo de la palabra más baja, y la prueba pasa dentro de AlignmentTolerance, que por defecto son 3 puntos. El fragmento posterior tiene que cumplir la condición espejo en lo alto de la página N+1
Ignorar las bandas tiene base en la especificación. ISO 32000-1 §14.8.2.2 trata las cabeceras, pies y números de página corrientes como artefactos de paginación, contenido que existe solo porque el documento se cortó en páginas. Un archivo con tags puede declararlos con /Artifact, como explica el artículo de marked content, pero las exportaciones que más necesitan coser tablas rara vez llevan tags, así que la posición hace de tag. Con la banda por defecto, un número de página cuyos glifos se quedan a 30 puntos del borde inferior se ignora. Una línea de disclaimer que llega a 40 puntos es texto del cuerpo, y bloquea el enlace
En una página sin capa de texto, los extremos guardados caen a los límites de página, la prueba de contenido pasa trivialmente, y deciden las demás puertas. Los pies dibujados como imágenes o contornos vectoriales son invisibles por la misma razón y jamás bloquean un enlace
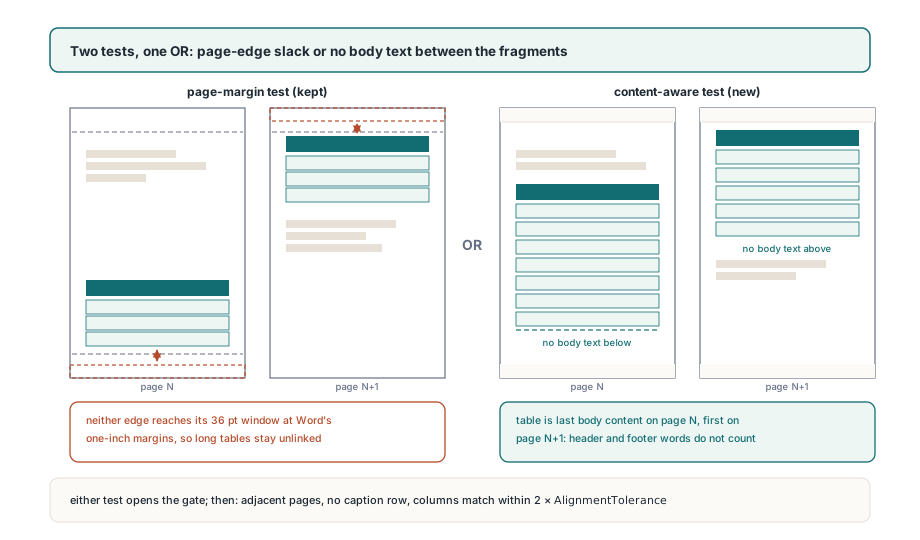
Pasar una prueba de borde solo abre la puerta. Las páginas tienen que ser consecutivas, el fragmento posterior no debe abrir con una fila de caption, y los límites de columna tienen que alinearse dentro del doble de AlignmentTolerance, 6 puntos con los valores por defecto. Cuando todo eso se cumple, el fragmento anterior se convierte en ptcStart con un número de grupo nuevo, o pasa de ptcEnd a ptcMiddle si ya cerraba una cadena, y el fragmento posterior se convierte en ptcEnd del mismo grupo. Una tabla repartida en tres páginas lee start, middle, end. Los números de grupo empiezan en 1; el grupo 0 con ptcNone significa que la tabla va sola. ToJson escribe los mismos datos como "continuationGroup" y "continuation" (none, start, middle o end), así que un servicio que recibe JSON puede coser por su cuenta
El listado de abajo asume una exportación de Word con un pie de dos líneas de unos 50 puntos de profundidad, así que el margen sube a 54 para mantener ambas líneas dentro de la banda
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // footer assumed ~50 pt deep

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
Cómo una primera fila a todo ancho mantiene dos tablas separadas
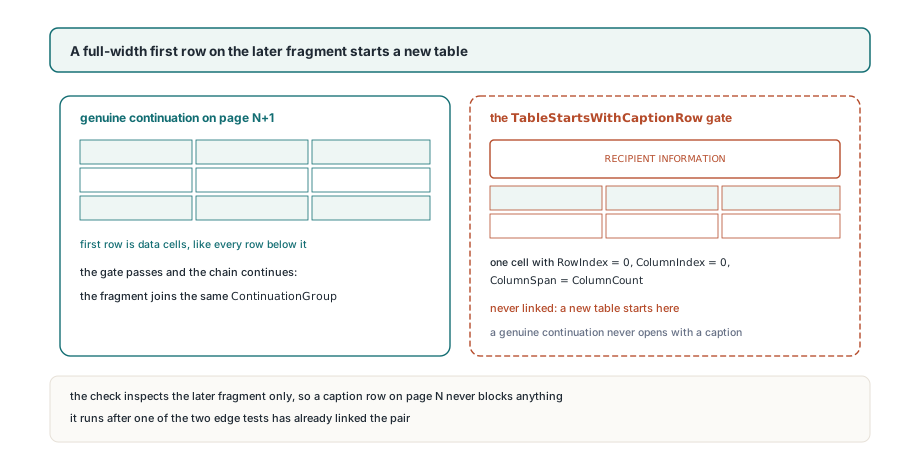
Un fragmento posterior cuya primera fila es una sola celda que abarca todas las columnas se reporta como tabla nueva, aun cuando pase una prueba de borde y las columnas coincidan. Los formularios son donde la prueba de contenido se pasaría de la raya: una tabla acaba cerca del final de la página 1, la siguiente sección abre en la página 2 con anchos de columna idénticos, y todas las comprobaciones geométricas pasan. La diferencia es la fila de apertura de la segunda tabla, un caption de sección como RECIPIENT INFORMATION dispuesto como una celda combinada a todo el ancho. Una continuación de verdad no abre así, porque el caption de una tabla se queda en la página donde la tabla empieza
La regla lee solo las celdas del fragmento posterior. Ese fragmento necesita al menos dos columnas y una celda con RowIndex = 0, ColumnIndex = 0 y ColumnSpan = ColumnCount. El fragmento anterior jamás se inspecciona, así que una tabla cuyo propio caption se sienta en lo alto de la página N enlaza normalmente con su continuación en la página N+1
La comparación de columnas que viene después es más estricta que un conteo de columnas igual. Las posiciones de frontera de cada fragmento se reconstruyen a partir de sus rectángulos de celda; una frontera escondida bajo una celda combinada se rellena repartiéndola uniformemente entre las fronteras conocidas más cercanas de cada lado. Después se compara cada par de fronteras, y una diferencia por encima de 6 puntos rechaza el enlace. Dos tablas de cuatro columnas con proporciones distintas se quedan separadas. Igual que una continuación real cuyo generador movió una columna 8 puntos entre páginas; subir AlignmentTolerance para aceptarla afloja también el clustering usado durante la detección
Una fila con líneas al otro lado de un salto de página
Una rejilla con líneas que empuja una sola fila a la página siguiente conserva esa fila cuando se enlaza en una cadena y la pierde cuando no. El MinRows por defecto de 2 evita que un par de líneas sueltas se reporten como tabla. Una fila empujada al otro lado del salto es distinta: son datos de verdad, y soltarla dejaría la tabla cosida una fila corta sin ningún fragmento que explique el hueco
El escaneo del documento lo maneja en tres pasos. Con DetectContinuations y DetectRuledTables ambos activos, el detector de rejillas corre sobre cada página con su suelo de filas bajado a 1. Las continuaciones se marcan entonces sobre el resultado entero. Por último, toda tabla con menos filas que el MinRows del llamador que no acabara en una cadena se elimina. Una rejilla de una fila en medio de una página corriente pasa por ese filtro y desaparece, que es exactamente para lo que está el MinRows
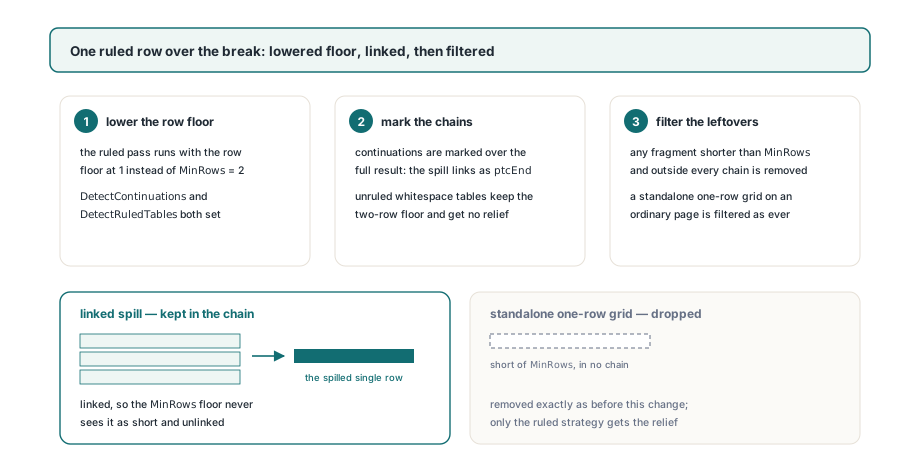
Deja el MinRows en 2. Ponérlo a 1 tú mismo apaga el filtro final, y toda rejilla de una fila de todas las páginas vuelve
La excepción aplica solo a rejillas con líneas. La estrategia de espacio en blanco necesita al menos dos filas alineadas para reconocer una tabla, así que mantiene un suelo interno de 2 diga lo que diga el MinRows; ExtractTables acepta MinRows = 1, pero solo la detección con líneas lo honra. Para una tabla sin líneas que derrama una fila, las word boxes de la página o los blocks descritos en structured text blocks y orden de lectura te dan las posiciones para recuperar esa fila por tu cuenta
Volver a coser una cadena en una sola tabla
Las cadenas vuelven contiguas. Los enlaces solo se hacen entre vecinos del array ordenado, así que a un fragmento ptcStart le siguen directamente sus fragmentos ptcMiddle y ptcEnd, y un bucle que se resetea con ptcNone o ptcStart y escribe con ptcNone o ptcEnd jamás tiene que buscar nada por número de grupo
La fila de cabecera repetida es la parte delicada: Word puede repetirla en cada página, otros generadores no. El flag IsHeader de TPdfTableCell no puede resolverlo, porque se asigna por posición, RowIndex < HeaderRowCount, por separado para cada fragmento. La fila 0 de una continuación se marca como cabecera tanto si repite la cabecera como si lleva datos, y el derrame de una fila de la sección anterior también. La rutina de abajo compara el texto de la primera fila de cada continuación con la primera fila de la cadena y la suelta solo cuando coincide exactamente
También construye las filas desde Cells en lugar de partir la salida de ToCsv en líneas. Una celda cuyo texto envuelve dentro de la celda vuelve con un CR LF entre sus líneas visuales, ToCsv conserva ese salto dentro del campo entrecomillado, y borrar la primera línea del texto CSV cortaría por la mitad una celda de cabecera de dos líneas
// Helpers de lado lector (no forman parte de la biblioteca): reconstruye cada cadena
// como un archivo separado por tabs, soltando cabeceras repetidas en páginas posteriores
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // cabecera repetida en esta página
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
La comparación exacta es la decisión correcta. Una cabecera repetida por el procesador de texto coincide carácter a carácter, mientras que una coincidencia difusa acabaría tragándose una fila de datos que se parezca a la cabecera. Una cabecera extra suelta se ve fácil en la salida; una fila de datos ausente no
Medir la banda de pie en lugar de adivinar
ContinuationMargin hace tres trabajos con un solo número: holgura de borde de página para la primera prueba, profundidad de banda de pie y profundidad de banda de cabecera para la segunda. Un pie más profundo que la banda deja su línea superior en la zona de cuerpo, el fragmento anterior parece tener texto detrás, y la cadena se rompe en esa página. Una banda puesta demasiado profunda acaba tragándose contenido real: una línea de cierre corta justo encima del margen inferior cae dentro, y la tabla por encima de esa línea puede entonces enlazar con lo que sea que abra la página siguiente
El propio documento puede suministrar el número. TPdf.PageWordBoxes devuelve cada palabra de la página actual con un Rect en espacio de página cuyo Top es mayor que su Bottom, así que el Top más alto entre las palabras que yacen por debajo del margen del cuerpo es la profundidad del pie. La sonda de abajo toma un valor justo por debajo del margen inferior del layout, 70 para una página de una pulgada, y mantiene 36 puntos como suelo para documentos sin pie
// Helper de lado lector (no forma parte de la biblioteca): el top de palabra más alto
// hallado por debajo de BodyMargin en cualquier página, o sea la profundidad de la zona de pie
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// usa System.Math para Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
La banda tiene la misma profundidad en ambos bordes, así que mide también una cabecera corriente profunda contra el borde superior de la página y quédate con el valor mayor. Mantén la holgura en un par de puntos; cada punto extra es un punto de texto del cuerpo que la prueba de contenido deja de ver
Un layout vence a la regla del caption por construcción: un generador que escribe un banner de "continued" combinado como primera fila de cada fragmento de continuación. Cada uno de esos fragmentos se reporta como tabla nueva, así que enlázalos en tu propio código a partir de números de página consecutivos, el mismo ColumnCount y el texto del banner en la fila 0
El marcado de continuaciones, la regla del caption y la excepción de una fila corren todos dentro de ExtractDocumentTables, que se comporta igual en los builds Delphi, C++Builder y Lazarus. El juego completo de opciones de extracción de tablas está listado en la página de PDFium Component for Delphi