El objeto número 1 no es la página 1. Ese único hecho hace tropezar a más código de procesamiento de PDF que cualquier otra parte del formato, y el motivo solo se ve cuando dejas de mirar lo que un visor renderiza y empiezas a mirar el grafo de objetos que el visor lee de verdad
Un archivo PDF es una colección de objetos indirectos numerados. Cada uno lleva un número de objeto y un número de generación, y otros objetos le apuntan con una referencia escrita como N G R — 3 0 R significa la versión actual del objeto 3. Las páginas son objetos como cualquier otro, pero dónde se sitúan en el archivo y qué números llevan no dicen nada sobre el orden de visualización. El orden viene del árbol /Pages. Recorre los objetos en orden numérico y montarás las páginas en la secuencia equivocada para una buena parte de los archivos reales
El árbol es también donde vive mucho comportamiento menos obvio. Su forma decide lo rápido que un visor puede saltar a la página 8.214, sus nodos interiores le pasan en silencio el tamaño de página y las fuentes a las hojas de debajo, y los totales de /Count que hacen rápida toda la estructura no los impone nada en absoluto. Veremos las tres cosas, empezando por el orden mismo
El árbol de páginas decide el orden
Todo PDF tiene un catálogo de documento (ISO 32000-2 §7.7.2), y la entrada /Pages del catálogo apunta al nodo raíz del árbol de páginas. Esa raíz es un diccionario con /Type /Pages, un array /Kids de referencias indirectas y un /Count con el número de páginas hoja debajo. El orden de visualización es un recorrido en profundidad, de izquierda a derecha, de ese árbol. Esa es toda la regla
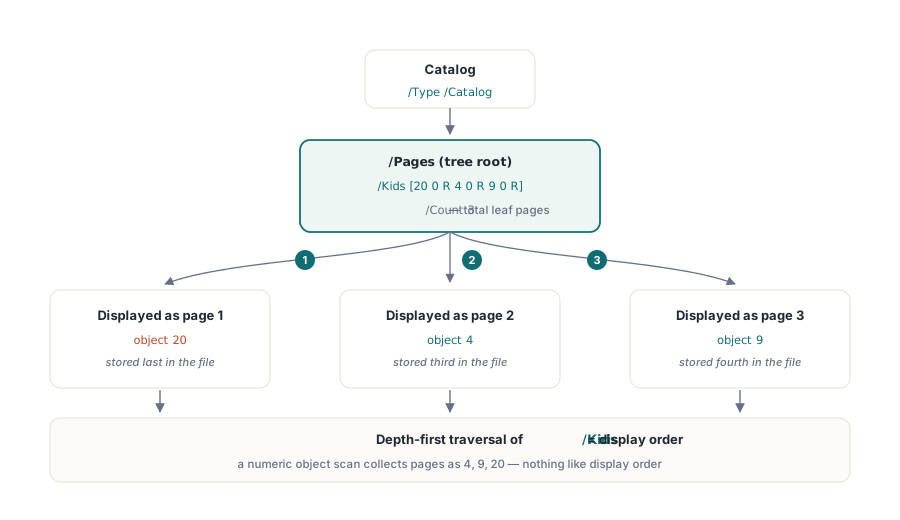
Un archivo mínimo de tres páginas lo hace concreto:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% El objeto 4 está guardado tercero en el fichero pero es la página 2 en orden de visualización
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% El objeto 9 está guardado cuarto pero es la página 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% El objeto 20 está guardado el último pero es la página 1; decide Kids[0], no el número de objeto
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
El array /Kids dice [20 0 R 4 0 R 9 0 R], así que el objeto 20 es la página 1, el objeto 4 es la página 2 y el objeto 9 es la página 3. Un código que itera los objetos en orden numérico y recoge todo lo que lleva /Type /Page se equivoca con este archivo. Peor aún, la salida sigue pareciendo plausible: recuento de páginas correcto, contenido reconocible en cada página, secuencia equivocada
Los generadores producen disposiciones así por razones ordinarias. Una biblioteca que reserva los números de objeto de todas las páginas por adelantado los asigna en orden de creación y luego escribe los bytes en el orden que le convenga a su serializador. Una herramienta de fusión renumera los objetos de cada documento de origen para evitar colisiones, así que los objetos de página acaban dispersos por la tabla de objetos combinada mientras que el nuevo array /Kids de la raíz guarda la secuencia correcta. Y las actualizaciones incrementales añaden objetos nuevos al final del archivo con números frescos, así que una página añadida en una revisión vive cerca del final del flujo de bytes aunque pertenezca a la posición 1
El último caso es el que muerde. Un corpus de pruebas producido por una sola herramienta puede pasar entero, y luego los archivos de un flujo de fusión, o los documentos que pasaron por unas cuantas revisiones, salen barajados. Los arreglos heurísticos no se sostienen, porque el fallo depende del generador y del historial de ediciones del archivo. El arreglo de verdad es corto: empieza en el catálogo, resuelve /Pages, recorre /Kids recursivamente y emite las hojas en el orden en que las encuentres. Nuestro caso práctico de depuración del orden de páginas sigue exactamente este síntoma a través de un diagnóstico equivocado hasta su causa raíz, con el código de recorrido recursivo y los pasos qpdf para comprobar el resultado
El fan-out es una decisión de rendimiento
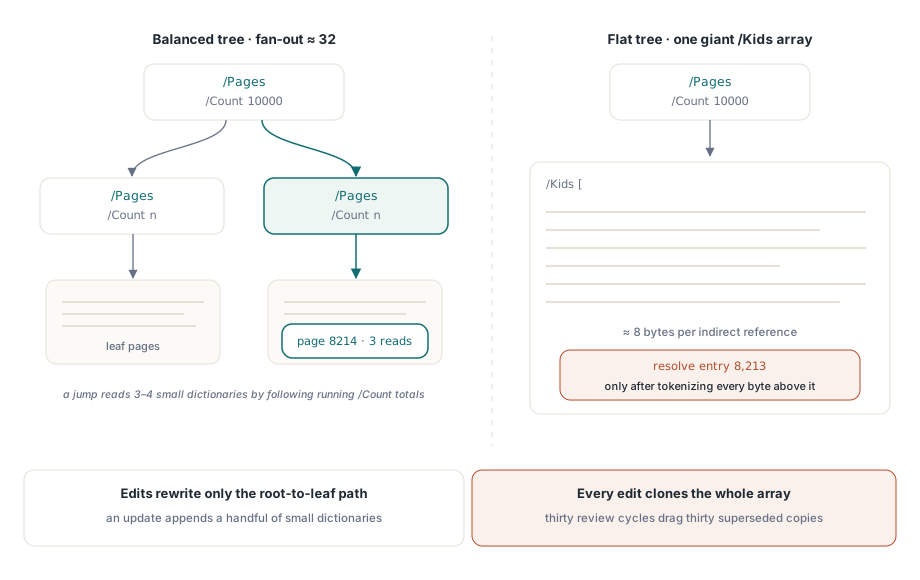
La especificación permite dos formas. Los generadores sencillos emiten un árbol plano, un nodo raíz /Pages cuyo /Kids no contiene más que hojas /Page. Nada obliga a un generador a anidar, y un documento de 10.000 páginas con 10.000 referencias hoja en un solo array cumple. Aun así, el PDF Reference recomienda un árbol equilibrado para documentos grandes, y los generadores más habituales siguen ese consejo con un fan-out moderado — normalmente unas pocas docenas de hijos por nodo intermedio, donde cada nodo intermedio tiene su propio /Kids y su propio /Count
La razón está en lo que un visor debe leer antes de poder mostrar nada. Tomemos un salto directo a la página 8.214 de ese archivo de 10.000 páginas. Con un árbol plano, el visor primero tiene que analizar la raíz, y esa raíz es un array enorme: con aproximadamente ocho bytes por referencia indirecta, un objeto de 80 KB que debe tokenizarse de principio a fin antes de que la entrada 8.213 se resuelva. Con un árbol equilibrado de fan-out 32, el mismo salto lee la raíz, compara los totales acumulados de /Count para elegir el hijo correcto, y desciende. Tres o cuatro diccionarios pequeños, unos pocos cientos de bytes cada uno. Ese acceso aleatorio O(log n) es lo que el árbol fue diseñado para proporcionar, y es toda la razón de que /Count exista en los nodos intermedios: un lector puede saltarse todo un subárbol sin abrir ni un solo objeto dentro de él
La forma del árbol también fija el coste de editar. Una actualización incremental que inserta una página debe reescribir todos los nodos cuyo /Kids o /Count haya cambiado, es decir, la ruta desde el padre de la nueva hoja hasta la raíz. En un árbol equilibrado esa ruta son un puñado de diccionarios pequeños añadidos al archivo. En un árbol plano la «ruta» es el array raíz gigante, duplicado por completo en cada revisión. Un contrato que pasa por treinta ciclos de revisión y anotación puede acabar arrastrando treinta copias obsoletas del mismo array de 80 KB en su flujo de bytes
Para el código de procesamiento, el anidado tiene una consecuencia más tosca. No puedes asumir que el primer nivel de /Kids contiene páginas, así que hay que comprobar cada hijo: /Type /Pages significa recurrir, /Type /Page significa hoja. Un código que se detiene en el primer nivel funciona con cada archivo plano que encuentra, y luego suelta subárboles enteros en silencio la primera vez que un generador decide anidar
Los nodos interiores llevan atributos heredados
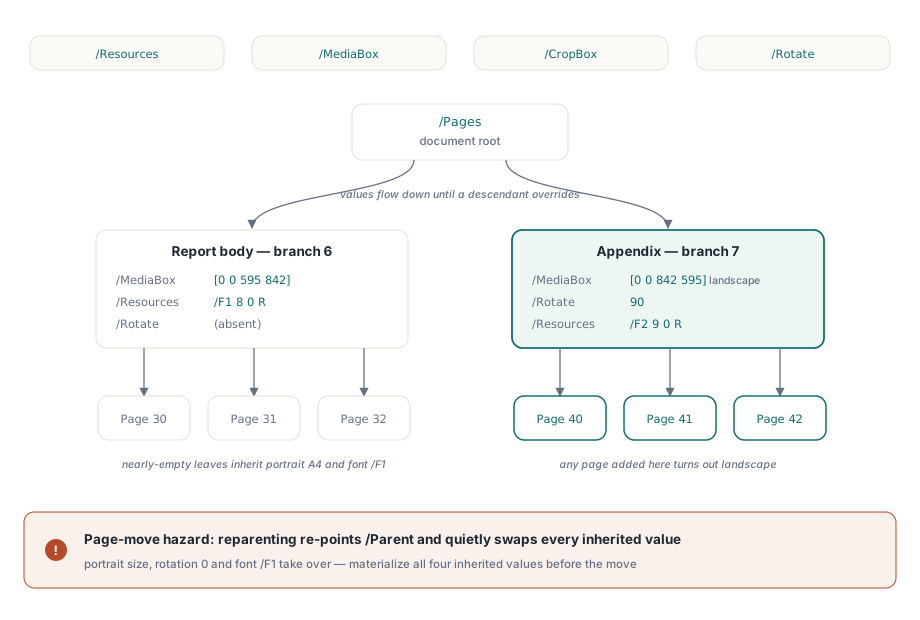
Los nodos intermedios no son solo enrutamiento. Cuatro atributos de página son heredables (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox y /Rotate. Cualquiera de ellos puede colocarse en un nodo /Pages, donde se aplica a cada hoja debajo a menos que un descendiente lo anule. Un generador que produce un informe con un apéndice apaisado puede expresar esa disposición en el propio árbol:
5 0 obj   % raíz del documento
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % cuerpo del informe: A4 vertical, fuente de cuerpo
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % apéndice: A4 apaisado, rotado, con fuente propia
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % página del apéndice: hereda tamaño, rotación, fuentes
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Los objetos 40 a 42 están casi vacíos. El tamaño de página, la rotación y los recursos de fuente llegan todos desde el nodo 7, lo que mantiene el archivo compacto y autosuficiente: añade una cuarta página bajo el nodo del apéndice y sale apaisada sin que nadie la toque
También significa que las propiedades de una página no están todas en la página. El objeto 40 no tiene clave /MediaBox, y eso es perfectamente legal — un lector que trate la clave ausente como entrada malformada rechazará archivos válidos. La búsqueda tiene que subir por la cadena de /Parent hasta encontrar la entrada o llegar a la raíz. Ese recorrido necesita un guardia contra ciclos. Un archivo corrupto puede llevar una referencia /Parent que apunte de vuelta a un nodo ya visitado, y sin un conjunto de objetos visitados la búsqueda gira para siempre
El mismo mecanismo crea el clásico riesgo de mover una página. Supongamos que una herramienta mueve el objeto 40 al cuerpo del informe editando los dos arrays /Kids y redirigiendo /Parent hacia el nodo 6. El movimiento es estructuralmente válido, pero el objeto 40 ahora hereda el /MediaBox vertical, ninguna rotación y la fuente /F1 — mientras que su stream de contenido sigue seleccionando /F2, que ya no se resuelve. La página se encoge, pierde la rotación y pierde su texto en una sola edición. El código de reordenación que se sostiene materializa los valores resueltos de los cuatro atributos heredables en el diccionario de la página antes de reasignarle un nuevo padre. Si alguna vez has arrastrado una página en un editor y la has visto cambiar de tamaño u orientación, este es el mecanismo que presenciaste
Aplanado: legal, habitual, a veces costoso
Muchas herramientas hacen lo contrario. Los generadores minimalistas producen un árbol de un solo nivel porque es sencillo, y muchas utilidades de fusión y división reconstruyen cualquier árbol que leen en un único array /Kids plano, porque generar una estructura equilibrada supone trabajo extra y la salida plana siempre es conforme. Una reconstrucción correcta debe resolver la herencia al mismo tiempo. Cada atributo que una hoja heredaba tiene que copiarse en la hoja, o elevarse a la nueva raíz si es uniforme en todo el documento; sáltate ese paso y la salida cambia la geometría exactamente igual que en el caso del movimiento de página
Para documentos típicos, el aplanado es inofensivo. Duele a gran escala, de las dos formas ya descritas: el array raíz se convierte en un único objeto grande que cada apertura y cada salto de página analizan por completo, y cada edición estructural lo reescribe entero. Lo que el aplanado no destruye es la compartición mediante referencias indirectas. Un árbol plano en el que las 10.000 páginas apuntan al mismo objeto de diccionario /Resources sigue estando deduplicado — lo único que se pierde es la opción de omitir la entrada en la página y dejar que un ancestro la proporcione
Cuando /Count miente
/Count es pura contabilidad. Debe ser igual al número de páginas hoja en el subárbol del nodo, y nada en el formato del archivo lo impone. Dos patrones de corrupción explican la mayoría de los recuentos falsos que se ven en la práctica
El primero es el recuento obsoleto que deja tras de sí una actualización incremental. Un editor inserta una página, reescribe el padre inmediato con un nuevo /Kids y un /Count actualizado, añade ambos al archivo — y nunca toca los ancestros:
% Revisión original
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Revisión añadida: se insertó una página en la rama central.
% El objeto 14 queda sustituido; el objeto 12 nunca se reescribe
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
El árbol ahora contiene diez hojas, pero la raíz sigue diciendo nueve. Un visor que confía en la raíz muestra nueve en su contador de páginas. Uno que usa los recuentos interiores para hacer una búsqueda binaria en un salto de página calcula un índice erróneo para cada página posterior al punto de inserción. Un recorrido completo encuentra diez. Tres respuestas distintas, un solo archivo
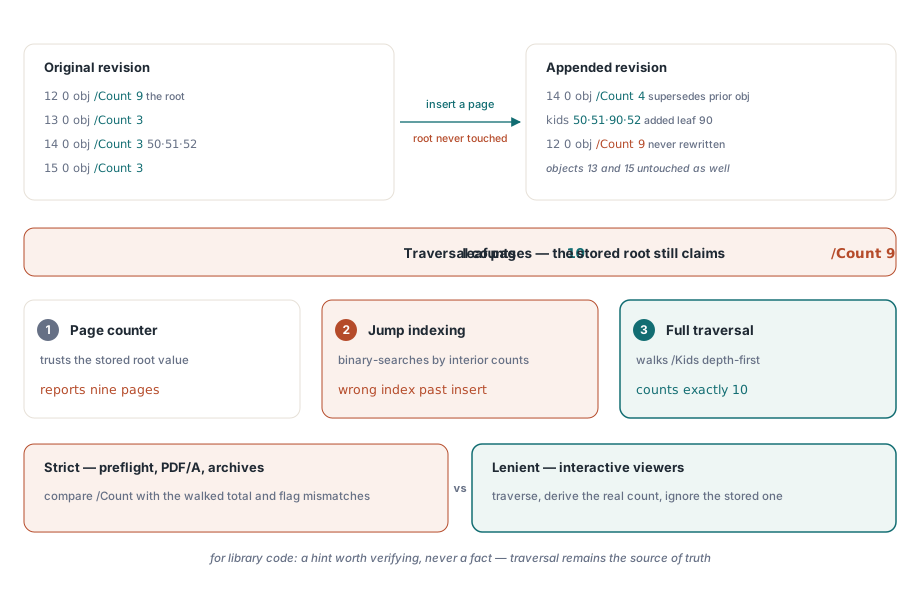
Hay una forma más silenciosa de que el mismo archivo te muerda. Un código que lee el recuento de la raíz, empieza a recorrer el árbol y se para en cuanto ha recogido esa cantidad de páginas jamás verá la página diez. Sin excepción, sin aviso, solo un documento al que le falta una página. Usar /Count como límite de bucle o como comprobación de rango es el error; el recorrido tiene que correr hasta agotar el árbol, diga lo que diga el número almacenado
El segundo patrón es el recuento que nunca podría ser correcto: negativo, cero en un nodo con contenido, o absurdamente enorme. Estos proceden de fuzzing, de daños en la transmisión, y ocasionalmente de errores aritméticos en los editores. Son peligrosos específicamente para el código que confía en /Count para la asignación de memoria. Dimensionar un array a partir de un /Count de -3 produce, en el mejor de los casos, un error de rango, y hacerlo a partir de un /Count de dos mil millones es una asignación de tipo denegación de servicio. Trata el valor como entrada no confiable, como cualquier otro número del archivo
Los analizadores se dividen en dos bandos respecto a todo esto. Los consumidores estrictos — herramientas de preflight, validadores PDF/A, flujos de archivado — comparan /Count con el resultado del recorrido y rechazan o marcan el archivo. Los visores interactivos son casi universalmente permisivos: recorren el árbol, calculan el recuento real y silencian el almacenado, que es precisamente la razón por la que un archivo con recuento obsoleto puede circular durante años sin quejas hasta que se encuentra con un parser más estricto dentro de algún flujo automatizado. Para código de biblioteca creemos que el término medio es el defecto correcto: usar /Count como pista para la preasignación, y para saltarse subárboles una vez verificado, y dejar que el recorrido siga siendo la fuente de verdad
En producción estos fallos rara vez se anuncian como problemas del árbol. Aparecen como páginas barajadas, una página que falta al final de una fusión, o una página que cambia de tamaño u orientación tras una reordenación. El caso práctico de depuración traza uno de esos informes de vuelta a través del árbol. Para la anatomía del archivo alrededor (objetos, datos de referencias cruzadas, trailers), el resumen de la estructura de archivos PDF es el sitio por donde empezar
El HotPDF Delphi Component se ocupa de todo esto internamente: recorre árboles anidados de cualquier profundidad, resuelve los atributos heredados cuando las páginas se copian o se mueven, y verifica /Count frente al recuento real de hojas en lugar de confiar en él, de modo que los índices de página en su API siempre significan páginas lógicas