El síntoma clásico parece un off-by-one: una rutina de copia de páginas pide la página 1 de un documento de tres páginas y recibe sistemáticamente la página 2. La lógica de indexación parece correcta. La llamada usa un índice lógico con base 0, la aritmética es correcta, las condiciones de contorno están bien. Y sin embargo sale la página equivocada cada vez
La causa no está en absoluto en el código de copia. Está en cómo el cargador construye su array de páginas, y es una de las trampas más fáciles de caer del análisis de PDF
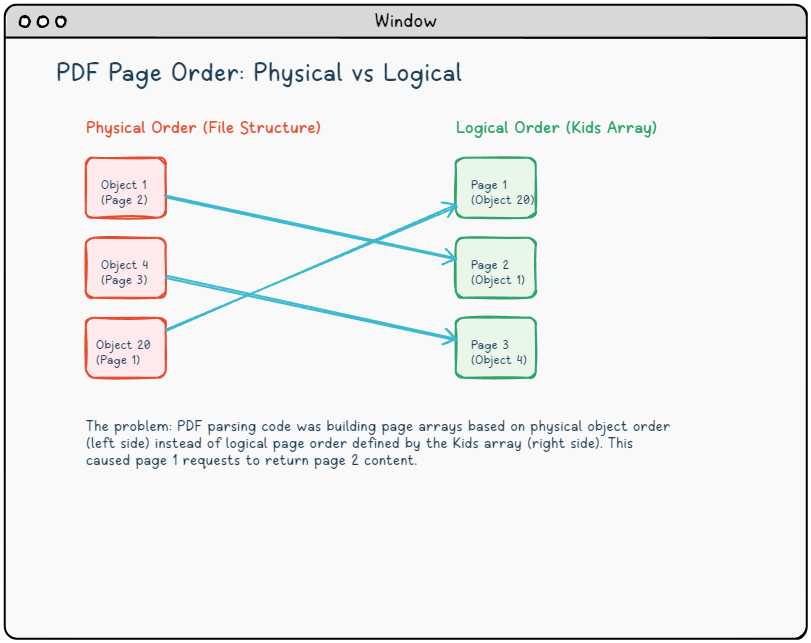
Dos ordenaciones, una fuente de confusión
Un fichero PDF es una colección de objetos indirectos, cada uno identificado por un número de objeto. La estructura del fichero no obliga a que esos números reflejen el orden de lectura. El objeto 1 puede contener la página 2; el objeto 20 puede contener la página 1. Lo que realmente define el orden de lectura es el árbol de páginas: una jerarquía de diccionarios /Pages cuyos arrays /Kids listan las referencias de página en la secuencia en que un visor debe mostrarlas (ISO 32000-1 §7.7.3)
Este árbol de páginas expone la trampa:
{ Raíz del árbol de páginas, objeto 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { página lógica 1 }
         1 0 R    { página lógica 2 }
         4 0 R]   { página lógica 3 }
>>
endobj
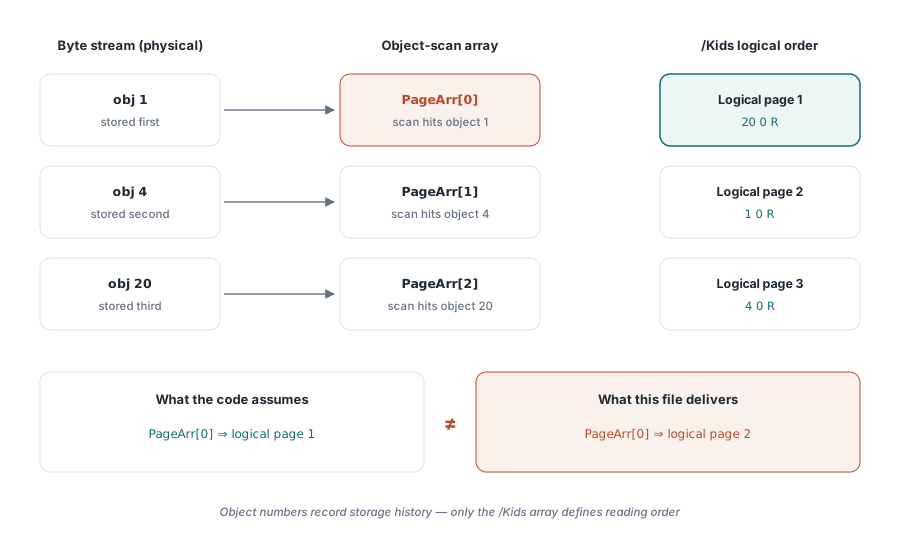
El fichero colocó el objeto 1 y el objeto 4 antes que el objeto 20 en el flujo de bytes. Cualquier analizador que recorriese los objetos indirectos en orden de fichero y los fuese estampando en un PageArr a medida que encontraba diccionarios de tipo página acabaría con el objeto 1 en el índice 0, el objeto 4 en el índice 1 y el objeto 20 en el índice 2. La página lógica 1 queda en PageArr[2]. Pedir el índice de página 0 trae la página lógica 2
Confirmación de la hipótesis
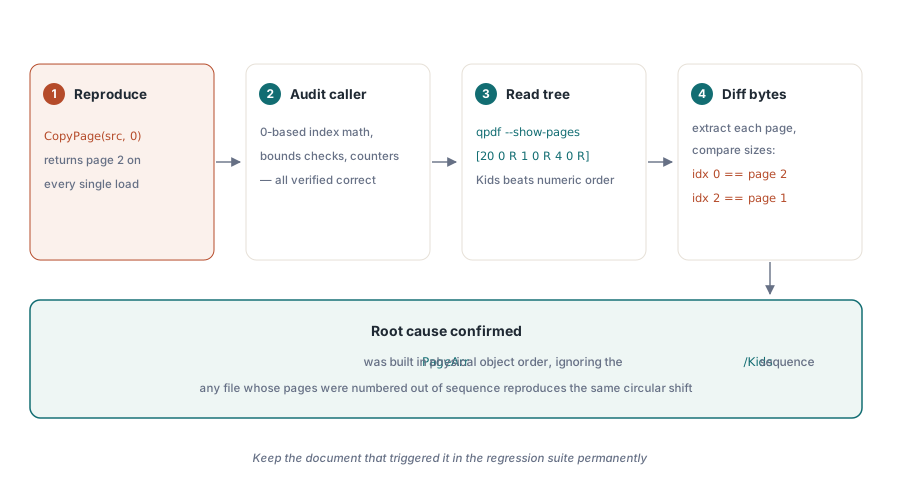
Antes de cambiar código alguno, demuestre la discordancia en lugar de asumirla. La herramienta de línea de comandos qpdf lo deja claro:
{ shell }
qpdf --show-pages input.pdf
{ La salida revela el orden de Kids: 20 0 R, luego 1 0 R, luego 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Muestra el diccionario Pages con /Kids en orden de lectura }
Extraer cada página por separado y comparar tamaños de fichero confirma el mapeo: lo que un PageArr[0] de escaneo por objetos produce es el contenido de la página lógica 2, y PageArr[2] contiene la página lógica 1. El desplazamiento circular es la prueba del delito. También explica por qué el síntoma aparece en muchos documentos fuente distintos: cualquier PDF en el que los objetos de página tengan números de objeto menores que una página lógica anterior lo dispara
Hay una razón directa por la que los PDF acaban en este estado. Una actualización incremental conserva los números de objeto de los objetos que cambia, pero todo lo que añade, una portada insertada al frente por ejemplo, recibe un número nuevo por encima de todo lo que ya había en el fichero, mientras su referencia va al principio del array Kids. Las herramientas que fusionan o reorganizan documentos renumeran los objetos en el orden que les conviene. Algunos generadores simplemente escriben las páginas en un orden cómodo para el streaming de contenido en lugar de la secuencia lógica de páginas. El formato PDF no les exige hacer otra cosa
El enfoque correcto: seguir el array Kids
Construya la lista de páginas recorriendo la cadena /Kids desde la raíz del catálogo, no escaneando objetos indirectos. El recorrido tiene que ser recursivo, porque un documento grande suele repartir sus páginas en nodos /Pages intermedios, y conviene protegerse contra un árbol malformado que apunte a uno de sus propios ancestros. En el esbozo de abajo, TPdfDict y TPdfArray representan los tipos de diccionario y array que use su parser:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // un ciclo o un árbol patológicamente profundo
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // sigue la referencia indirecta
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // nodo intermedio
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // hoja: siguiente página en orden de visualización
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Uso: partir de la entrada /Pages del catálogo
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Dos detalles son deliberados. Una hoja sin entrada /Type se sigue tratando como página, porque algunos escritores la omiten y los visores abren esos ficheros igualmente. Y la comparación final con /Count no cuesta nada pero atrapa árboles truncados o editados a mano antes de que un llamador indexe en ellos
Si carga documentos con HotPDF, este orden ya queda resuelto al cargar el documento: los índices de página siguen el orden de visualización del árbol de páginas, incluidos los nodos /Pages anidados, así que el índice 0 es siempre la primera página que muestra un visor. El recorrido de arriba importa cuando su propio código analiza la estructura PDF directamente
Copiar por índice lógico con CopyPageFromDocument
Como HotPDF resuelve el orden de páginas al cargar, los índices de página lógicos significan lo que los llamadores esperan. El CopyPageFromDocument de nivel superior toma un índice lógico con base 0 y copia la página correcta en el documento destino:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Copia la página lógica 0 (la primera que ve el usuario) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Como el índice es un índice en orden de visualización, CopyPageFromDocument se comporta correctamente incluso con documentos donde el orden físico y el lógico divergen. Para operaciones por lotes, InsertPagesFromDocument acepta un array de índices lógicos y los copia en una sola pasada
Qué revela esto sobre el análisis de PDF
La especificación PDF es explícita: el orden lógico de páginas lo define el array /Kids del árbol de páginas, no los números de objeto ni los desplazamientos de bytes (ISO 32000-1 §7.7.3.2). Cualquier parser que use un orden distinto como atajo producirá resultados correctos en la mayoría de los documentos que vea, porque la mayoría de los generadores escriben las páginas en orden natural y asignan números de objeto secuenciales. El error permanece oculto hasta que alguien carga un PDF editado incrementalmente, reorganizado por otra herramienta o generado por software que eligió otra disposición
Probar solo con PDF autogenerados omite esta clase de problema por completo. El manejo del orden de páginas necesita un corpus de pruebas con documentos de fuentes variadas: guardados incrementales, documentos escaneados con portadas insertadas, PDF producidos por herramientas que linealizan u optimizan el grafo de objetos de otra forma. Todo documento cuyo orden físico y lógico diverja merece un sitio permanente en ese corpus
La página del HotPDF Delphi Component cubre la API completa de operaciones de páginas, incluidos CopyPageFromDocument, InsertPagesFromDocument y MovePage