Dos minutos para copiar tres páginas de un PDF de 40 páginas no es un problema de ajuste de rendimiento. Es la señal de que se está usando la ruta de API equivocada. Cuando vi por primera vez ese tiempo en código de copia de páginas construido sobre el HotPDF Delphi Component, mi instinto fue mirar primero la estructura del documento y el código después. Ese orden resultó ser el inverso
Qué era realmente lento
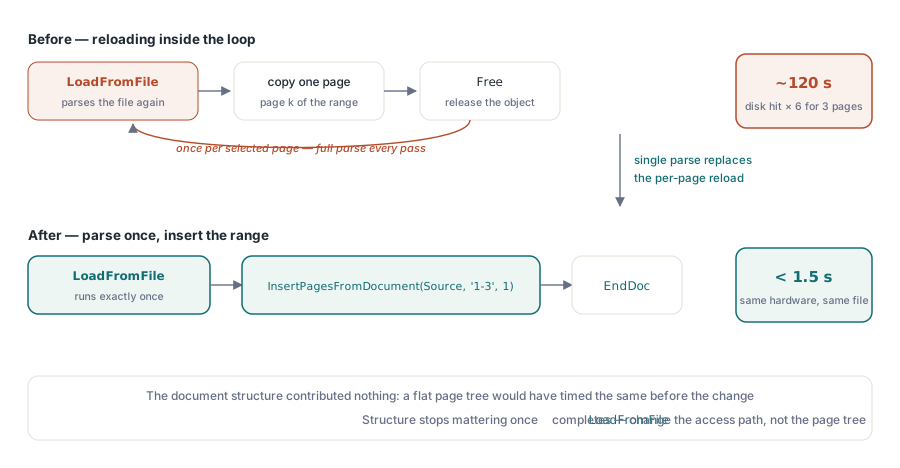
El PDF en cuestión era un documento de referencia de 40 páginas con un árbol de páginas nada trivial: varios nodos /Pages intermedios en lugar de un único array plano. El código en cuestión llamaba a LoadFromFile, después construía un documento nuevo con BeginDoc, iteraba sobre los números de página seleccionados y, en cada iteración, cargaba de nuevo el documento origen desde disco para extraer una página. Eso es el coste completo de análisis multiplicado por tantas páginas como queráis sacar. Un fichero de 12 MB golpeaba el disco seis veces para una extracción de tres páginas porque nadie se preguntó si el fichero necesitaba seguir abierto entre iteraciones
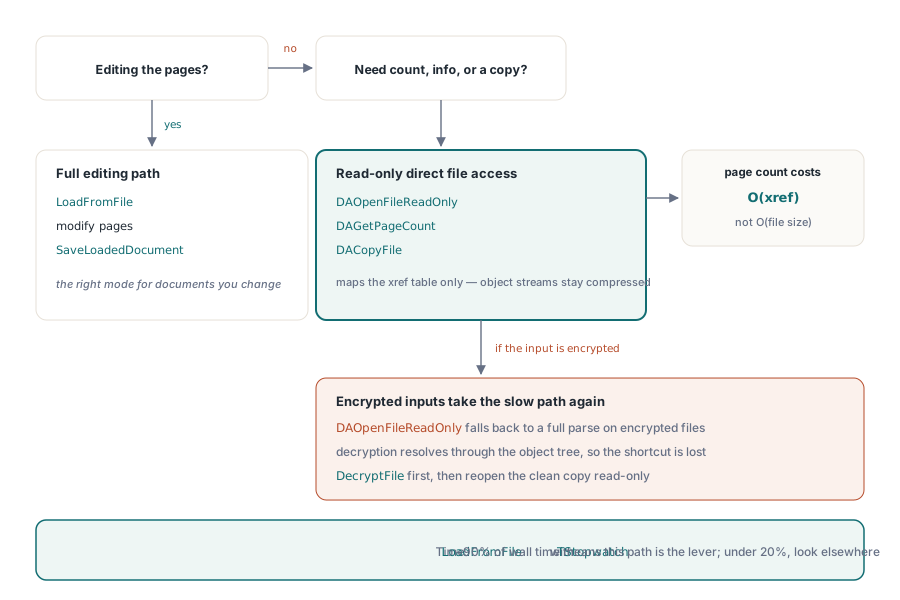
El segundo contribuyente era invisible en el código: el LoadFromFile de HotPDF construye el modelo de objetos en memoria sobre el que trabaja la API de edición. Es el comportamiento correcto para un documento que vas a modificar, pero es más trabajo del que necesitáis si solo queréis el recuento de páginas y un subconjunto de páginas. Para acceso de solo lectura a la estructura, DAOpenFileReadOnly evita deserializar el árbol de objetos completo, algo que importa en ficheros comprimidos con recursos de imagen grandes
Ambos se reducen a elegir la API diseñada para un trabajo y usarla para otro distinto
Usar ExtractPagesToFile para la extracción de páginas
La ruta correcta para copiar un rango de páginas de un documento HotPDF cargado hacia un fichero nuevo es ExtractPagesToFile, llamada después de LoadFromFile sobre el origen. Cargáis el origen una vez, y la llamada construye el documento destino, copia en él las páginas seleccionadas y lo escribe en disco, todo desde la copia que ya está en memoria:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Cargar el origen una vez: el análisis completo ocurre aquí y solo aquí
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Escribir el rango pedido ('1-3', '1,5,7-9') directamente a un fichero nuevo
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
El parámetro PageRange acepta el mismo formato que el ejemplo de línea de comandos: una lista separada por comas de números de página o rangos como '1-3' o '1,5,7-9'. Las páginas son de base 1. ExtractPagesToFile copia cada página seleccionada junto con los flujos de contenido y recursos que referencia, de modo que para una extracción de tres páginas de un documento de 40 páginas el conjunto de trabajo se mantiene pequeño
Cronometraje con el mismo fichero de 12 MB que antes tardaba dos minutos: unos 1.3 segundos con este patrón. La mayor parte de ese tiempo es la única llamada a LoadFromFile. La estructura del documento deja de importar una vez que la tabla de objetos se resuelve por primera vez
Cuando LoadFromFile es demasiado: la API de acceso directo a ficheros
Si solo se necesita contar páginas, inspeccionar información del documento o copiar un fichero sin tocar su contenido, la API de acceso directo a ficheros evita el análisis completo por completo. DAOpenFileReadOnly mapea la tabla de referencias cruzadas sin descomprimir los flujos de objetos, por lo que el recuento de páginas es O(tamaño de xref) en lugar de O(tamaño de fichero):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile es una copia que preserva los bytes, sin re-serialización
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
El matiz: DAOpenFileReadOnly acepta un parámetro de contraseña pero recurre a un análisis completo para entradas cifradas, porque el descifrado requiere el árbol de objetos para resolver el diccionario de cifrado. Si los ficheros fuente están cifrados, hay que descifrarlos primero con DecryptFile para obtener una copia sin cifrar y luego abrir esa con la API de acceso directo a ficheros. La función DecryptFile a nivel de fichero toma una ruta de reescritura AES-256 directa para el cifrado estándar y es más rápida que LoadFromFile seguido de SaveLoadedDocument para ficheros grandes, porque no construye el modelo de objetos completo en memoria
Memoria durante el procesamiento por lotes de gran volumen
Los trabajos por lotes que procesan docenas de ficheros en un bucle tienen un patrón que parece correcto pero acumula memoria: crear THotPDF dentro del bucle, llamar a LoadFromFile, hacer el trabajo, llamar a Free. Eso es estructuralmente correcto. El problema es cuando el trabajo interior asigna objetos temporales, captura excepciones y deja esos objetos temporales activos en las rutas de error. El gestor de memoria de Delphi no compacta, por lo que cien fugas en rutas de error a lo largo de una ejecución por lotes pueden elevar la memoria lo suficiente como para ralentizar la asignación de todo lo demás
La solución no es exótica. Cada THotPDF y cada TStream o TBitmap intermedio que participa en el trabajo con PDF pertenece a un bloque try/finally donde Free es la última instrucción. Hay que establecer los punteros locales a nil antes del try para que la rama finally pueda usar if Assigned(x) then x.Free de forma segura cuando la inicialización falla a mitad de camino. Esta es la disciplina estándar de propiedad de Delphi y es la historia completa para esta clase de problema
Una cosa más que saber en contextos de lotes: AddImage registra cada imagen con el documento que se está construyendo, y HotPDF libera esos registros cuando EndDoc termina ese fichero. El registro sigue el ciclo BeginDoc/EndDoc, no LoadFromFile, así que el patrón limpio para un lote es una instancia de THotPDF por documento: la creáis, hacéis el trabajo, guardáis y la liberáis
Medir antes de cambiar nada
Antes de recurrir a cualquiera de estos patrones, hay que medir. El TStopwatch de Delphi de System.Diagnostics envuelve QueryPerformanceCounter y es suficientemente preciso para el perfilado de reloj de pared de E/S de ficheros. Envolved solo LoadFromFile y ved cuánto tiempo consume. Si es el 90% del tiempo total, la solución es la API de acceso directo a ficheros o reducir cuántas veces se analiza el mismo fichero. Si es inferior al 20%, el cuello de botella está en otro lugar y se está siguiendo la pista equivocada
La extracción de dos minutos que dio origen a este artículo resultó ser por completo el patrón de carga repetida. La estructura del documento no contribuyó en nada; un árbol de páginas plano habría corrido igual. Cambiar a un único LoadFromFile seguido de una llamada a ExtractPagesToFile lo dejó en unos 1.3 segundos sobre el mismo hardware sin tocar nada más
La API de manipulación de páginas mostrada aquí forma parte del HotPDF Delphi Component para Delphi y C++Builder