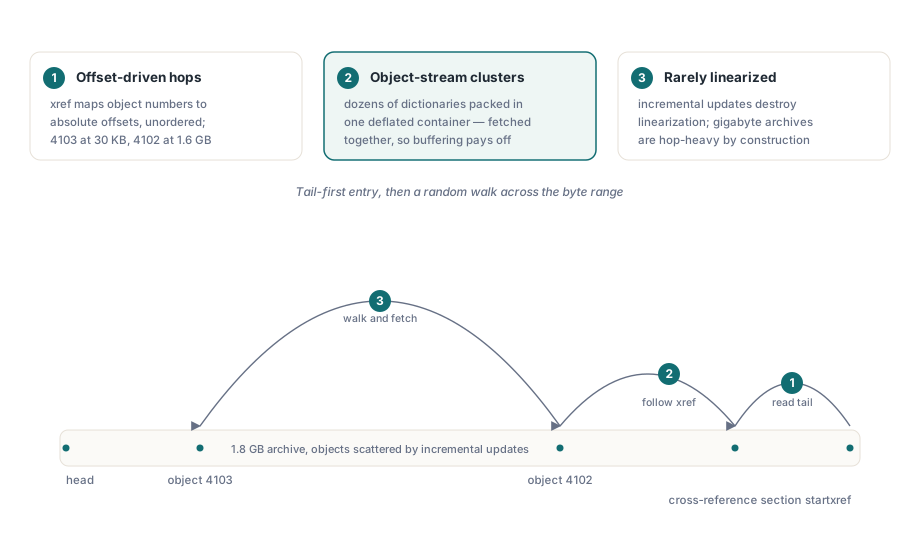
La primera lectura útil de un analizador de PDF está en el extremo equivocado del archivo. El formato coloca el puntero startxref en los últimos bytes, así que procesar un archivo de 1.8 GB empieza con un posicionamiento en la cola, una lectura de un kilobyte, y después un salto a donde sea que la tabla de referencias cruzadas diga que vive el catálogo del documento. A partir de ahí, el análisis es un recorrido aleatorio por todo el rango de bytes. Todo aquello en lo que la E/S almacenada en búfer es buena — la lectura anticipada secuencial detrás del puntero de archivo — apunta a una carga de trabajo que el PDF no tiene
La primera versión de este artículo afirmaba que un archivo mapeado en memoria resuelve el fallo de falta de memoria de 32 bits que TMemoryStream encuentra con una entrada de 2 GB. Esa afirmación es errónea, y la manera en que lo es apunta a la solución real: una ventana de mapeo deslizante. Lo que sigue es el patrón de acceso, la historia de 32 bits corregida con un mapeador por ventanas compilable, y la aritmética de llamadas al sistema sobre un archivo de prueba de 1.8 GB y 300,000 objetos
Por qué el diseño de un PDF vence a las lecturas almacenadas en búfer
Tres hechos estructurales dan forma al patrón de E/S. Primero, la navegación está guiada por desplazamientos: la tabla de referencias cruzadas asigna cada número de objeto a una posición de byte absoluta, y nada exige que esas posiciones estén ordenadas. Tras años de actualizaciones incrementales, el objeto 4102 puede estar en el desplazamiento 1.6 GB mientras el objeto 4103 está en 30 KB. Un bucle con TFileStream convierte cada recuperación en un Seek más un Read, dos transiciones al núcleo, con un búfer que no aporta nada porque la siguiente recuperación está a cientos de megabytes de distancia
Segundo, los flujos de objetos (ISO 32000-1 §7.5.7) empaquetan docenas o cientos de pequeños diccionarios en un único contenedor deflacionado. Recuperar un diccionario de página de 300 bytes puede significar leer e inflar un clúster de 100 KB. La cara opuesta: los objetos escritos juntos tienden a leerse juntos, así que un búfer dimensionado al clúster sirve gratis a la próxima docena de recuperaciones — la regularidad más explotable del formato
Tercero, la linealización. Un archivo linealizado antepone la primera página y una tabla de sugerencias para que los consumidores puedan leerlo de principio a fin. Los archivos de varios gigabytes casi nunca están linealizados: la linealización queda destruida por las mismas actualizaciones incrementales y fusiones que hicieron grande al archivo. Planifique para el caso hostil: saltos largos, sin orden, entrada por la cola
La historia de 32 bits, corregida
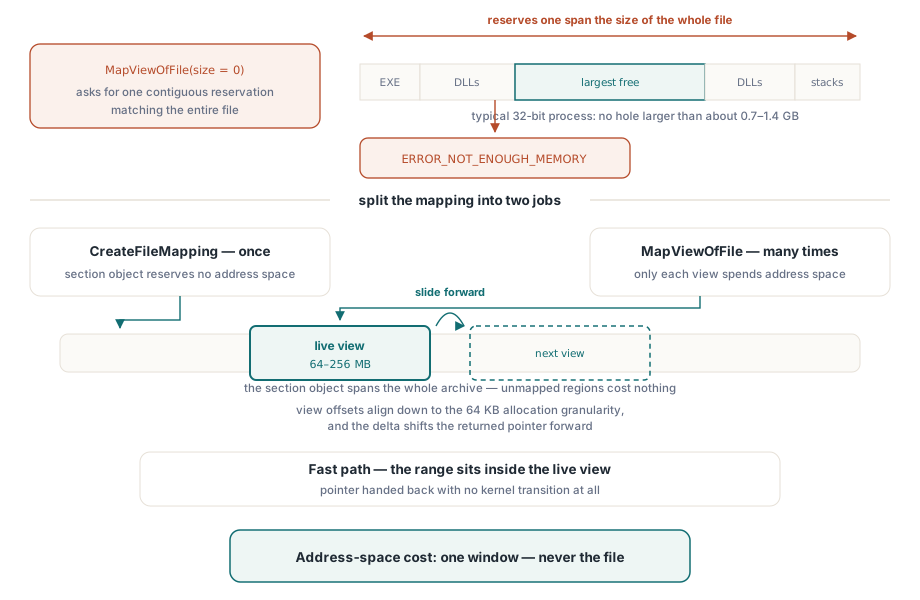
Un proceso Windows de 32 bits tiene 2 GB de espacio de direcciones de usuario, y MapViewOfFile con un recuento de bytes de cero solicita una reserva contigua del tamaño del archivo. Para una entrada de 2 GB, esa reserva no puede tener éxito: después del EXE, las DLL dispersas y las pilas de hilos, el mayor bloque contiguo libre en un proceso Delphi de 32 bits típico se sitúa en algún punto entre 700 MB y 1.4 GB. La llamada falla con ERROR_NOT_ENOUGH_MEMORY, el mismo muro con el que topa TMemoryStream.LoadFromFile, solo que trasladado de la RAM confirmada a la reserva de espacio de direcciones. Un mapeo del archivo completo no es una solución en 32 bits, solo el mismo fallo detrás de nombres de API que suenan mejor
La solución consiste en separar las dos cosas que hace un mapeo. CreateFileMapping crea el objeto de sección y no cuesta ningún espacio de direcciones, sea cual sea el tamaño del archivo. Solo MapViewOfFile gasta espacio de direcciones, y nada le obliga a mapear la sección entera: recibe un desplazamiento inicial de 64 bits y una longitud de vista. Cree la sección una vez, mapee una vista de 64 a 256 MB sobre la región que se está analizando, desmápela antes de deslizarse a la siguiente: el coste de espacio de direcciones es de una ventana, no de un archivo. Una restricción: los desplazamientos de vista deben ser múltiplos de SYSTEM_INFO.dwAllocationGranularity, 64 KB en la práctica, así que una solicitud para el desplazamiento 1,000,000 se redondea hacia abajo a 983,040 y el puntero de quien llama se ajusta hacia delante por la diferencia
Un mapeador de ventana deslizante en Delphi
La clase de abajo envuelve toda la disciplina: un objeto de sección, una vista activa, realineación de granularidad, y lecturas que cruzan el límite de una ventana gestionadas haciendo crecer esa única vista en lugar de coser dos
uses
  Winapi.Windows, System.SysUtils;

type
  TWindowedFileMapper = class
  private
    FFile: THandle;
    FMapping: THandle;
    FFileSize: Int64;
    FGranularity: DWORD;      // SYSTEM_INFO.dwAllocationGranularity
    FWindowSize: NativeUInt;  // tamaño de vista predeterminado
    FViewBase: PByte;         // base de la vista actual (alineada)
    FViewOffset: Int64;       // desplazamiento de archivo al que corresponde FViewBase
    FViewSize: NativeUInt;    // bytes mapeados en la vista actual
    procedure Unmap;
  public
    constructor Create(const FileName: string;
      WindowSize: NativeUInt = 64 * 1024 * 1024);
    destructor Destroy; override;
    function Map(Offset: Int64; Size: NativeUInt): PByte;
    procedure ReadBytes(Offset: Int64; var Buffer; Count: NativeUInt);
    property FileSize: Int64 read FFileSize;
  end;

constructor TWindowedFileMapper.Create(const FileName: string;
  WindowSize: NativeUInt);
var
  Info: TSystemInfo;
begin
  inherited Create;
  FFile := CreateFile(PChar(FileName), GENERIC_READ, FILE_SHARE_READ, nil,
    OPEN_EXISTING, FILE_ATTRIBUTE_NORMAL, 0);
  if FFile = INVALID_HANDLE_VALUE then
    RaiseLastOSError;
  if not GetFileSizeEx(FFile, FFileSize) then
    RaiseLastOSError;
  // El objeto de sección no reserva espacio de direcciones, sea cual sea el tamaño del archivo
  FMapping := CreateFileMapping(FFile, nil, PAGE_READONLY, 0, 0, nil);
  if FMapping = 0 then
    RaiseLastOSError;
  GetSystemInfo(Info);
  FGranularity := Info.dwAllocationGranularity;  // 64 KB en la práctica
  FWindowSize := WindowSize;
end;

destructor TWindowedFileMapper.Destroy;
begin
  Unmap;
  if FMapping <> 0 then CloseHandle(FMapping);
  if FFile <> INVALID_HANDLE_VALUE then CloseHandle(FFile);
  inherited;
end;

procedure TWindowedFileMapper.Unmap;
begin
  if FViewBase <> nil then
  begin
    UnmapViewOfFile(FViewBase);
    FViewBase := nil;
    FViewSize := 0;
  end;
end;

function TWindowedFileMapper.Map(Offset: Int64; Size: NativeUInt): PByte;
var
  AlignedOffset: Int64;
  Delta, MapSize: NativeUInt;
begin
  if (Offset < 0) or (Offset + Int64(Size) > FFileSize) then
    raise ERangeError.CreateFmt(
      'Map request at %d for %d bytes is outside the file',
      [Offset, Int64(Size)]);

  // Camino rápido: el rango solicitado ya está dentro de la vista activa
  if (FViewBase <> nil) and (Offset >= FViewOffset) and
     (Offset + Int64(Size) <= FViewOffset + Int64(FViewSize)) then
    Exit(FViewBase + NativeInt(Offset - FViewOffset));

  Unmap;  // desliza: nunca mantener dos vistas a la vez

  // Las vistas deben empezar en un límite de granularidad de asignación
  AlignedOffset := Offset - (Offset mod FGranularity);
  Delta := NativeUInt(Offset - AlignedOffset);

  MapSize := FWindowSize;
  if MapSize < Size + Delta then   // la solicitud se extiende más allá del final de la ventana:
    MapSize := Size + Delta;       // hace crecer esta única vista para cubrirla
  if AlignedOffset + Int64(MapSize) > FFileSize then
    MapSize := NativeUInt(FFileSize - AlignedOffset);  // acota en EOF

  FViewBase := MapViewOfFile(FMapping, FILE_MAP_READ,
    DWORD(AlignedOffset shr 32), DWORD(AlignedOffset and $FFFFFFFF),
    MapSize);
  if FViewBase = nil then
    RaiseLastOSError;

  FViewOffset := AlignedOffset;
  FViewSize := MapSize;
  Result := FViewBase + NativeInt(Delta);
end;

procedure TWindowedFileMapper.ReadBytes(Offset: Int64; var Buffer;
  Count: NativeUInt);
begin
  Move(Map(Offset, Count)^, Buffer, Count);
end;
Dos detalles cargan con el peso. El camino rápido en la parte superior de Map devuelve un puntero sin transición al núcleo cuando el rango solicitado ya está dentro de la vista activa; gracias a la agrupación en flujos de objetos, este es el caso común y de donde vienen los ahorros. Y una solicitud que se extiende más allá del final de la ventana predeterminada hace crecer MapSize para esa única vista en lugar de coser dos, lo cual mantiene ReadBytes en una sola línea y libra a quien llama de bucles de lectura parcial
El tamaño de ventana es un parámetro tolerante: a 64 MB, un barrido completo de un archivo de 1.8 GB son 29 vistas; a 256 MB son 8, pero cada reserva es más difícil de ubicar en un espacio de 32 bits fragmentado, y por debajo de unos 16 MB los archivos con muchos saltos vuelven a mapear con la frecuencia suficiente para notarse. En cualquier punto del rango de 64 a 256 MB, el tráfico de mapeo es ruido estadístico
Contando las llamadas al sistema
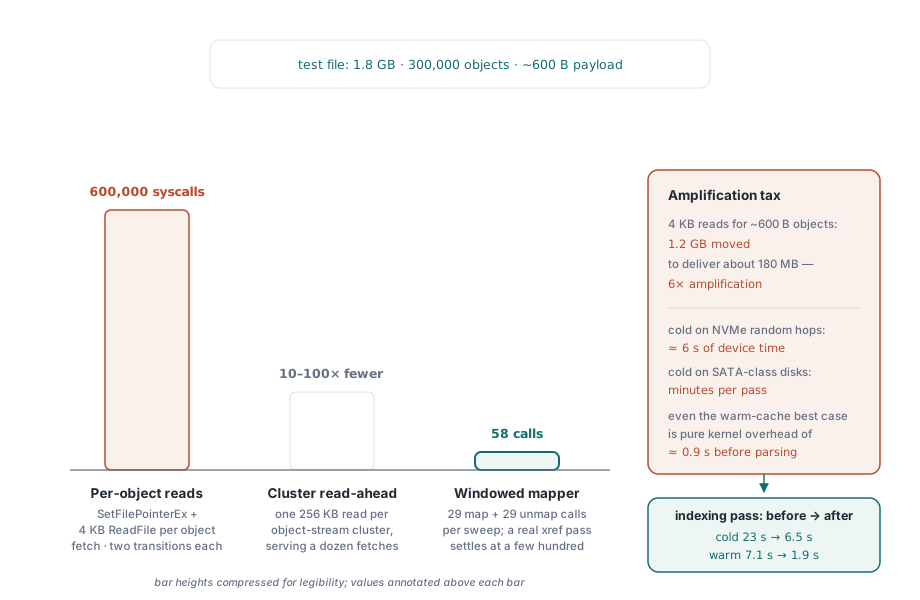
Ahora la aritmética. Archivo de prueba: 1.8 GB, 300,000 objetos indirectos con una media de unos 600 bytes de carga útil. Un analizador por objeto recupera cada uno con SetFilePointerEx más un ReadFile de 4 KB: 600,000 transiciones al núcleo. Una llamada al sistema de lectura en caché hace su ida y vuelta en aproximadamente 1.5 μs en hardware x64 actual, así que eso son 600,000 × 1.5 μs ≈ 0.9 segundos de sobrecarga pura del núcleo antes de analizar un solo byte — el mejor caso con la caché caliente. En frío, cada salto es una operación de dispositivo: con la latencia efectiva de ~20 μs de las lecturas aleatorias de 4 KB en NVMe, 300,000 de ellas cuestan unos 6 segundos de tiempo de dispositivo; en almacenamiento de clase SATA, minutos
Las lecturas también mueven los datos equivocados: 300,000 × 4 KB empujan 1.2 GB a través de búferes de usuario para entregar apenas unos 180 MB de carga útil — una amplificación de seis veces, con cada byte copiado del núcleo al usuario
Un búfer de lectura anticipada dimensionado a los clústeres de flujos de objetos es la primera mejora honesta: una lectura de 256 KB por clúster en lugar de una por objeto recorta el recuento de transiciones en uno o dos órdenes de magnitud. También es la herramienta adecuada donde el mapeo resulta incómodo, normalmente en recursos compartidos de red
El mapeador por ventanas va más allá. Un barrido completo son 29 llamadas a MapViewOfFile y 29 a UnmapViewOfFile, 58 transiciones explícitas frente a 600,000. Un análisis real guiado por el xref no es un barrido limpio, pero el camino rápido absorbe cada recuperación dentro de la ventana activa; un pase de indexación de metadatos sobre el archivo de prueba se estabilizó en unos pocos cientos de remapeos. El mapeo no elimina el trabajo del núcleo: convierte las llamadas al sistema explícitas en fallos de página que el gestor de memoria resuelve en clústeres multipágina, directamente desde la caché de archivo sin copia al espacio de usuario, y las regiones nunca tocadas no cuestan nada. De principio a fin, el pase de indexación pasó de 23 s en frío y 7.1 s en caliente con lecturas por objeto a 6.5 s en frío y 1.9 s en caliente con el mapeador; lo que queda es el inflado de zlib, no la E/S
Dónde encaja FILE_FLAG_NO_BUFFERING
FILE_FLAG_NO_BUFFERING evita la caché del sistema a cambio de reglas de alineación estrictas: desplazamientos, longitudes y direcciones de búfer, todos alineados a sector. Se gana su lugar en trabajos secuenciales de un solo paso que de otro modo inundarían la caché con bytes que nadie vuelve a leer — una reserialización por lotes que reescribe todo el archivo, o un pase de linealización sobre la salida terminada. Con búferes alineados de 4 a 8 MB se acerca al ancho de banda secuencial del dispositivo sin contaminar la caché
Es exactamente lo contrario de lo adecuado para el análisis. Los saltos aleatorios de xref a través de un manejador sin búfer convierten cada recuperación de diccionario de 300 bytes en una lectura física completa sin caché que absorba la segunda visita — y el análisis de PDF revisita regiones constantemente, porque páginas distintas se resuelven en los mismos flujos de objetos. E/S sin búfer para la reescritura secuencial, E/S mapeada o en caché para el análisis aleatorio; el indicador es por manejador, así que una misma canalización puede mantener ambos sobre el mismo archivo
64 bits, conjuntos de trabajo y el lado de la escritura
En una compilación de 64 bits, la objeción del espacio de direcciones desaparece: pase el tamaño del archivo como ventana y la clase de arriba degenera en un único mapeo completo. La trampa en servicios de larga duración: las páginas de solo lectura respaldadas por archivo no cargan compromiso, así que los contadores de compromiso se mantienen tranquilos, pero cada página tocada se une al conjunto de trabajo; analice la mayor parte de 1.8 GB y el conjunto de trabajo crece a la par, desalojando todo lo demás. Las ventanas acotadas ponen un techo a eso, así que el patrón deslizante sigue siendo la opción predeterminada correcta incluso donde el espacio de direcciones es gratuito
En el lado de la escritura, la E/S más barata es la que nunca se emite. El mecanismo de actualización incremental de PDF (ISO 32000-1 §7.5.6) añade los objetos cambiados y una nueva sección de referencias cruzadas después de los bytes originales, que nunca se mueven. Estampar una página en el archivo de 1.8 GB añade decenas de kilobytes; una reescritura completa mueve los 1.8 GB enteros, cinco órdenes de magnitud de diferencia, y el añadido es salida secuencial pura en la cola
Dónde encajan las bibliotecas de losLab
Ambas bibliotecas de PDF de losLab ofrecen esta disciplina como superficie de API. La HotPDF Direct File API lee recuentos de páginas y estructura a través de un manejador de archivo sin construir el árbol de objetos, copia y descifra a nivel de archivo, y escribe deltas mediante BeginIncrementalUpdate — la estrategia de solo añadir de arriba, empaquetada. PDF Library for Delphi sigue la misma vía con su capa Direct Access: un lector en streaming que recorre la tabla de referencias cruzadas in situ, recupera objetos de forma perezosa, extrae rangos de páginas de archivo a archivo, y persiste las ediciones como revisiones incrementales. Si está escribiendo su propio analizador, la clase de mapeador es suya para tomarla; si está gestionando una canalización de documentos, deje que la biblioteca mantenga la ventana honesta
Nota: el manejo de E/S optimizado para documentos a escala de gigabytes está integrado directamente en el HotPDF Delphi VCL Component para Delphi y C++Builder