El atributo axis="rowAxis" en un elemento pivotField se lee como XML de lo más sensato, y un lector que lo mapee a "campo de fila" cargará el pivot con cada campo en el eje correcto. Pasad la misma parte por un validador construido desde el esquema de la ECMA-376 Parte 1 §18.10 y falla en el primer atributo: ST_Axis tiene exactamente cuatro tokens, axisRow, axisCol, axisPage y axisValues, y rowAxis no es uno de ellos. Un escritor de pivots tiene que satisfacer al esquema y no a su propio lector, porque la gente que abre el fichero usa Excel y sus propios parsers
Las definiciones de campos pivot están llenas de reglas como esa. Tres tienden a colarse por un test de ida y vuelta: los tokens de enumeración, el requisito de que un elemento items nunca está vacío, y las entradas de subtotal finales que Excel enumera después de los ítems de datos. Dos más se sientan en el lado de lectura, en atributos que Excel omite porque guardan su valor por defecto del esquema. El resto del artículo recorre cada regla, muestra cómo tiene que quedar el XML y muestra las llamadas Delphi que lo producen
Por qué un round trip no puede cazar un token de eje equivocado
Un round trip demuestra que el escritor y el lector están de acuerdo entre ellos, y nada más. Si el lector acepta tanto axisRow como rowAxis, un escritor que emita el equivocado pasa cualquier comprobación de guardar-y-cargar que podáis escribir, porque el lector repara el error a la vuelta. El fallo solo aparece cuando un consumidor más estricto abre la parte: un validador de esquema, un parser generado desde el XSD, o Excel decidiendo que la parte necesita reparación
HotXLS separa los dos lados a propósito. El escritor XLSX emite solo los cuatro tokens ST_Axis, mientras que el lector de pivots también mapea las grafías de aspecto inglés rowAxis, colAxis, pageAxis y dataAxis al eje correspondiente, así que los ficheros de productores que las usen siguen cargando con su disposición intacta. La salida se somete al esquema; la entrada solo tiene que ser reconocible. Al revés, un lector estricto emparejado con un escritor descuidado al menos fallaría ruidosamente en vuestros propios tests; un lector comprensivo emparejado con un escritor descuidado no falla en ningún sitio que podáis ver
<!-- inválido: rowAxis no es un valor ST_Axis, y CT_Items no puede estar vacío -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- válido: token ST_Axis, ítems reales, subtotal por defecto final -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>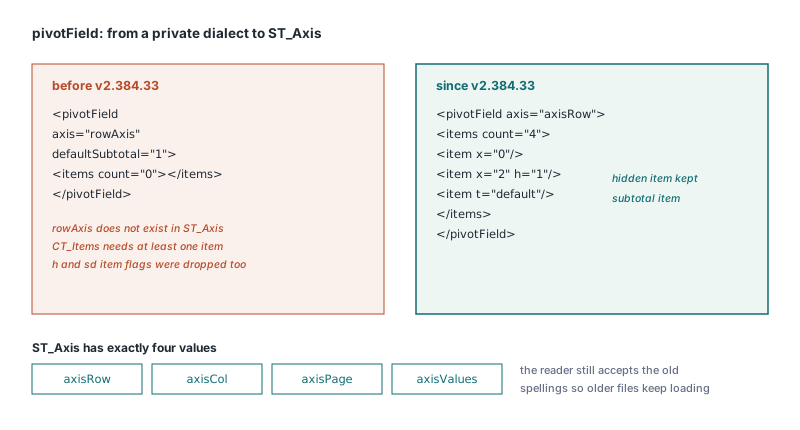
Qué espera CT_PivotField más allá del eje
CT_PivotField tiene tres requisitos más que es fácil soltar. Un campo agregado en el área de valores debe decirlo en su propia definición con dataField="1", aunque la lista <dataFields> ya lo referencie. HotXLS pone ese flag en cada campo pivot al que apunte una entrada de DataFields, de modo que un campo añadido con AddDataFieldByName queda marcado en ambos sitios
La segunda regla es estructural. CT_Items exige al menos un hijo item, lo que hace <items count="0"></items> inválido aunque sea XML bien formado y se parsee en todas partes. Cuando un campo no tiene ítems, HotXLS deja fuera el elemento items entero. La tercera regla va del estado de cada ítem: un miembro oculto lleva h="1" y un miembro con detalles contraídos lleva sd="0". Ambos vienen de TXLSPivotItem.IsHidden y TXLSPivotItem.IsDetailHidden y se escriben en cada guardado, así que un filtro fijado en código sobrevive hasta Excel
Ítems de subtotal finales y la trampa del count
Cuando un campo tiene ítems, Excel hace seguir a los ítems de datos un item extra por función de subtotal, tipado con ST_ItemType. El subtotal automático es <item t="default"/>; las funciones explícitas usan sum, countA, avg, max, min, product, count, stdDev, stdDevP, var y varP. Estas entradas no llevan índice x hacia la caché, y se incluyen en el atributo count de items. Un escritor que las deje fuera produce una lista de ítems que ya no coincide con los flags de subtotal del mismo elemento
HotXLS deduce la cola de TXLSPivotField.Subtotals al guardar: un ítem t="…" por función del conjunto, en orden de enumeración, añadido al count, más el atributo al estilo sumSubtotal="1" correspondiente en el campo. Los campos creados por AddPivotTable empiezan con el conjunto vacío, lo que escribe defaultSubtotal="0" y ningún ítem final. Para informes generados, dejad el conjunto vacío: las filas de subtotal cambian la altura del pivot y desplazan cualquier cosa colocada debajo. Añadid funciones a Subtotals solo en los campos donde un lector necesite las filas extra
El nombrado merece una segunda mirada antes de elegir función. xlpsCount mapea a countA, que cuenta todas las entradas no vacías, y xlpsCountNums mapea a count, que cuenta solo números. Quien lea "count" en el XML y vaya a por xlpsCount recibe la otra función
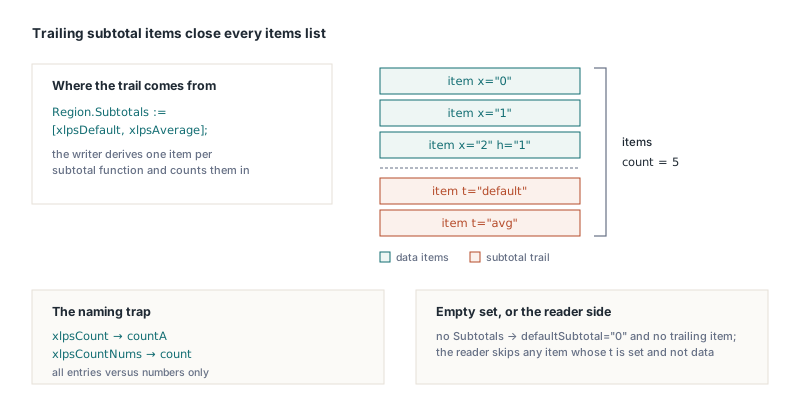
El programa de abajo construye un pivot desde una hoja de datos existente con un campo de fila, un campo de columna y un campo de valores. El campo Region recibe el subtotal automático más un promedio, lo que produce dos ítems finales tras sus ítems de datos y dataField="1" en Revenue
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets es 1-based
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil si no existe tal campo
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> t="default", t="avg"
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue recibe dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Leer lo que Excel omite
El lector tiene el problema en imagen especular. Un campo pivot hecho por Excel enumera sus entradas de subtotal en items, y cargarlas como miembros ordinarios daría al campo ítems fantasma que no apuntan a ningún valor de caché. HotXLS se salta cualquier item cuyo atributo t esté presente y no sea data, lo que cubre las entradas de subtotal, de total general y en blanco. Las funciones de subtotal llegan por los flags del propio campo y aterrizan en Subtotals, así que el código que recorre Items ve solo miembros reales y cada CacheItemIndex remite a un valor de caché
Los atributos ausentes son la otra mitad. En el esquema, defaultSubtotal de CT_PivotField y containsString de CT_SharedItems valen true por defecto, y Excel los omite cuando guardan ese valor. HotXLS lee un defaultSubtotal ausente como true y añade xlpsDefault a Subtotals cuando el campo no lleva flags de subtotal explícitos, que es como el propio Excel muestra tal campo. Un containsString ausente también se lee como true, así que un campo de caché de texto plano se clasifica como datos de string. Leed cualquiera de los dos atributos como false y cada pivot guardado por Excel pierde sus subtotales automáticos al cargar, mientras los campos de texto se convierten en otro tipo. Un escritor que siempre escribe todos los atributos nunca toca este camino; solo lo ejercitan los ficheros de otro productor
Un libro cargado de Excel es la entrada de test correcta aquí, porque es el único tipo de fichero que omite esos atributos. La comprobación de abajo abre uno y recorre un campo de fila:
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Un campo de Excel sin atributos de subtotal sigue informando el valor por defecto
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // Las entradas de subtotal se saltaron, así que cada ítem mapea a un valor de caché
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // comprobación sugerida para vuestros propios tests
    end;
  finally
    Book.Free;
  end;
end;
Por qué numFmtId="General" es inválido en campos de caché
numFmtId="General" es inválido porque ST_NumFmtId es un entero sin signo, por muy natural que resulte tomar prestado el nombre que los usuarios ven en el diálogo Format Cells. Un parser que tipifica los atributos desde el esquema rechaza el nombre sin más, y esa clase de fallo es exactamente la que se convierte en diálogo de reparación en Excel; el artículo sobre las reglas OPC y de marcado detrás del aviso de reparación de Excel cubre cómo se disparan esos diálogos. HotXLS escribe cada cacheField con un numFmtId numérico tomado del NumberFormat del campo de caché, que es 0, el formato General integrado, salvo que algo lo fijara
Las tablas dinámicas por debajo de la fila 65535 necesitan posiciones de 32 bits
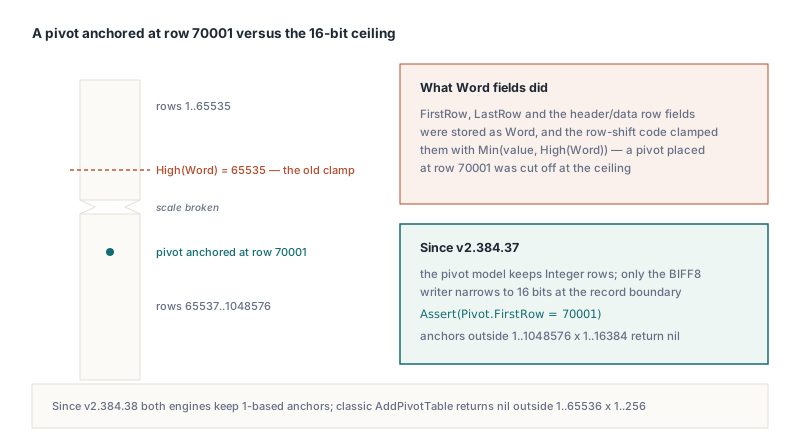
Un modelo de pivot compartido por los motores XLS y XLSX se ve tentado a tomar prestados sus anchos de campo del record SxView de BIFF8, donde 16 bits cubren cada fila que una hoja clásica puede tener. Una hoja XLSX llega a 1.048.576 filas. Guardad FirstRow, LastRow, FirstHeaderRow, FirstDataRow y las contrapartidas de columna como Word, recortadlas con Min(Value, High(Word)), y un pivot anclado en la fila 70001 sale cortado en 65535
En TXLSPivotTable esas propiedades son Integer, y solo el escritor BIFF8 las estrecha en la frontera del record. TXLSXWorksheet.AddPivotTable devuelve nil para un ancla fuera de 1..1048576 por 1..16384, y AddPivotTableCopy devuelve nil cuando la extensión de la copia saldría de la cuadrícula
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // La fila 70001 está más allá del rango de 16 bits
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // ancla fuera de la hoja o rango de origen irresoluble
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert es una comprobación sugerida para vuestros propios tests
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
El motor XLS clásico sigue la misma convención 1-based. Los records SxView y DConRef guardan valores 0-based, mientras que el modelo, como el motor XLSX y Cells[Row, Col], conserva posiciones 1-based: el lector BIFF8 suma 1 y el escritor resta 1 en la frontera del record. El AddPivotTable clásico devuelve nil para un ancla fuera de 1..65536 por 1..256, así que anclad los pivots en (1, 1) en lugar de (0, 0). La disposición de los records en sí se describe en los records SX de BIFF8 detrás de las tablas dinámicas .xls clásicas
Testear contra el esquema en lugar de contra vuestro propio lector
Cada trampa de arriba sobrevive a un round trip cuando el lado comprensivo y el lado defectuoso viven en la misma librería. Tres tipos de comprobación los cazan. Una validación de esquema de las partes pivotTableN.xml y pivotCacheDefinitionN.xml generadas caza los tokens inventados, los elementos items vacíos y los ids de formato con nombre. Ficheros guardados por Excel, pasados por vuestro lector, ejercitan los atributos que Excel omite en sus valores por defecto. Aserciones que fijen el token exacto en el XML escrito, como axis="axisRow", cazan a un escritor derivando hacia una grafía que solo vuestro lector entiende; asertar sobre el eje parseado no puede
Los pivots construidos por la API, incluidos los campos calculados, los ítems calculados y las disposiciones de porcentaje del total mostrados en construir y refrescar tablas dinámicas XLSX con campos calculados, salen con estas reglas aplicadas y sin código extra de vuestra parte. El trabajo que os queda es elegir qué campos reciben subtotales y qué función de count queréis decir
El componente de hoja de cálculo HotXLS para Delphi construye, lee y guarda tablas dinámicas XLS y XLSX desde código Delphi y C++Builder, sin instalación de Excel ni automatización COM en la máquina que lo ejecuta