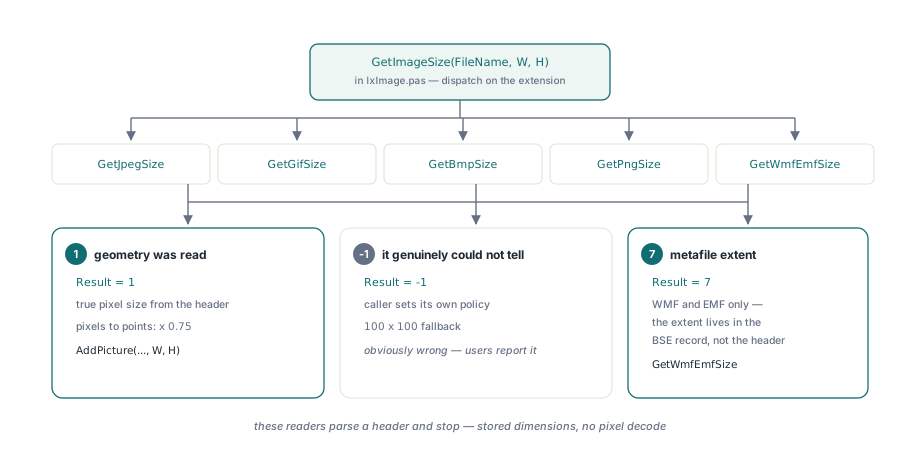
HotXLS lee la geometría real en píxeles de una imagen desde la propia cabecera del archivo antes de escribir cualquier geometría de dibujo. GetImageSize en lxImage.pas despacha según la extensión del archivo a GetJpegSize, GetGifSize, GetBmpSize, GetPngSize o GetWmfEmfSize, convierte píxeles a puntos con un factor de 0.75, y devuelve -1 cuando de verdad no puede saberlo
Esa última cláusula es la parte que más tardó en quedar bien. Un lector de tamaños que no puede fallar es un lector que miente, y una mentira sobre la geometría de la imagen no aflora en el momento de insertar. Aflora semanas después, cuando alguien abre el workbook y el logo de la empresa es un rectángulo aplastado
¿Por qué una imagen necesita su geometría real antes de entrar en el dibujo?
Porque el formato de hoja de cálculo guarda la extensión, no la imagen. Cuando AddPicture o Images.AddFromFile colocan una imagen, la parte de dibujo registra un ancho y un alto explícitos para la forma — en DrawingML son los atributos cx y cy del elemento a:ext, en English Metric Units, según ECMA-376 Parte 1 §20.4. Nada en ese registro dice "usa el tamaño natural de la imagen", así que el tamaño natural tiene que venir de algún sitio, y el único sitio donde existe son los bytes de la imagen. Equivócate por un factor de tres y la imagen sale estirada por un factor de tres, en toda aplicación que abra el workbook, para siempre. La conversión de unidades de esas dimensiones en píxeles a EMU es una preocupación aparte, cubierta en el artículo de unidades EMU y escalado; esta pieza trata del paso anterior, donde se obtienen los números de píxeles. El fallback cuando un lector falla es 100 por 100, y ese número está deliberada y obviamente mal. No es una suposición de un tamaño plausible, es un marcador que significa "nadie pudo leer este archivo", y es mucho mejor que un número equivocado con aspecto plausible porque un usuario lo reporta de inmediato
GIF: el descriptor que nunca se parseaba
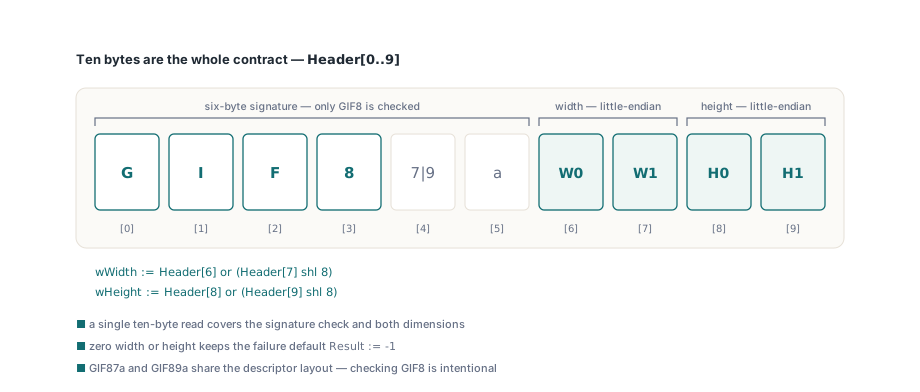
GetGifSize es nuevo, y antes de que existiera todo GIF insertado en una hoja salía exactamente a 100 por 100 — no había ninguna rama GIF, así que la extensión caía al brazo default de GetImageSize y devolvía -1. Es la cabecera más barata del conjunto de parsear, lo que hace la omisión ligeramente embarazosa y muy fácil de arreglar. La especificación GIF89a pone el Logical Screen Descriptor inmediatamente después de la firma de seis bytes, y el §18 define sus dos primeros campos como el ancho y el alto de la pantalla lógica, cada uno un valor sin signo de 16 bits guardado en little-endian. En términos de archivo, eso son los bytes 6 y 7 para el ancho y los bytes 8 y 9 para el alto, así que una sola lectura de diez bytes cubre la comprobación de la firma y las dos dimensiones
function GetGifSize(const AFileName: WideString; var AWidth, AHeight: Double): Integer;
var
  f: TWFileStream;
  Header: array [0.. 9] of Byte;
  wWidth, wHeight: Word;
begin
  Result:= - 1;
  AWidth:= 100;
  AHeight:= 100;
  f:= TWFileStream.Create(AFileName, fmOpenRead);
  try
    // Firma "GIF8", luego el Logical Screen Descriptor con el ancho y el alto
    // como words little-endian en los offsets 6 y 8
    if (f.Read(Header[0], SizeOf(Header))= SizeOf(Header))and
      (Header[0]= Ord('G'))and (Header[1]= Ord('I'))and
      (Header[2]= Ord('F'))and (Header[3]= Ord('8')) then
    begin
      wWidth:= Header[6]or (Header[7] shl 8);
      wHeight:= Header[8]or (Header[9] shl 8);
      if (wWidth> 0)and (wHeight> 0) then
      begin
        AWidth:= wWidth* 0.75;
        AHeight:= wHeight* 0.75;
        Result:= 1;
      end;
    end;
  finally
    f.Free;
  end;
end;
Fíjate en su forma: los valores de fallo se asignan primero, y el path de éxito es lo único que los sobrescribe. Todos los lectores de lxImage.pas siguen ese orden, porque convierte "no pude leer esto" en el default en vez de algo que haya que recordar en cada salida temprana. Comprobar solo GIF8 en vez de la cadena completa GIF87a o GIF89a es intencional — el layout del descriptor es idéntico en las dos revisiones, y no hay beneficio en rechazar un archivo cuya geometría es legible
¿Qué cambia en realidad un tamaño de cabecera BMP de 12?
GetBmpSize lee los cuatro bytes del offset 14 como tamaño de la cabecera DIB y ramifica según el valor, porque un BMP con tamaño de cabecera 12 guarda sus dimensiones con un ancho de campo completamente distinto al de todos los demás BMP. [MS-WMF] §2.2.2 describe la familia: BITMAPCOREHEADER tiene 12 bytes y lleva ancho y alto de 16 bits, mientras que BITMAPINFOHEADER, BITMAPV4HEADER y BITMAPV5HEADER empiezan todos con biWidth y biHeight con signo de 32 bits. Leer cuatro bytes donde el archivo tiene dos no falla ruidosamente; arrastra el conteo de planos y la profundidad de bits como la mitad alta de un número y reporta un bitmap de varios cientos de miles de píxeles de ancho. La segunda trampa de la misma cabecera es el signo de biHeight: un valor negativo no significa alto negativo, significa que las filas del DIB están guardadas de arriba abajo en vez de abajo arriba, que es una afirmación sobre el orden de píxeles sin nada que ver con la geometría
  f.Seek(14, soFromBeginning);
  if f.Read(HeaderSize, 4)= 4 then
  begin
    if HeaderSize= 12 then
    begin
      // BITMAPCOREHEADER guarda dimensiones de 16 bits
      if (f.Read(wWidth, 2)= 2)and (f.Read(wHeight, 2)= 2) then
      begin
        lWidth:= wWidth;
        lHeight:= wHeight;
        Result:= 1;
      end;
    end
    else if (f.Read(lWidth, 4)= 4)and (f.Read(lHeight, 4)= 4) then
      Result:= 1;
  end;
  // ...
  // Un biHeight negativo solo marca un DIB top-down; la magnitud es el tamaño
  if (Result= 1)and (lWidth> 0)and (lHeight<> 0) then
  begin
    AWidth:= lWidth* 0.75;
    AHeight:= Abs(lHeight)* 0.75;
  end
  else
    Result:= - 1;
El guard final merece una lectura atenta. El alto se comprueba contra <> 0 y no contra > 0, porque el negativo es legal y el cero no lo es, y Abs se aplica solo en el punto de conversión. El ancho no tiene un caso equivalente — un biWidth negativo no está definido por el formato, así que se trata como archivo corrupto y se degrada a -1. Pasar un valor negativo crudo hacia arriba en su lugar produciría una extensión negativa en el registro de dibujo, que se recorta, se ignora o se renderiza como una forma volteada según la aplicación que abra el workbook
JPEG: ¿qué marcadores son en realidad frame headers?
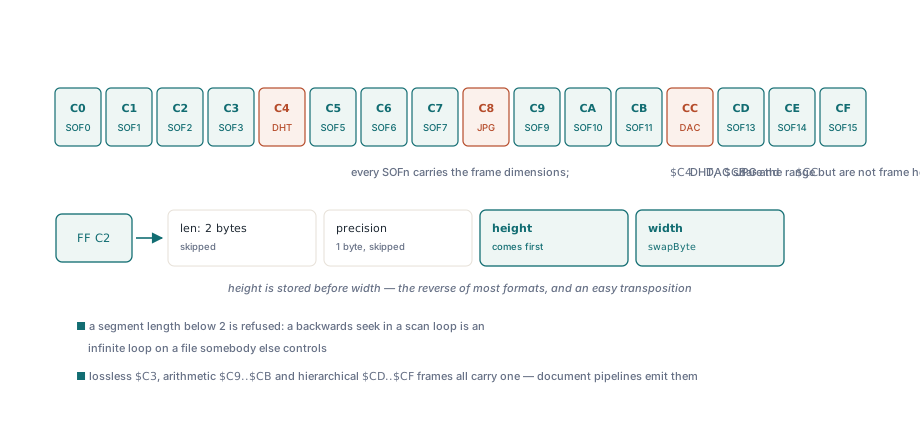
GetJpegSize acepta el conjunto de marcadores [$C0..$C3, $C5..$C7, $C9..$CB, $CD..$CF], y los tres huecos de ese rango son todo el punto. ITU-T T.81 §B.2.2 define el frame header como SOFn, y el frame header es donde viven el número de líneas y las muestras por línea, en todo tipo de frame y no solo en los comunes. Los marcadores que caen dentro del mismo tramo numérico pero no son frame headers son $C4 (DHT, define las tablas Huffman), $C8 (JPG, reservado) y $CC (DAC, define el acondicionamiento de la codificación aritmética). Un lector que solo reconoce baseline, sequential extendido y progressive — $C0, $C1 y $C2 — funciona con casi todo JPEG que produzca una cámara o una herramienta de captura, y luego falla en silencio con los que importan a los flujos de documentos: el JPEG lossless ($C3), las variantes con codificación aritmética ($C9 a $CB) y los tipos de frame jerárquicos ($CD a $CF) todos escanean más allá del frame header, se salen del final del archivo y aterrizan en el fallback. La imagen médica y las pipelines de documentos escaneados producen exactamente esos archivos
// Cualquier marcador SOFn lleva las dimensiones del frame; $C4 (DHT), $C8 (JPG)
// y $CC (DAC) comparten el rango pero no son frame headers
if Seg in [$C0.. $C3, $C5.. $C7, $C9.. $CB, $CD.. $CF] then
begin
  ReadLen:= f.Read(Dummy[0], 3);
  ReadLen:= f.Read(wHeight, 2);
  wHeight:= swapByte(wHeight);
  ReadLen:= f.Read(wWidth, 2);
  wWidth:= swapByte(wWidth);
  found:= True;
  Break;
end
Dos detalles en esas siete líneas. Los tres bytes que se saltan son la palabra de longitud de segmento más el byte de precisión de muestra, así que la lectura cae en el conteo de líneas; JPEG guarda el alto antes que el ancho, que es lo contrario de la mayoría de los formatos y una transposición fácil de cometer. Y los valores pasan por swapByte porque JPEG es big-endian de principio a fin, la misma razón por la que GetPngSize pasa sus valores IHDR de 32 bits por lswapByte. El recorrido de segmentos tiene su propio guard: cuando un marcador no es sin parámetros, el lector toma la longitud de dos bytes, la intercambia, y se niega a hacer seek si el valor está por debajo de 2 — una longitud más corta que su propio campo se traduciría en un seek hacia atrás, y un seek hacia atrás en un bucle de escaneo es un bucle infinito en un archivo que controla otra persona
Devolver menos uno gana a devolver un número plausible
El hilo común de los cinco lectores es que GetImageSize distingue tres resultados y no dos. 1 significa que la geometría se leyó del archivo. -1 significa que no, y el llamador debe usar su default. 7 lo devuelve GetWmfEmfSize y significa otra cosa completamente distinta: le dice a AddPicture que tome el tamaño del registro BSE del metafile, porque un WMF o un EMF lleva su extensión en el propio registro de imagen del workbook y no en un offset fijo de la cabecera del archivo. El manejo de metafiles en general está cubierto en el artículo del decoder acotado de EMF y WMF. GetJpegSize muestra por qué esa distinción necesita un flag explícito y no una inferencia: el bucle de escaneo puede terminar de tres formas — encontró un frame header, llegó al final del archivo, o abandonó por una longitud de segmento corrupta — y solo la primera asigna wWidth y wHeight. Sin el Boolean found, los otros dos paths convertirían lo que esas locales tuvieran dentro y entregarían el resultado hacia arriba como un éxito. Las locales sin inicializar suelen ser cero, y cero es la peor respuesta posible aquí: sobrevive a todos los chequeos de validez aguas abajo y produce una imagen invisible que nadie puede seleccionar ni borrar
var
  W, H: Double;
begin
  case GetImageSize(FileName, W, H) of
    1: Sheet.AddPicture(FileName, Row, Col, W, H);
    7: Sheet.AddPicture(FileName, Row, Col);  // metafile: tamaño del registro BSE
  else
    // W y H son 100 x 100; decide una política en vez de aceptar un placeholder
    LogWarning('unreadable image geometry: ' + FileName);
  end;
end;
Dónde están los límites honestos
Estos lectores parsean una cabecera a propósito y se detienen. No decodifican píxeles, así que reportan las dimensiones guardadas y nada más, y hay casos donde las dimensiones guardadas no son toda la historia. Un GIF animado cuyos frames son más pequeños que la pantalla lógica sigue reportando la pantalla lógica, lo que es correcto para el layout y puede no coincidir con lo que muestra un visor. Un JPEG con una etiqueta de orientación EXIF que especifica una rotación de 90 grados reporta las dimensiones del frame sin rotar, así que una foto de retrato hecha con el móvil puede volver como apaisada. Un DIB con una relación de aspecto de píxel no cuadrada reporta conteos de píxeles crudos, y el factor 0.75 asume 96 DPI en todo. Nada de eso son bugs de la lectura de cabeceras y nada de eso es arreglable sin decodificar la imagen, que no es para lo que está esta capa — son límites documentados, así que si tu pipeline maneja fotos de móvil, lee la etiqueta de orientación tú mismo e intercambia los valores antes de llamar a AddPicture. Todo lo demás sobre colocación de imágenes, anclaje y el modelo de objetos de dibujo está cubierto en el artículo de gráficos, imágenes y dibujos
HotXLS lee y escribe XLS, XLSX, ODS y CSV de forma nativa en Delphi y C++Builder sin necesidad de instalar Excel, y la inserción de imágenes pasa por este path de cabeceras en todos ellos. Los detalles de formatos soportados y licencias están en la página de producto del componente de hoja de cálculo HotXLS para Delphi