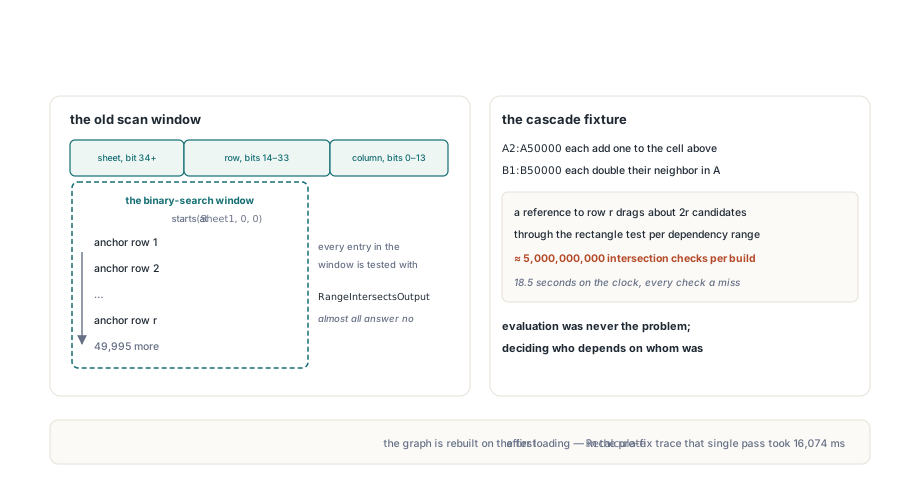
Una hoja con 50.000 fórmulas en la columna A, cada una sumando uno a la celda de arriba, y otras 50.000 en la columna B doblando a su vecina, es más o menos lo más llano que puede ser un modelo de hoja de cálculo. Evaluarlo cuesta 100.000 sumas y multiplicaciones. Averiguar el orden de evaluación cuesta mucho más si el builder de aristas está escrito de la forma obvia: buscar cada fórmula desde el principio de la hoja referenciada hasta la fila referenciada, probar cada una por solape y quedarse con los aciertos. Para esta única hoja eso son unos cinco mil millones de tests de rectángulo, y casi todos responden que no
El cinco mil millones es aritmética, no una lectura de cronómetro. Una referencia a la fila r arrastra a la ventana de búsqueda unas 2r candidatas, una por columna para cada fila por encima, y sumar eso sobre 100.000 referencias aterriza en los miles de millones. Lo interesante es que la ventana de verdad tiene que empezar en el principio de la hoja, por un motivo que no tiene nada que ver con la pereza
Dónde gasta el tiempo una reconstrucción de dependencias
El motor de recálculo de HotXLS reconstruye su grafo de dependencias de fórmulas siempre que cambia la topología de fórmulas: el primer Recalculate después de cargar o generar un libro, y el primero después de reescribir fórmulas, añadir o quitar hojas, o clonar un bloque de celdas. Las dos clases de libro, TXLSWorkbook y TXLSXWorkbook, construyen para esto un TXLSDepGraph de la unidad lxDepGraph. Cada celda de fórmula se convierte en un nodo con un ancla (Row, Col) y un rectángulo de salida que llega hasta (OutRow2, OutCol2). Para una fórmula ordinaria el rectángulo es la propia celda ancla
Los nodos se ordenan por una clave de 64 bits empaquetada de XLSDepMakeKey: la columna en los bits 0–13, la fila en los bits 14–33, y el índice de hoja desde el bit 34 hacia arriba. Ordenar por esa clave da orden de hoja mayor y fila mayor, así que encontrar la última fórmula que podría importar para una referencia es una única búsqueda binaria sobre (Sheet2, Row2, 16383). La primera es el problema. El límite inferior tiene que ser (Sheet1, 0, 0), lo más arriba de la hoja referenciada, y todo lo que hay entre los dos límites se convierte en candidata
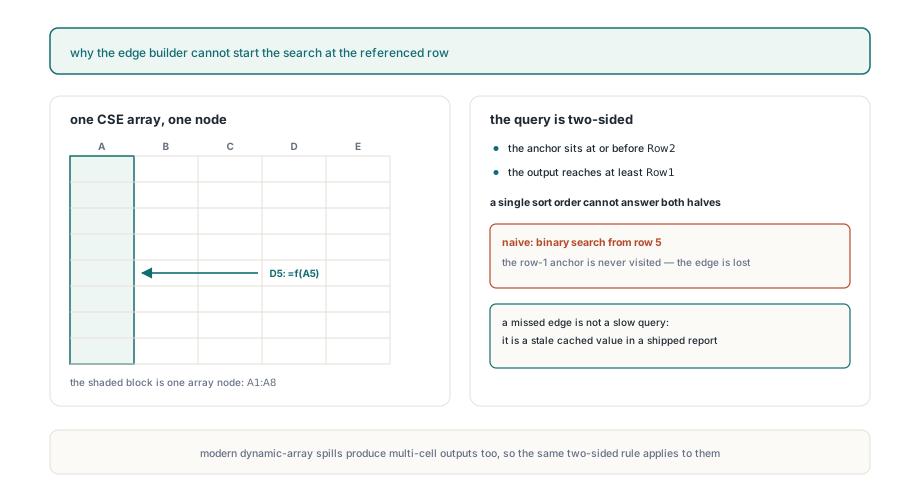
¿Por qué no puede empezar la búsqueda en la fila referenciada?
Una fórmula array anclada por encima de un rango puede poseer celdas dentro de él. En un TXLSXWorkbook, un array CSE introducido en A1:A8 es un único nodo cuyo ancla es A1 y cuya salida llega hasta la fila 8, como describe el artículo sobre recálculo incremental y el grafo de dependencias. Una fórmula en D5 que solo lee A5 sigue necesitando una arista desde ese nodo. Empieza la búsqueda binaria en la fila 5 y el ancla de la fila 1 nunca se visita, la arista nunca se registra, y D5 puede evaluarse antes que el array del que depende. El síntoma es un valor en caché obsoleto en el libro guardado, mucho más difícil de notar que un recálculo lento
Así que la consulta real tiene dos lados. Un nodo es candidato cuando su ancla está en o antes de Row2 y su salida alcanza al menos Row1, en una hoja dentro de la referencia y con columnas que se solapan. Un orden por ancla responde la primera mitad. Nada en el orden de anclas dice nada sobre la segunda, porque una fórmula en la fila 3 puede sacar una celda o mil filas. Las tablas de datos what-if tienen la misma forma: TXLSXWorkbook registra cada tabla de datos como un nodo que cubre toda su área de resultados. Las fórmulas dynamic array toman otra ruta y se marcan volátiles, así que se recalculan en cada pasada; el artículo sobre fórmulas dynamic array con spill cubre cómo se comportan los rangos derramados
TXLSDepGraph es una clase pública, así que el caso es fácil de reproducir sin un libro. Los índices de hoja son basados en uno y filas y columnas basadas en cero, coincidiendo con las coordenadas de la calculadora. La sonda de abajo registra la raíz del array y el lector, construye las aristas, y además pasa una cadena de referencias a punto invertida por el mismo tipo de grafo para mostrar el contador del que se fían las secciones siguientes
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // Array CSE: ancla A1 (fila 0, col 0), salida hasta A8 (fila 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (fila 4, col 3) solo lee A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, la raíz A1
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: la raíz A1 y la propia D5
  finally
    G.Free;
  end;

  // Cadena A1..A100000, cada celda lee la de arriba, añadida de abajo arriba
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Podar subárboles por su mayor fila de salida
TXLSDepGraph.BuildEdges conserva el orden por ancla para el límite superior y responde el límite inferior con un segment tree aumentado con máximo tendido sobre el orden ordenado. Cada entrada del árbol guarda el mayor OutRow2 de todos los nodos por debajo de ella. La consulta solo baja dentro de la ventana de claves y suelta cualquier subárbol cuyo máximo almacenado esté por debajo de Row1, porque ninguna fórmula de ese subárbol puede alcanzar las filas referenciadas. Los nodos que sobreviven siguen recibiendo el test de rectángulo completo, así que el alcance de hoja y las columnas se comprueban exactamente igual que antes
La técnica es lo bastante pequeña para enseñarla entera. El boceto de abajo es una versión mínima escrita para este artículo, con nombres propios; ninguno es API de HotXLS, y los arrays los llena quien lee desde una lista de filas de salida ya ordenada por clave de ancla
uses
  System.Math, System.Generics.Collections;

// Solo un boceto: un segment tree aumentado con máximo sobre nodos ordenados por clave de ancla.
// OutRow2[i] es la última fila de salida del nodo i en orden ordenado.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Recoge, de izquierda a derecha, cada nodo de [Lo, Hi) cuya salida alcanza Row1
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // fuera de la ventana, o nada alcanza Row1
  if L = R then
  begin
    Hits.Add(L);                 // quien llama sigue ejecutando el test de rectángulo completo
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // primero la izquierda
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // mantiene el orden de escaneo
end;

// Build once with BuildMax(Ix, 1, 0, Count - 1),
// then per reference call Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
Por referencia, el trabajo baja del tamaño de la ventana a O((k + 1) log n), donde k es el número de nodos cuya salida alcanza de verdad las filas referenciadas. Volviendo al modelo inicial, una referencia de Br a Ar prueba ahora dos rectángulos, Ar y la propia Br, y una referencia de Ar a la celda de arriba prueba los dos nodos de esa fila. A mano son unos 200.000 tests para la construcción completa en lugar de cinco mil millones
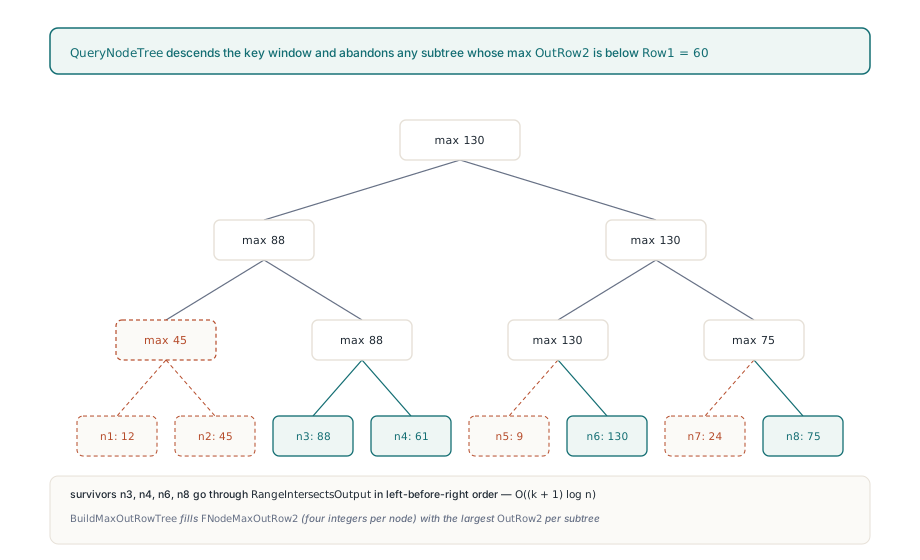
Las mismas aristas, en el mismo orden
La recursión de izquierda-antes-que-derecha importa más de lo que parece. Los nodos supervivientes se visitan en exactamente el orden en que los visitaría un bucle plano sobre la ventana, así que los arrays Dependents y Precedents de cada nodo se rellenan en la misma secuencia, y el orden topológico construido a partir de ellos sale igual en cada ejecución. Ese orden no es solo contabilidad interna: cuando el grafo está al día, el writer XLSX emite xl/calcChain.xml en el orden que devuelve FullTopoOrder, así que un orden de visita no determinista se vería como diffs ruidosos entre dos guardados de un libro sin cambios
Los tipos de arista conservan también sus reglas. Las referencias que caen en el argumento de lookup-array de VLOOKUP, MATCH, XLOOKUP y funciones parecidas producen aristas de lookup-scan, que propagan la suciedad pero se quedan fuera de la detección de ciclos. Cuando un nodo tiene a la vez una referencia dura y una de lookup al mismo precedente, la arista dura registrada primero suprime la arista de escaneo posterior, y una arista de escaneo registrada primero conserva su hueco mientras la arista dura se añade igualmente. Ese ordenamiento es lo que evita que los rangos de lookup produzcan referencias circulares falsas, y solo se sostiene si la visita podada recorre las candidatas en orden de escaneo
La propiedad EdgeCandidateChecks hace la poda observable. Cuenta los rectángulos de salida que la última llamada a BuildEdges probó de verdad y se reinicia al comienzo de cada construcción. En la sonda de arriba la cadena invertida reporta 99.999, un test por referencia, aunque los nodos se añadieron de abajo arriba y el orden tuvo que reordenarlos todos. AddNode marca como obsoletos tanto el orden como las aristas, así que el siguiente BuildEdges o NodeIndexOf reconstruye el índice en lugar de parchearlo
Dónde se queda el coste restante
El árbol poda solo por filas, y esa elección da forma a lo que un modelo grande sigue pagando
- Los fallos por columna se pagan en las hojas: las 2.626 fórmulas que llenan
A100:Z200llegan todas a la fila 100, así que una referencia aAA100:AA200las prueba una a una antes de rechazarlas por columnas - Las referencias de columna completa y otras anchas tienen de verdad muchos precedentes; el índice quita los tests desperdiciados, y construir las aristas reales sigue siendo proporcional a cuántas hay
- Una referencia que abarca varias hojas abre una ventana que cubre la primera hoja entera, así que las fórmulas de allí con salidas profundas llegan al test de hoja; las aristas salen iguales y solo la poda es más débil
- El árbol lleva cuatro enteros por nodo, unos 1,6 MB para 100.000 fórmulas, y cualquier cambio de topología paga una reordenación completa de O(n log n) más una construcción de árbol de O(n) en la siguiente construcción de aristas
Las filas son la dimensión única correcta que indexar. Los informes generados, los libros contables y los modelos financieros crecen hacia abajo, así que la distancia por filas es de donde sale casi todo el candidato desperdiciado, mientras que un fallo por columna lo rechaza el test de rectángulo en un puñado de comparaciones de enteros. Una segunda dimensión en el árbol complicaría cada consulta para ahorrarse tests que ya son baratos
Por el lado de quien llama, el paso caro es la reconstrucción, y las ediciones de valores no la disparan. Recalculate construye el grafo en su primera llamada; las llamadas posteriores solo reevalúan las fórmulas aguas abajo de los valores cambiados, más las volátiles. Escribir todas las fórmulas primero y recalcular una vez es el patrón al que apuntar. El arnés de abajo cronometra ambos tipos de pasada en el motor clásico, donde Recalculate devuelve el número de celdas de fórmula que no pudo evaluar; ejecútalo en el hardware que vaya a alojar el trabajo por lotes, porque los tiempos absolutos dependen mucho de la máquina
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // cadena de 49.999 eslabones en la columna A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50.000 dependientes en la columna B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // construye el grafo, evalúa todo
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // edición de valor: el grafo se reutiliza
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // solo el subgrafo sucio
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
En este modelo la pasada de valores sigue reevaluando las 99.999 fórmulas, porque toda la columna A cuelga de A1; lo que se salta es la construcción del grafo. Sobrescribir una celda de fórmula con un valor plano es otra historia, porque eso cambia la topología y el siguiente Recalculate reconstruye el grafo desde cero
La misma forma cuadrática en nombres definidos clonados
Las bandas de informe esconden el mismo patrón en otro sitio. TXLSXWorksheet.CloneRangeTo copia los nombres definidos que apuntan directamente a un rango dentro del bloque clonado, y cada copia necesita un nombre único en su ámbito: Total_2, Total_3, y así. Una búsqueda que reinicia en _2 para cada copia sondea una candidata más cada vez, así que una hoja construida a base de cientos de bandas clonadas gasta un número cuadrático de búsquedas de nombre solo en poner nombres
TXLSXDefinedNames lo evita con una pista de sufijo guardada en su índice de nombres, una por nombre base y ámbito. La siguiente búsqueda parte del sufijo devuelto la última vez y lo reexamina primero, porque quien llama es libre de no añadir ese nombre. Borrar un nombre, renombrarlo vía Name, moverlo con SheetIndex o vaciar la colección suelta el índice junto con todas las pistas, así que el siguiente clon vuelve al primer sufijo libre y rellena cualquier hueco que el cambio abriera
Para aplicaciones Delphi y C++Builder que generan o recalculan hojas grandes, el componente Excel HotXLS para Delphi y C++Builder usa este grafo de dependencias indexado en el motor de recálculo de sus dos clases de libro, la clásica y la XLSX