Cuando un PDF no incrusta una fuente, el componente HotPDF renderiza ese texto con una fuente de Windows instalada elegida por HPDFMapBaseFontToSystem: decodifica el nombre del /BaseFont, recorta la parte de estilo, prueba varias deletreaduras hasta que GDI confirma que la familia está instalada, mide los anchos que faltan de las standard 14 con fuentes métricamente compatibles, y convierte los códigos de un byte a Unicode antes de dibujar. Cada uno de esos pasos existe porque el enfoque obvio falla con archivos reales. El renderer de páginas RenderLoadedPageToBitmap lleva bien los programas incrustados; esta es la historia de las fuentes que no están en el archivo para nada
¿Por qué GDI dibuja en silencio el typeface equivocado para una fuente no incrustada?
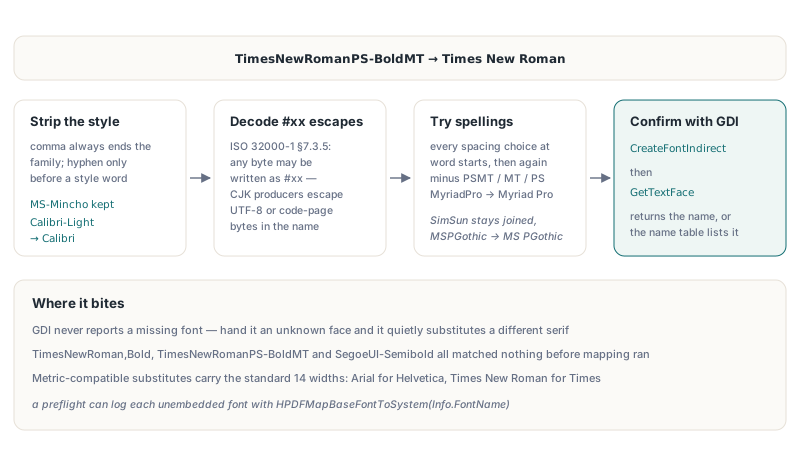
GDI jamás reporta una fuente ausente: pásele a CreateFontIndirect un nombre de cara que no conoce y selecciona en silencio un sustituto, a menudo una serif distinta sin peso bold. Pase el nombre PDF casi tal cual y TimesNewRoman,Bold, TimesNewRomanPS-BoldMT y SegoeUI-Semibold no emparejan con nada y salen con lo que GDI escoja. Los nombres pueden ser peores. ISO 32000-1 §7.3.5 permite que un nombre escriba cualquier byte como #xx, y los productores CJK deletrean habitualmente nombres de fuente como bytes UTF-8 escapados o de code pages legadas; un mapper que se salta el paso de decodificación le pide a GDI una cara llamada como los propios escapes. HPDFMapBaseFontToSystem decodifica primero los escapes, devuelve una secuencia de bytes UTF-8 válida como sus caracteres, y lee cualquier otro byte alto en la code page del sistema
Recortar el estilo es donde muerden las heurísticas. Una coma siempre cierra la familia (Arial,Bold da Arial), pero un guion solo lo hace cuando la palabra que va detrás es un estilo: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra o Condensed. Esa regla deja MS-Mincho entero mientras convierte Calibri-Light en Calibri. HotPDF prueba después deletreaduras de la familia, seguidas de deletreaduras de la familia con un sufijo PSMT, MT o PS quitado. Esas deletreaduras cubren cada elección de espacios en los sitios donde una palabra puede empezar: antes de una mayúscula que sigue a una minúscula (MyriadPro pasa a Myriad Pro), en la última mayúscula de una tanda que una minúscula sigue (UIGothic), y tras un MS inicial (MSPGothic), desde la forma totalmente espaciada hasta el nombre tal cual está escrito; pasados cuatro de esos sitios solo se prueban la forma espaciada completa y el nombre unido. El espaciado no se puede aplicar a ciegas, porque Windows conserva algunas palabras unidas: SimSun está instalado con exactamente esa deletreadura, mientras que MicrosoftYaHei, MicrosoftJhengHei y MSPGothic pertenecen a Microsoft YaHei, Microsoft JhengHei y MS PGothic. Un mapper que pone un espacio delante de cada mayúscula interior busca MicrosoftYaHei como Microsoft Ya Hei y jamás lo encuentra. Un candidato cuenta como instalado cuando CreateFontIndirect seguido de GetTextFace devuelve el nombre pedido, o cuando la tabla name de la fuente seleccionada lo lista como familia, nombre de familia completo o tipográfico en cualquier idioma; la respuesta se cachea por nombre, así que los documentos con muchas fuentes no instaladas no interrogan a Windows por cada nombre en cada página
Como la función de mapeo es pública en la unidad HPDFRenderFontMetrics, un informe de preflight puede mostrar con qué familia instalada se renderizará cada fuente sin incrustar, usando la enumeración de fuentes que THotPDF ya expone para documentos cargados:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
¿Cómo mide HotPDF las fuentes standard 14 que no tienen /Widths?
HotPDF mide los advances que faltan en la fuente instalada con las mismas métricas, porque ISO 32000-1 §9.6.2.2 permite a las fuentes standard 14 omitir los /Widths y la library no trae tablas AFM. Arial carga las métricas de Helvetica, Times New Roman las de Times y Courier New las de Courier, así que HPDFMeasureBaseFontWidths crea la cara correspondiente con lfHeight = -1000 y llama a GetCharWidth32W; a esa altura el resultado ya está en las unidades de 1/1000 de em que usan los anchos PDF. El renderer convierte primero cada código a Unicode por /Encoding, /BaseEncoding y /Differences, con StandardEncoding por defecto. El export SVG y la extracción de texto comparten una trampa más: una fuente Type 1 estándar sin /Encoding alguno sigue teniendo una StandardEncoding implícita, y un decoder construido sin ella no lleva información de codificación, así que todos los anchos medidos se quedan sin usar. HotPDF aporta la StandardEncoding implícita y la marca como codificación predefinida; enrutarla por la vía del nombre de CMap decodificaría cada código como 0, y cada ancho la seguiría
Bold, italic y los flags del descriptor de fuente numerados desde uno
La entrada /Flags de un descriptor de fuente numera sus bits desde 1, no desde 0, así que ForceBold es el bit 19 ($40000) e Italic es el bit 7 ($40), según la Tabla 123 de ISO 32000-1. El off-by-one es fácil de cometer: cuente desde cero y $20000 parece ForceBold, pero es el bit 18, SmallCap, y un test de peso sobre él renderiza en bold toda cara de versalitas. La trampa además se esconde bien, porque el /FontDescriptor es casi siempre una referencia indirecta: el código que solo lee objetos directos no llega jamás a la rama de flags, y la misma ceguera ignora /Widths 12 0 R y maqueta el texto con un advance de reserva. Resolver referencias indirectas y fijar las constantes de bits a la Tabla 123 van de la mano:
const
  // ISO 32000-1 Tabla 123 cuenta las posiciones de bit desde 1
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, no es un peso
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;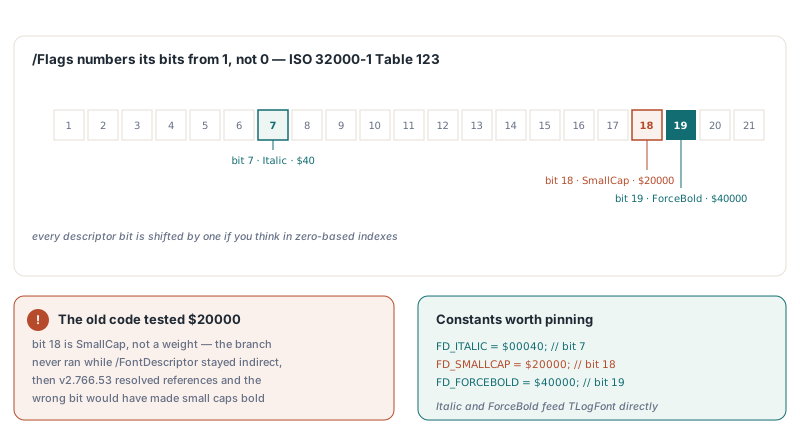
¿Por qué las fuentes CJK con un CMap UCS2 reciben anchos equivocados?
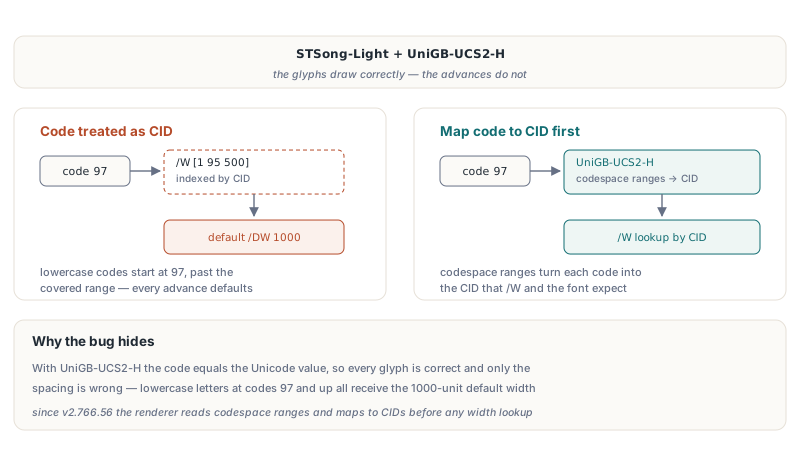
El texto CJK con un CMap UCS2 predefinido dibuja los glifos correctos con el espaciado equivocado cuando un renderer trata el código como el CID, porque /W está indexado por CID, no por código de carácter. Con STSong-Light y UniGB-UCS2-H el código coincide por casualidad con el valor Unicode, así que GDI dibuja los caracteres correctos y el error se esconde en los advances: las letras minúsculas llegan como códigos 97 en adelante, caen fuera de una entrada de /W como [1 95 500], y todas reciben el ancho por defecto /DW de 1000. El renderer de HotPDF lee los códigos por los rangos codespace del CMap (ISO 32000-1 §9.7.6.2) y los mapea a CIDs antes de consultar anchos. Trabaja a partir de las tablas UCS2 y UTF16 integradas y de los streams CMap incrustados; una aproximación de identidad para algo como GBK-EUC-H solo parecería soporte mientras produce salida equivocada, así que deliberadamente no se usa
¿Por qué los caracteres acentuados se vuelven interrogaciones en Windows chino?
Los códigos de un byte jamás deben llegar a las funciones GDI ANSI («A»), porque GetGlyphOutlineA y GetGlyphIndicesA interpretan los bytes en la code page del sistema mientras que TextOutA usa el juego de caracteres de la fuente seleccionada. En un sistema chino, el byte $A9 de Arial (el signo de copyright en Windows-1252) se convierte en byte guía GBK y renderiza como «?», y cualquier vía de contornos que llame a las funciones A se mete de cabeza en ello. HotPDF le pregunta a la fuente realizada su juego de caracteres con GetTextCharset, lo convierte a una code page por TranslateCharsetInfo, pasa el byte por MultiByteToWideChar y llama a las funciones W; las fuentes symbol usan U+F000 más el código en su lugar. Las codificaciones que discrepan de Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — se mapean a Unicode antes de que ninguna fuente del sistema las vea
¿Hasta dónde llega dibujar con fuentes del sistema?
El render con fuentes del sistema es una aproximación por naturaleza, y el Windows localizado añade una vuelta de tuerca: GetTextFace reporta el nombre de familia en el idioma del sistema, así que una comparación de nombres a secas daría por ausentes Microsoft YaHei en Windows chino o Yu Mincho en Windows japonés. Por eso una cara que vuelve bajo otro nombre también se busca en la tabla name de la fuente. La compatibilidad métrica existe para las familias Helvetica, Times y Courier; Symbol se mapea a Symbol y ZapfDingbats a Wingdings, que es un parche en lugar de un emparejamiento. El preflight de arriba recorre el diccionario /Resources de cada página, así que las fuentes referenciadas solo desde dentro de Form XObjects necesitan un pase propio. Cuando un código sigue sin poder dibujarse, el seguimiento de glifos sin resolver en el momento del dibujo lo reporta, que es una señal mejor que mirar miniaturas a ojo
La respuesta duradera está en el lado de la autoría. HotPDF escribe él mismo con FontEmbedding puesto en True por defecto, sustituyendo un Arial incrustado incluso cuando el código llama a SetFont con Helvetica, y el texto incrustado pasa por el renderer de glifos de fuentes incrustadas en lugar de por cualquiera de las adivinanzas de arriba. Una guardia barata para los archivos entrantes es avisar antes de renderizar cuando una familia mapeada no está en la lista de fuentes de pantalla:
// VCL: Screen.Fonts lista los nombres de familia instalados (unidad Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Para el componente completo, con render de páginas, extracción de texto y font subsetting en el lado de escritura, vea la página de producto de HotPDF Delphi PDF component