Un encoder de Reed-Solomon que guarda primero el término constante de su polinomio generador y luego divide primero por el término principal no está calculando corrección de errores en absoluto. HotPDF llegó a publicar exactamente eso en cuatro encoders de códigos 2D — QR, Data Matrix, PDF417 y Aztec — y todo símbolo que produjeron llevaba un bloque de comprobación que ningún escáner conforme podía usar
Lo interesante no es el desliz aritmético, sino la propagación. Un encoder se escribió primero, su bucle de división se copió en los otros tres, y cada formato nuevo heredó un defecto que nunca se había validado contra un solo vector de prueba publicado. Los símbolos seguían renderizándose, los finder patterns estaban en su sitio, los tamaños eran correctos. Solo los bytes que permiten a un código 2D sobrevivir a una mancha eran basura
Un polinomio invertido, copiado en cuatro encoders
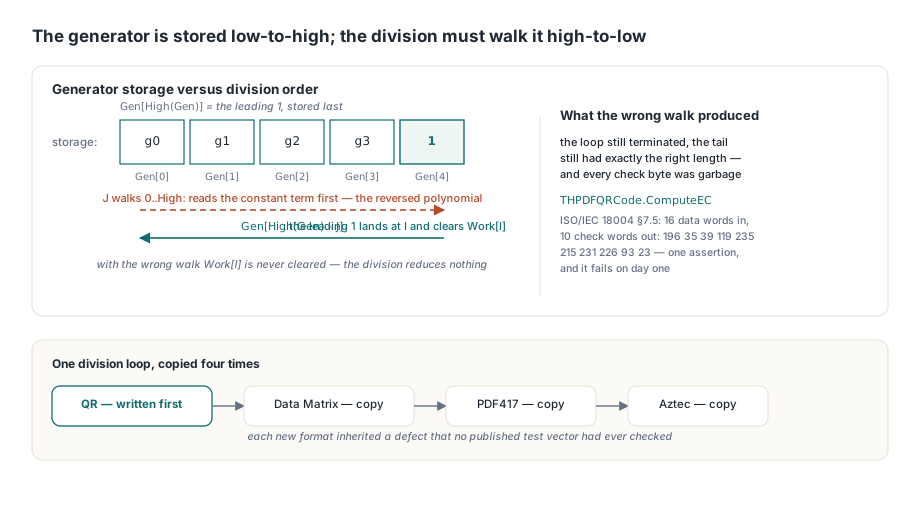
La causa raíz es un desajuste de orden de almacenamiento dentro del bucle de división sintética. Los cuatro encoders de HotPDF construyen el polinomio generador con los coeficientes de menor a mayor, así que Gen[0] guarda el término constante y Gen[High(Gen)] el coeficiente principal mónico. El bucle de división indexaba Gen[J] hacia adelante mientras recorría el mensaje, lo que aritméticamente es idéntico a dividir por el polinomio invertido. Hubo una segunda consecuencia que ocultó la primera: como el coeficiente principal nunca aterrizaba en la posición I, Work[I] nunca se ponía a cero, así que la división nunca reducía nada de verdad. El bucle igualmente terminaba e igualmente llenaba la cola con un array de exactamente la longitud correcta
// THPDFQRCode.ComputeEC en HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] es el término constante
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] es el 1 principal que pone Work[I] a cero; recorrer Gen
  // hacia adelante divide por el polinomio invertido en su lugar
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
El arreglo es la única expresión de índice Gen[High(Gen) - J]. Después de eso, THPDFQRCode.ComputeEC reproduce el ejemplo resuelto de la ISO/IEC 18004 §7.5: el bloque byte-mode 1-M de la versión 1 — 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 — produce las diez check words 196 35 39 119 235 215 231 226 93 23. Eso es una sola aserción, y habría fallado el primer día
¿Por qué el símbolo Aztec perdía también su payload?
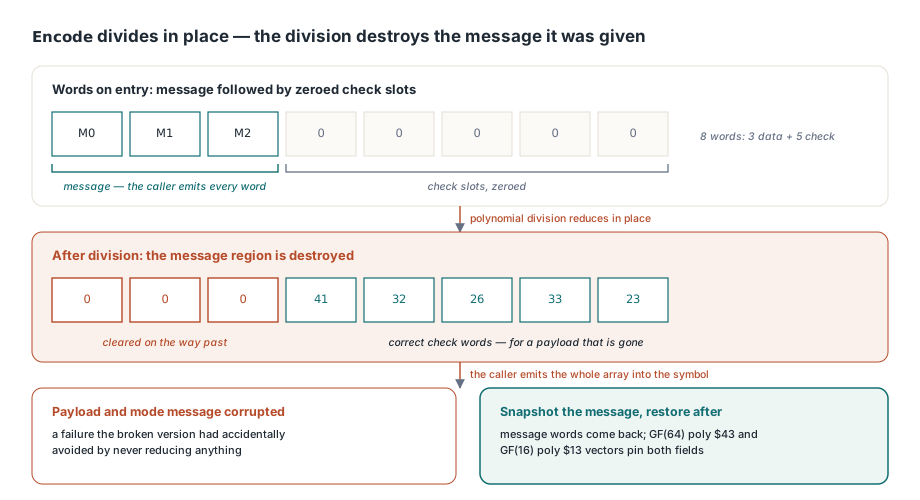
Aztec llevaba una versión más pesada del mismo bug porque TAztecGF.Encode divide in place. La rutina recibe Words con el mensaje seguido de huecos de check words a cero, y el llamador emite ese array entero al símbolo. La división polinómica destruye el dividendo mientras lo reduce, así que una vez que el bucle se corrigió para reducir de verdad, las palabras del mensaje se sobrescribían por el camino. Tanto el payload como el mode message salieron corruptos, un fallo que la versión rota había evitado por accidente al no reducir nunca nada
// TAztecGF.Encode en HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// La división pone a cero la región del mensaje, pero el llamador emite el
// array entero al símbolo, así que las palabras de datos tienen que volver
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec usa dos campos distintos, y el fixture de regresión ejercita ambos. En GF(64), el campo de un símbolo de seis bits construido con el polinomio primitivo $43, las palabras 12 45 3 con cinco check words producen 41 32 26 33 23 mientras que las tres primeras quedan intactas. En GF(16), el campo del mode message con el polinomio primitivo $13, las palabras 5 9 producen 11 15 6 8. Ambos pasan por el hook HPDFAztecTestEncode contra la ISO/IEC 24778
¿Qué hace que Data Matrix necesite dos arreglos en vez de uno?
THPDFDataMatrix.ComputeEC apiló un segundo error independiente encima del compartido: construía el polinomio generador con raíces empezando en α^0, mientras que el anexo E de la ISO/IEC 16022 especifica raíces desde α^1. Corregir solo el índice de división da las check words 146 107 90 179 128 para el ejemplo estándar, que parecen tan plausibles como las correctas y siguen siendo ilegibles. Los dos defectos tenían que desaparecer antes de que los números cuadraran
// THPDFDataMatrix.ComputeEC en HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: las raíces van de alpha^1..alpha^ECCount, no desde alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
El punto de referencia es tan pequeño que cabe en un comentario. La cadena '123456' se codifica en las ASCII code words 142 164 186, un símbolo de 10x10 lleva cinco check words, y el bloque correcto es 114 25 5 88 102. HPDFDataMatrixTestComputeEC expone la función de clase detrás de la puerta {$IFDEF HPDF_TESTING}, así que el fixture afirma esos cinco valores sin instanciar un encoder ni renderizar una página. El propio campo de Galois, construido por InitDMTables sobre el polinomio primitivo $12D en las tablas DMExp y DMLog, fue correcto todo el tiempo, que es exactamente por qué el bug se ocultó tan bien
PDF417 divide sobre un campo primo, donde los signos importan
PDF417 necesitaba cuatro cambios en vez de uno, porque GF(929) es un campo primo y no un campo de extensión binaria: la suma no es xor, la resta no es la suma, y el signo de cada factor del generador es aritmética real, no notación. Cada factor debe ser (x - 3^i), que en código significa multiplicar por 929 - GF929Pow(3, I); el paso de reducción debe restar; las raíces van desde 3^1 según la ISO/IEC 15438 §5.5; y Factor debe fijarse en una local antes de que corra el bucle interno, porque la pasada J = 0 escribe Work[I] y cambiaría el multiplicador debajo de sus propios pies. HPDFPDF417TestComputeEC fija el resultado corregido: las code words 5 453 178 121 239 con cuatro error correction words dan 452 327 657 619
// THPDFPDF417.ComputeEC en HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // el factor es (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 reescribe Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
El finder de Data Matrix estaba instalado del revés
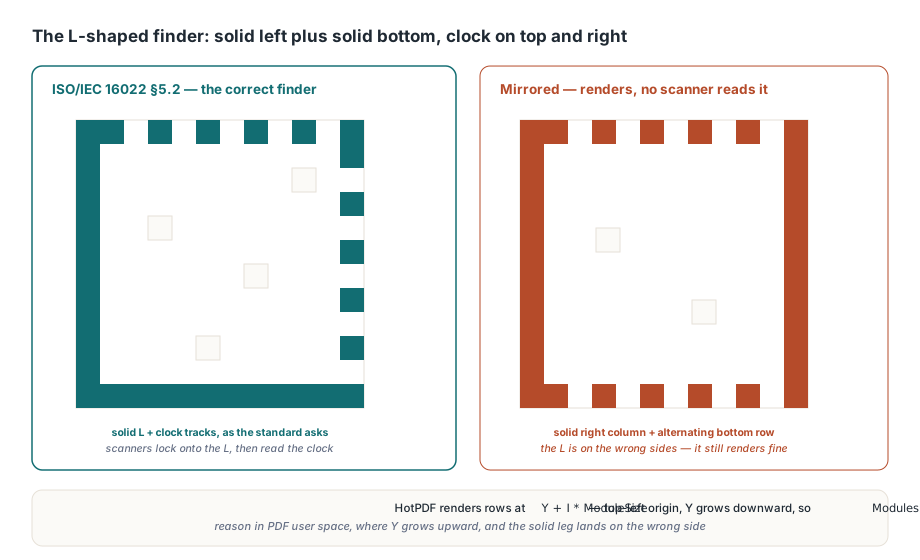
Las check words correctas no salvan un símbolo cuyo finder pattern está en espejo, y la misma versión tuvo que arreglar también eso. El código de colocación dibujaba una columna izquierda sólida, una columna derecha sólida y módulos alternados a lo largo de las filas superior e inferior, mientras que la ISO/IEC 16022 §5.2 pide una columna izquierda sólida más una fila inferior sólida — el finder en forma de L — con la pista de reloj alternada corriendo por la fila superior y la columna derecha. Lo que hace fácil equivocarse es la convención de coordenadas: HotPDF renderiza las filas de módulos en Y + I * ModuleSize, que es semántica de origen arriba a la izquierda, así que Modules[Size - 1, *] es la fila inferior del símbolo impreso. Cualquiera que razone en el user space de PDF, donde Y crece hacia arriba, pone la pata sólida en el lado equivocado y no ve nada sospechoso en pantalla
¿Por qué cuatro encoders rotos pasaron las pruebas durante años?
Porque las pruebas afirmaban estructura y los defectos estaban en la aritmética. Los casos existentes de QR, Data Matrix y Aztec comprobaban los módulos del finder, los timing patterns y las dimensiones del símbolo, todo lo cual era genuinamente correcto; ninguna prueba había comparado jamás una check word contra un vector publicado. La segunda razón se generaliza más. HotPDF trae un decoder QR integrado, y usarlo para validar el encoder parece un round trip obvio, salvo que este decoder lee las data code words y no hace ninguna corrección de Reed-Solomon, así que leía exactamente lo que el encoder escribía y reportaba éxito. Cuando un encoder y un decoder comparten una suposición, un test de round trip demuestra que coinciden, no que alguno tenga razón. Un código de corrección de errores hay que validarlo contra vectores impresos en el estándar, nunca contra tu propio decoder. El fixture THPDFBarcodeECCTests ahora tiene una prueba por formato, cada una nombrada por lo que fija, y cada una llega a la aritmética a través de un hook compilado solo bajo {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleafirma las diez check words del ejemplo byte-mode 1-M de la versión 1DataMatrixCheckWordsMatchISO16022Exampleafirma 114 25 5 88 102 para las code words 142 164 186PDF417CheckWordsMatchGF929Referenceafirma 452 327 657 619 sobre GF(929) con raíces de 3^1 a 3^4AztecCheckWordsKeepMessageAndMatchReferenceafirma las check words y que las palabras del mensaje sobreviven a la división in place
Cuatro preguntas atrapan a casi toda esta familia en cualquier encoder que mantengas. ¿Tu orden de almacenamiento del generador coincide con tu orden de índice de división, y puedes señalar la línea que lo demuestra? ¿Empiezan las raíces donde dice el estándar, α^1 para Data Matrix y 3^1 para PDF417? ¿Restaura después la división in place la región del mensaje? ¿Compara al menos una prueba check words — y no conteos de módulos — contra un número impreso en una especificación? El alcance también importa cuando decides qué hacer con los artefactos existentes. Los símbolos generados antes de la v2.748.0 se renderizan y a menudo se escanean en condiciones ideales, porque una imagen limpia no necesita corrección para leerse; lo que perdieron es la tolerancia al daño, que es la razón de ser de elegir estos formatos. Las etiquetas de larga vida y los documentos archivados con símbolos afectados merecen regenerarse en vez de comprobarse al azar con la cámara del móvil. Los encoders viven en el soporte de códigos de barras de HotPDF, junto al path de decodificación de QR y su manejo de orientaciones y la capa de salida de informes que coloca los símbolos en una página; la referencia completa de la API de barcode se distribuye con el HotPDF Delphi Component para Delphi y C++Builder