Un PDF que abre al instante desde un disco local puede tardar varios segundos en mostrar su primera página cuando los mismos bytes vienen de un servidor HTTP que responde peticiones de rango, aun cuando el archivo apenas ocupa unos megabytes y el enlace es rápido. El ancho de banda no es el problema. El recuento de peticiones sí, y la cura consiste en convertir cientos de lecturas diminutas y dispersas en unas pocas docenas de bloques cacheados, y luego leer por delante solo mientras el patrón de acceso siga secuencial
¿Por qué el mismo PDF carga al instante desde disco y se arrastra por HTTP?
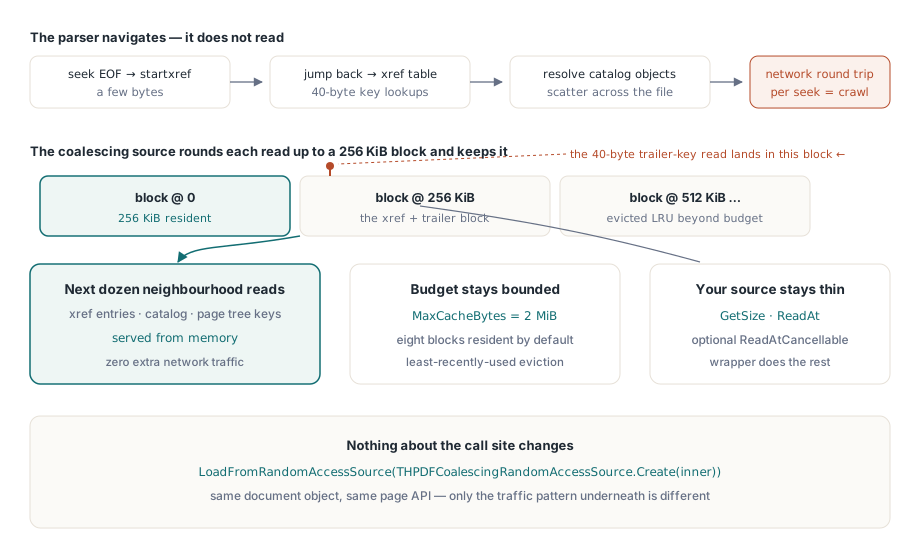
Un parser de PDF no lee un archivo de principio a fin. Lo navega. La estructura de ISO 32000-1 §7.5 pone el punto de entrada al final: el parser salta al último kilobyte buscando startxref, vuelve de salto a la tabla de referencias cruzadas, resuelve el diccionario trailer, sigue una referencia al Catalog, luego a la raíz del árbol de páginas, luego a un nodo de página, y luego al diccionario de recursos de esa página. Cada salto lee unas decenas de bytes de un offset distinto, y un archivo con actualizaciones incrementales repite el paseo una vez por revisión a través de la cadena de /Prev
Sobre un archivo local ese patrón es casi gratis, porque el sistema operativo ya sostiene en su caché de archivos la página de 4 KiB de alrededor y la segunda lectura cuesta una copia en memoria. Un transporte de red no tiene esa localidad. Cada lectura se vuelve una petición con su propia latencia, y la aritmética es brutal: a 40 ms por ida y vuelta, 300 lecturas pequeñas suman doce segundos de espera mientras el cable se queda mayormente ocioso. Leer menos no es opción, porque el parser necesita exactamente los bytes que pide. Lo que puede cambiar es cuánto trae de vuelta cada petición física
Envolver su transporte en THPDFCoalescingRandomAccessSource
HotPDF carga documentos desde cualquier clase que descienda de THPDFRandomAccessSource, y THPDFCoalescingRandomAccessSource se sienta entre esa clase y el parser. Cada lectura se redondea hacia fuera hasta un bloque alineado y el bloque se queda en memoria. BlockSize toma 262,144 bytes por defecto y MaxCacheBytes 2,097,152, así que ocho bloques permanecen residentes y el usado hace más tiempo se va cuando el presupuesto se llena. La búsqueda de 40 bytes de una clave del trailer arrastra los 256 KiB de alrededor, y la siguiente docena de lecturas en ese vecindario (entradas de referencias cruzadas, el Catalog, claves del árbol de páginas) salen de memoria
Su propia clase se mantiene delgada. Dos métodos son obligatorios: GetSize y ReadAt. Sobrescriba ReadAtCancellable cuando su cliente HTTP pueda abortar una petición en vuelo, y sobrescriba IsRangeAvailable cuando la fuente sea una descarga aún en curso. El wrapper hace esa pregunta antes de cada traída: si un bloque entero todavía no está, reintenta con solo los bytes pedidos, y si tampoco están la lectura vuelve corta en lugar de bloquearse
type
  // TMyHttpClient representa su propia clase de cliente HTTP
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    constructor Create(const AUrl: string);
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True: el wrapper libera Raw; bloques de 256 KiB, presupuesto de 8 MiB
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Cached.MaxReadAheadBlocks := 8;   // rango válido 1..32
  Pdf := THotPDF.Create(nil);
  try
    // OwnsSource=True otra vez: Pdf libera Cached, que libera Raw
    if Pdf.LoadFromRandomAccessSource(Cached, True) > 0 then
      RenderFirstPage(Pdf);   // código suyo
  finally
    Pdf.Free;
  end;
end;
El prefetch asíncrono y la read-ahead adaptativa vienen ambos activos en cuanto se construye el wrapper, así que el ejemplo solo toca el techo de la ventana. El constructor valida sus argumentos por adelantado: BlockSize debe estar entre 4,096 y 16,777,216 bytes y MaxCacheBytes debe sostener al menos un bloque, o si no obtiene un ERangeError antes de que se mueva un solo byte
No necesita estrictamente el wrapper explícito. Entregue a LoadFromRandomAccessSource una fuente llana y HotPDF la envuelve por usted, usando la política de caché cruda que puede leer y cambiar a través de GetCacheAdmissionPolicy y SetCacheAdmissionPolicy con la capa clkRawCompressed: ocho entradas, 2 MiB en total, 256 KiB por entrada. Pase su propio THPDFCoalescingRandomAccessSource y se usa exactamente como esté configurado. Para cualquier cosa que cruce una red, construya el wrapper usted mismo: obtiene las perillas de read-ahead y el registro de estadísticas completo, mientras que el camino automático reporta solo recuentos de hit, miss, admisión y expulsión a través de GetCacheAdmissionStatistics
¿Hasta dónde debe adelantarse la lectura?
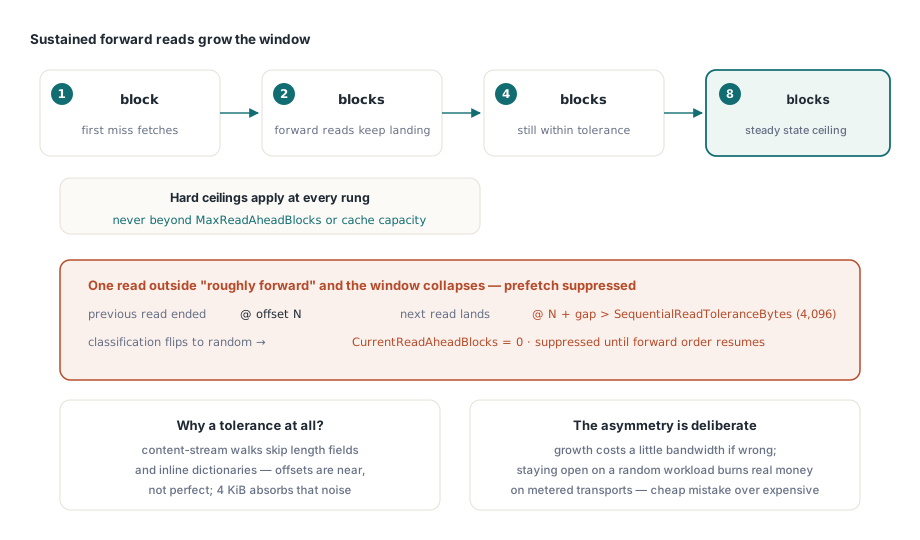
La read-ahead adaptativa decide por documento. Con AdaptiveReadAheadEnabled activado, cada lectura que el parser hace a través del documento cargado se clasifica como secuencial o aleatoria, y la ventana de prefetch sigue una puntuación. Dos lecturas hacia delante consecutivas abren la ventana a dos bloques, cuatro la abren a cuatro, seis la abren a ocho. La ventana nunca excede MaxReadAheadBlocks, y nunca excede el número de bloques que caben en MaxCacheBytes, así que una caché pequeña no puede ser inundada por su propio prefetch
Una lectura que salta hacia atrás, o que aterriza demasiado lejos del final de la lectura previa, deja la puntuación por debajo de cero. La ventana se cierra, cualquier prefetch que va hacia otro sitio se cancela, y SuppressedPrefetchCount sube. Dos lecturas hacia delante después la ventana reabre con un único bloque. Ese retardo es la gracia: una lectura contigua con suerte en medio de una persecución de referencias cruzadas no reinicia la especulación
SequentialReadToleranceBytes, 4,096 por defecto, define «demasiado lejos». Un parser que recorre un content stream no produce offsets perfectamente contiguos; se salta un campo de longitud aquí, un diccionario de imagen inline allí. Las lecturas que aterrizan dentro de la tolerancia del final anterior siguen contando como hacia delante. Póngalo demasiado bajo y un escaneo hacia delante normal se clasifica como aleatorio, así que la read-ahead nunca se activa. Póngalo demasiado alto y un acceso aleatorio genuino parece secuencial, y trae megabytes que nadie lee. El setter acepta cualquier valor desde cero hasta BlockSize y resetea la puntuación cuando cambia
El crecimiento es gradual, el colapso inmediato, y esa asimetría es deliberada. El sobre-almacenamiento en una carga de trabajo aleatoria quema ancho de banda real, y en un transporte con límite de datos dinero real; el sub-almacenamiento en uno secuencial cuesta unas idas y vueltas extra. Deje AdaptiveReadAheadEnabled activado. Apagado, el wrapper hace prefetch de un bloque tras cada lectura sin mirar el patrón, que es exactamente el comportamiento equivocado mientras el parser salta entre secciones de referencias cruzadas
La clasificación la dirige el stream del que HotPDF lee durante una carga. Si su propio código también tira de bytes a través del wrapper, por ejemplo para hashear un archivo o extraer un adjunto, llame a ObserveReadPattern con el offset y la longitud tras cada lectura para que la ventana reaccione también a ese tráfico. Cuando usted ya sabe qué bytes se querrán después, PrefetchRange arranca una traída en segundo plano directamente; IsPrefetchActive reporta si alguna sigue corriendo
Conservar los bloques calientes cuando la caché se llena
La expulsión least-recently-used llana tiene una debilidad conocida. Una sola pasada larga hacia delante, digamos a través de una imagen incrustada grande, empuja fuera cada bloque al que el parser vuelve una y otra vez, incluidos los bloques de referencias cruzadas y Catalog que necesitará otra vez en la página siguiente. THPDFCoalescingRandomAccessSource cuenta cuántas veces se ha pedido cada bloque, y una vez el presupuesto está lleno un bloque nuevo solo entra en la caché si se le ha pedido al menos tan a menudo como el bloque que reemplazaría. Si no, la lectura va directa a su fuente por exactamente los bytes pedidos, y RejectionCount y FrequencyRejectionCount lo registran
Esa regla viene activada por defecto (el argumento de constructor AdaptiveAdmission). ConfigureCacheAdmission cambia el presupuesto de bytes, el techo por entrada, un límite opcional de recuento de entradas y la regla de admisión sobre un wrapper vivo; cancela cualquier prefetch en marcha y recorta la caché a los nuevos límites en el momento
Cancelación que realmente detiene la transferencia
El prefetch corre en un único hilo de segundo plano, y el wrapper lo cancela en cuanto deja de merecer la pena terminarlo. Una lectura en primer plano de bytes fuera del rango en prefetch lo cancela, así que la página que el usuario pidió nunca espera detrás de tráfico especulativo. Una lectura aleatoria lo cancela. Destruir el wrapper, o llamar a CancelPrefetch o a ClearCache, lo cancela y espera a que el hilo salga. Cada una de estas cosas activa el THPDFCancellationToken que el hilo de prefetch pasa a su ReadAtCancellable
Si los bytes dejan de flujar de verdad depende de su sobrescritura. El ReadAtCancellable por defecto de THPDFRandomAccessSource consulta el token antes y después de un ReadAt llano, que basta para un recurso compartido de archivos pero deja que una respuesta HTTP de 256 KiB a medias corra hasta el final. Un cliente que lee el cuerpo de la respuesta en chunks puede consultar el token entre chunks y abortar:
function THttpRangeSource.ReadAt(Offset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  Result := ReadAtCancellable(Offset, Buffer, Count, nil);
end;

function THttpRangeSource.ReadAtCancellable(Offset: Int64; var Buffer;
  Count: Longint; CancellationToken: THPDFCancellationToken): Longint;
var
  Status: Integer;
begin
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
  // GetRange y su callback son la API de su cliente: envía
  // "Range: bytes=Offset-(Offset+Count-1)" y llama al callback entre chunks del cuerpo
  Result := FClient.GetRange(FUrl, Offset, Count, Buffer, Status,
    function: Boolean
    begin
      Result := (CancellationToken <> nil) and
        CancellationToken.IsCancellationRequested;
    end);
  // 200 en vez de 206 significa que el servidor ignoró Range y envió el archivo entero
  if Status <> 206 then
    raise EStreamError.CreateFmt('Range request not honored (HTTP %d)', [Status]);
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
end;
La comprobación del estado cubre la trampa que la mayoría de las fuentes HTTP pisan primero. RFC 9110 §14 permite a un servidor ignorar una cabecera Range y responder 200 con la representación completa, y algunas configuraciones de CDN y proxy hacen exactamente eso con ciertos archivos. Una fuente que copia los primeros Count bytes de una respuesta 200 le entrega al parser bytes del offset cero sin importar qué offset pidió. Los valores de retorno también importan: el wrapper lanza EStreamError si ReadAt reporta un recuento negativo o más bytes de los pedidos, y trata el cero como fin de datos
El único token no nil que su fuente recibe pertenece al hilo de prefetch. Las lecturas del parser durante una carga llegan a su ReadAtCancellable con token nil, así que detener la carga en sí es un interruptor aparte: asigne un token a THotPDF.OperationCancellationToken, y la carga del documento lo consulta por el camino. El mismo modelo de token dirige la cola descrita en renderizado en segundo plano con una cola de peticiones, así que un visor puede cancelar una carga, sus renders y su tráfico de red especulativo desde un único handler de cierre
Cómo leer las estadísticas de la caché de rangos
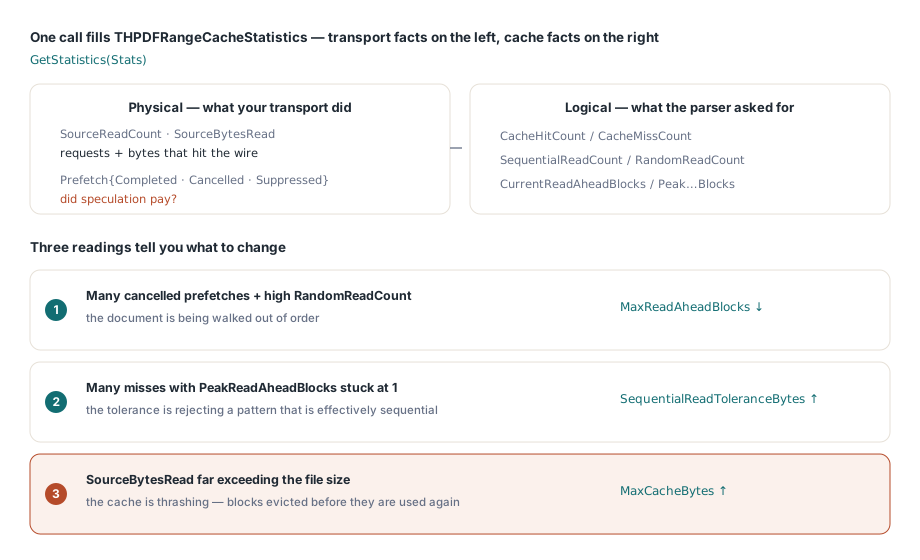
GetStatistics llena un registro THPDFRangeCacheStatistics que separa lo que hizo su transporte de lo que hizo la caché. SourceReadCount y SourceBytesRead son tráfico físico. CacheHitCount y CacheMissCount son tráfico lógico. SequentialReadCount y RandomReadCount muestran cómo se clasificó el patrón de acceso, CurrentReadAheadBlocks y PeakReadAheadBlocks muestran cuánto se abrió la ventana, y los cuatro contadores de prefetch muestran si la especulación rindió. CachedRangeCount, CachedBytes, EvictionCount y RejectionCount describen a la caché en sí
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d canceled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
  Log(Format('cache: %d blocks / %d bytes, %d evicted, %d rejected',
    [S.CachedRangeCount, S.CachedBytes, S.EvictionCount, S.RejectionCount]));

  // Rechazos acumulándose en un documento mayormente secuencial: dele más sitio
  if S.RejectionCount > S.CacheHitCount then
    Cached.ConfigureCacheAdmission(16 * 1024 * 1024, Cached.BlockSize, 0);
end;
Tres lecturas le dicen qué cambiar. Muchos prefetch cancelados junto a un recuento alto de lecturas aleatorias significan que el documento se está recorriendo fuera de orden, así que baje MaxReadAheadBlocks y deje de pagar por ancho de banda que tira. Muchos misses con la ventana pico clavada en 1 significan que la tolerancia está rechazando un patrón que en efecto es secuencial, así que suba SequentialReadToleranceBytes. Un SourceBytesRead muy por encima del tamaño del archivo significa que los bloques se expulsan antes de volver a usarse; suba MaxCacheBytes antes de tocar nada más. El umbral de rechazo del ejemplo es nuestra heurística de arranque, así que afínela contra su tráfico
Los ficheros linealizados cambian la aritmética
Si usted controla al productor, linealizar el documento cambia el problema en lugar de afinarlo. El Anexo F de ISO 32000-1 coloca los objetos de la primera página y una tabla de pistas al frente del archivo, así que un visor puede renderizar la página uno desde los bytes iniciales sin tocar el resto. HotPDF expone ese camino a través de GetProgressiveLinearizedLoadInfo y ReadProgressiveLinearizedFirstPageSection, que reciben ambos el mismo THPDFRandomAccessSource que usted envolvería para la fusión; el lado de escritura está cubierto en generar PDFs linealizados con tablas de pistas
Las dos técnicas se combinan. La fusión hace tolerable cualquier documento sobre un enlace lento, incluidos archivos de terceros que usted no puede volver a guardar; la linealización hace que la primera página llegue rápido en los documentos que usted produce. Los archivos en disco local demasiado grandes para sostenerlos en memoria son un problema distinto sin latencia de ida y vuelta que amortizar, y los caminos de archivo mapeado y lazy stream de el workflow de la API de archivo directo les van mejor
Las clases de fuente de acceso aleatorio, el wrapper de fusión, las políticas de admisión de caché y las llamadas de carga linealizada progresiva vienen todas con HotPDF, un componente PDF nativo para Delphi y C++Builder con código fuente completo. El licensing y la referencia completa de la API están en la página del componente PDF HotPDF para Delphi