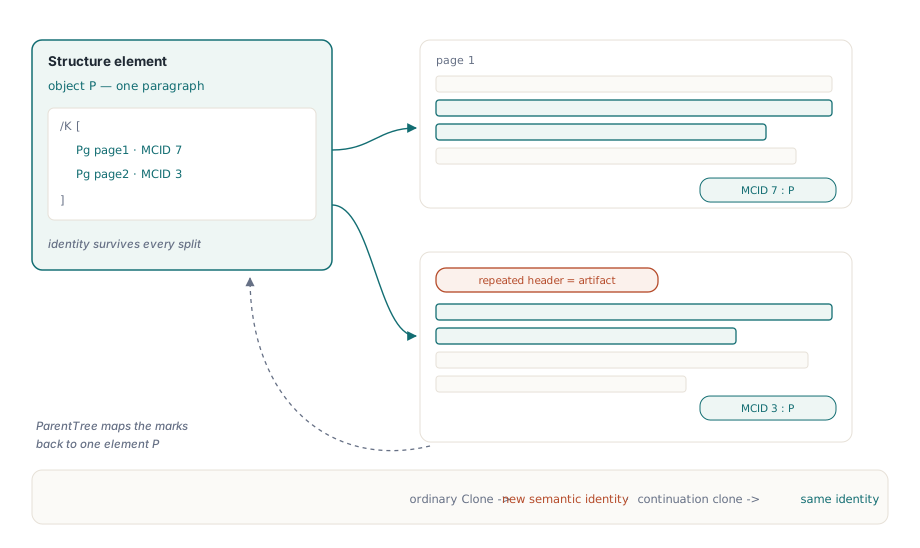
Un párrafo que empieza al final de la página 4 y termina al principio de la página 5 sigue siendo un solo párrafo para quien lo lee. En un PDF etiquetado vive en dos streams de contenido, y cada página numera sus secuencias de contenido marcado por su cuenta, así que el árbol de estructura necesita un único elemento P cuyo array /K apunte, por ejemplo, al MCID 7 de la página 4 y al MCID 3 de la página 5. Dibuje las páginas con código de coordenadas y añada el etiquetado después, y el árbol de etiquetas de un comprobador de accesibilidad normalmente mostrará dos párrafos donde había uno, más un juego de títulos de columna repetido dentro de los datos de cada tabla continuada
El enfoque por coordenadas tiene un segundo coste que llega antes. La primera versión de un informe funciona. Luego la dirección de un cliente crece a tres líneas, un encabezado localizado ocupa dos, una tabla gana cuarenta filas, y toda posición Y por debajo de ese punto queda mal. Las comprobaciones de salto de página acaban dispersas por la lógica de negocio, y un código que solo conocía X e Y no tiene ni idea de dónde empieza un párrafo cuando el requisito de accesibilidad aparece dos años después
Construir un árbol de diseño de HotPDF en Delphi
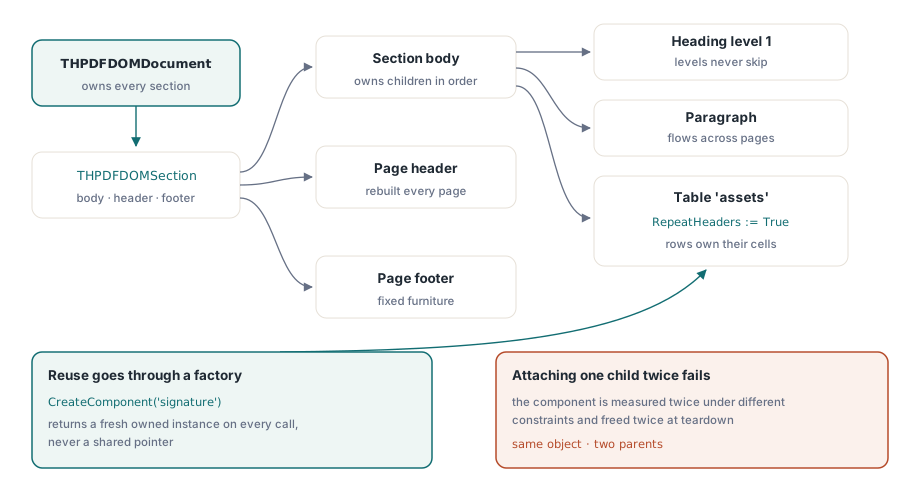
HotPDF responde a los dos problemas con un árbol de diseño declarativo en la unidad HPDFLayoutDOM. Un THPDFDOMDocument contiene secciones; cada THPDFDOMSection tiene un tamaño de página, márgenes, cabecera y pie opcionales, y una pila Body a la que se añaden texto, encabezados, espaciadores, listas, imágenes, contenedores y tablas. Nada en el árbol lleva una coordenada Y. THPDFDOMRenderer mide el árbol, decide los saltos de página, dibuja la cabecera y el pie en cada página y, como GenerateStructure vale True por defecto, va escribiendo el árbol de estructura sobre la marcha
La propiedad en el árbol es estricta. El documento posee sus secciones, una sección posee su cuerpo, cabecera y pie, y las pilas, los contenedores y las tablas poseen sus hijos, de modo que Section.Body.Add(Table) entrega la tabla para siempre. Un componente adjuntado a dos padres se mediría dos veces con restricciones distintas y se liberaría dos veces al desmontar. Las piezas repetidas como un bloque de firma salen por tanto de Clone, de SetHeaderClone / SetFooterClone, o de una factoría registrada con RegisterComponent, tras lo cual cada llamada a CreateComponent('signature') devuelve una instancia nueva
uses
  SysUtils, HPDFDoc, HPDFLayoutDOM;

type
  TAssetRow = record                    // su propio tipo de datos
    Name, ServiceDate, Status: WideString;
  end;

function BuildMaintenanceReport(const Assets: array of TAssetRow): THPDFDOMDocument;
var
  Doc: THPDFDOMDocument;
  Section: THPDFDOMSection;
  Heading: THPDFDOMText;
  Table: THPDFDOMTable;
  Row: THPDFDOMTableRow;
  I: Integer;
begin
  Doc := THPDFDOMDocument.Create;       // GenerateStructure = True, Language = 'en-US'
  try
    Section := Doc.AddSection;          // A4 vertical, márgenes de 36 pt por defecto
    Section.MarginLeft := 56;
    Section.MarginRight := 56;
    Section.Style.FontName := 'Helvetica';
    Section.Style.FontSize := 10;
    Section.Style.LineHeight := 13;
    Section.Body.Style.Spacing := 6;    // separación entre hijos del cuerpo
    Section.Footer := THPDFDOMText.Create('Plant maintenance - internal');

    Heading := Section.Body.AddHeading('Annual maintenance report', 1);
    Heading.Style.FontSize := 18;
    Heading.Style.LineHeight := 22;     // LineHeight no sigue a FontSize
    Section.Body.AddText('Every asset inspected during the reporting ' +
      'period is listed below, grouped by site.');

    Table := THPDFDOMTable.Create('assets');  // RepeatHeaders es True por defecto
    Table.AddColumn(3);                 // pesos, no anchos en puntos
    Table.AddColumn(1);
    Table.AddColumn(1);
    Row := Table.AddRow(18, True);      // las filas de cabecera van primero
    Row[0].Text := 'Asset';
    Row[1].Text := 'Last service';
    Row[2].Text := 'Status';
    for I := 0 to High(Assets) do
    begin
      Row := Table.AddRow(16);
      Row[0].Text := Assets[I].Name;
      Row[1].Text := Assets[I].ServiceDate;
      Row[2].Text := Assets[I].Status;
    end;
    Section.Body.Add(Table);            // el cuerpo es dueño de la tabla desde aquí
    Result := Doc;
  except
    Doc.Free;
    raise;
  end;
end;
Dos valores por defecto de ese listado pillan a la gente. LineHeight se resuelve a 12 puntos salvo que un estilo de la cadena lo fije, sin importar lo que diga FontSize, así que un encabezado de 18 pt sin LineHeight propio obtiene líneas de 12 pt y se solapa con el siguiente. Y una fila de tabla mide exactamente lo alto que se pasa a AddRow: el texto de la celda sale en una línea, así que dimensione las filas para la fuente que haya elegido
Render abre y cierra el documento por sí mismo
THPDFDOMRenderer.Render(Doc, Pdf) llama a BeginDoc sobre el destino, renderiza todas las secciones y llama a EndDoc antes de devolver el control. No lo envuelva en su propio par BeginDoc / EndDoc. Todo lo que haya que fijar antes de que empiece el documento va sobre la instancia de THotPDF: FileName, Title, y PDFUACompliance si la salida tiene que declarar PDF/UA. Cuando la generación de estructura está activa, Render también activa EnableTaggedPDF y copia Doc.Language en Pdf.Lang si lo dejó vacío
var
  Doc: THPDFDOMDocument;
  Pdf: THotPDF;
  Renderer: THPDFDOMRenderer;
  Stats: THPDFDOMRenderStatistics;
begin
  Doc := BuildMaintenanceReport(Assets);
  Pdf := THotPDF.Create(nil);
  Renderer := THPDFDOMRenderer.Create;
  try
    Pdf.FileName := 'maintenance-report.pdf';
    Pdf.Title := 'Annual maintenance report';
    Pdf.PDFUACompliance := True;        // también activa la comprobación del texto alternativo de figuras
    // Aquí no hay BeginDoc / EndDoc: Render abre y cierra el documento
    Stats := Renderer.Render(Doc, Pdf);

    Writeln(Format('%d page(s), %d placement(s), %d split(s)',
      [Stats.PageCount, Stats.PlacementCount, Stats.SplitCount]));
    Writeln(Format('structure elements=%d marked content=%d artifacts=%d',
      [Stats.StructureElementCount, Stats.MarkedContentCount,
       Stats.ArtifactCount]));
    Writeln(Format('header draws=%d footer draws=%d deepest chain=%d',
      [Stats.HeaderDrawCount, Stats.FooterDrawCount,
       Stats.MaximumContinuationDepth]));
  finally
    Renderer.Free;
    Doc.Free;
    Pdf.Free;
  end;
end;
Vuelque el registro de estadísticas en cada ejecución, porque muestra regresiones de plantilla que nunca provocan una excepción. Que SplitCount se dispare tras un cambio de plantilla suele significar que algún componente mide ahora más alto que el espacio en el que antes cabía. Que MaximumContinuationDepth crezca poco a poco apunta a un componente cuyo Split mueve demasiado poco contenido por página. ArtifactCount cubre cabeceras y pies de página, bordes decorativos como el marco de 0,5 pt por defecto de la tabla, y filas de cabecera repetidas, así que compárelo entre ejecuciones de la misma plantilla en lugar de contra un objetivo calculado a mano
¿Cómo pagina una tabla larga sin copiarse en cada página?
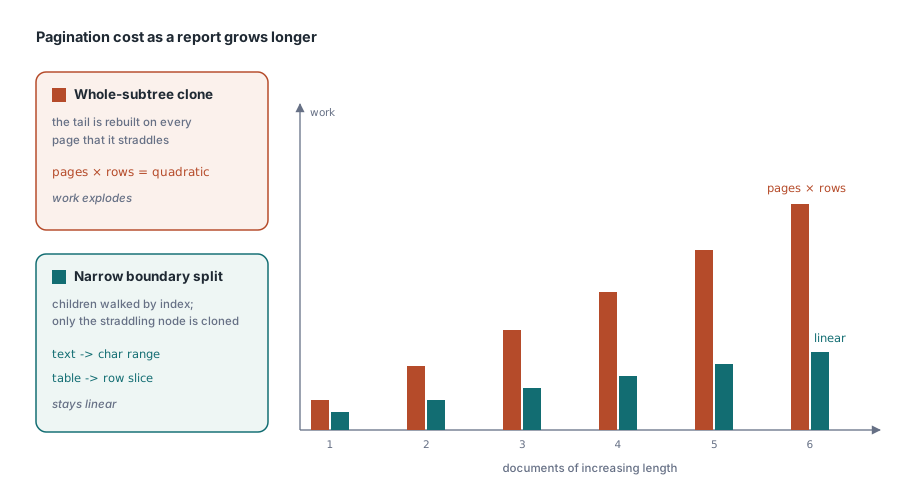
El renderizador solo divide lo que cruza el límite de página. La forma ingenua de paginar un árbol es clonar lo que no cupo y llevar la copia a la página siguiente; en una tabla de 10.000 filas eso clona las filas restantes una vez por página y convierte un trabajo lineal en uno cuadrático. HotPDF recorre los hijos del cuerpo por índice y nunca clona una sección o un cuerpo entero. Una pila o un contenedor anidado que cruza un límite de página solo tiene clonado su subárbol afectado, y los dos tipos de hoja pesados llevan un cursor en lugar de una copia
Un párrafo continuado es una referencia al texto original más el rango de caracteres que todavía debe, y reutiliza los saltos de línea ya calculados para ese ancho. Una tabla continuada es una referencia a la tabla original más la porción de filas que falta por colocar. Un párrafo de 300 líneas cuesta lo mismo si se parte una vez que si se parte cinco
La colocación en sí pasa por la rutina pública THotPDF.PlaceLayoutElement. Mide el elemento contra la altura de cuerpo restante, lo dibuja entero si cabe, y si no le pide que haga Split, vuelve a medir la mitad colocada, la dibuja y devuelve el resto como un objeto de desbordamiento que el renderizador lleva a una página nueva. Measure no debe dibujar nada nunca; puede ejecutarse varias veces para una sola colocación. El renderizador DOM añade a esa rutina el mobiliario de página, el espaciado entre hijos y las decisiones de página nueva
¿Por qué puede una sola fila de cabecera detener todo el renderizado?
Las cabeceras de tabla repetidas traen dos reglas, y las dos existen para evitar que un informe produzca páginas sin datos. Las filas de cabecera deben formar la primera racha de filas: AddRow(Height, True) después de cualquier fila de cuerpo lanza EInvalidOpException con "Table header rows must precede body rows". Y la primera división de una tabla debe dejar sitio para todas las filas de cabecera más al menos una fila de cuerpo. Una tabla que dejaría la cabecera varada al pie de una página se mueve a la página siguiente
La segunda regla tiene un filo duro. Si las filas de cabecera más una fila de cuerpo no caben ni siquiera en una página vacía, no hay página alguna en la que la tabla pueda empezar, y Render lanza "Layout component ... cannot fit an empty body page" con la ruta del componente, por ejemplo Sections[0]/Body/Items[2]/assets. Ese es el comportamiento que merece la pena tener. Un motor de diseño que siguiera añadiendo páginas con la esperanza de que la siguiente fuera más espaciosa convertiría una cabecera demasiado grande en un bucle que llena el disco
Los componentes personalizados reciben la misma protección. Herede THPDFDOMComponent, implemente Clone, Measure, Draw y Split, y el renderizador cuenta cuántas continuaciones produce cada hijo del cuerpo. Por encima de THPDFDOMRenderer.MaximumContinuationDepth (100.000 por defecto) el renderizado se detiene con "exceeded the continuation depth limit". Un Split que sigue devolviendo una cola equivalente, y por tanto nunca progresa, falla con una ruta de componente en lugar de ejecutarse hasta llenar el disco
En las páginas de continuación las filas de cabecera se dibujan de nuevo dentro de una secuencia de contenido marcado /Artifact, y el árbol de estructura conserva la TR original una sola vez. La extracción de texto por tanto no inserta una fila de cabecera duplicada entre las filas de datos, y la tecnología de asistencia no anuncia los títulos de columna otra vez en mitad de la tabla. Cada celda de cabecera se etiqueta TH con un atributo /Scope /Column
Un párrafo lógico, varios fragmentos de página
Un párrafo dividido sigue siendo un elemento de estructura P. Cada fragmento visible abre una nueva secuencia de contenido marcado en su propia página, y HotPDF añade un diccionario de referencia de contenido marcado, << /Type /MCR /Pg page /MCID n >>, al array /K de ese elemento y registra el MCID en la entrada del ParentTree de la página que apunta de vuelta al mismo elemento. Ese es el arreglo que describe la ISO 32000-1 §14.7.4 para elementos de contenido repartidos entre páginas, y es lo que permite que una vista de árbol de etiquetas muestre un párrafo donde las páginas muestran dos trozos
La identidad semántica es la razón de que las copias de continuación se comporten de forma distinta a sus propios clones. Llamar a Clone significa "contenido lógico nuevo", y el resultado recibe un elemento de estructura nuevo cuando se dibuja. Las copias hechas durante la paginación heredan la identidad del componente que continúan, así que una pila partida en tres páginas sigue produciendo un Div, y una lista partida en dos sigue produciendo una L. Las cabeceras y los pies de página siguen otro camino: se envuelven como /Artifact << /Type /Pagination /Subtype /Header >> (o /Footer) en cada página y nunca entran en el árbol de estructura
Reglas de estructura comprobadas mientras el árbol se renderiza
Con GenerateStructure activado, el renderizador rechaza la estructura que la validación PDF/UA rechazaría más tarde. El primer encabezado debe ser H1 y los siguientes no pueden saltarse un nivel, así que un H3 justo después de un H1 lanza "Semantic heading levels cannot skip an intermediate level". LI necesita un padre L, Lbl y LBody necesitan un LI, TR necesita una tabla o un grupo de filas, y TH / TD necesitan una TR. Cuando el destino tiene PDFUACompliance activado, una Figure sin texto alternativo también se rechaza. Cada violación detiene Render con una excepción
var
  List: THPDFDOMList;
  Bmp: TBitmap;                         // Vcl.Graphics
begin
  Section.Body.AddHeading('Findings', 2);     // H1 venía primero, así que H2 es legal

  List := THPDFDOMList.Create('Decimal');     // etiquetada como L, ListNumbering /Decimal
  List.AddItem('1.', 'Replace the intake filter on pump P-14');
  List.AddItem('2.', 'Re-torque the flange bolts on line 3');
  Section.Body.Add(List);                     // AddItem construye LI, Lbl y LBody

  Bmp := TBitmap.Create;
  try
    Bmp.LoadFromFile('site-plan.bmp');
    // La imagen copia el gráfico; un texto alternativo vacío falla con PDFUACompliance
    Section.Body.Add(THPDFDOMImage.Create(Bmp, 240, 160,
      'Site plan of plant 3 with the inspected pumps circled'));
  finally
    Bmp.Free;
  end;
end;
Comprobar durante el renderizado es el lugar adecuado para estas reglas. El momento es la razón. Un validador que informa de un texto alternativo ausente cuando el fichero ya está escrito le dice que hay que regenerar un lote de 10.000 declaraciones; una excepción durante Render nombra la regla que falló mientras el registro que la produjo sigue en el ámbito. La comprobación formal de conformidad sigue perteneciendo a la canalización, y como los objetos del documento siguen siendo legibles después de que Render devuelva el control, puede ejecutarse enseguida. La validación de PDF/A, PDF/X y PDF/UA cubre ese paso, y el orden de estructura y la extracción de texto muestra cómo el árbol de etiquetas gobierna lo que las herramientas de extracción leen de vuelta
Cuándo seguir dibujando a mano
El árbol dibuja sobre los mismos objetos THPDFPage que la API directa. Como Render es dueño del documento desde BeginDoc hasta EndDoc, el material colocado a mano, como una imagen de firma, pertenece a dentro del árbol: el Draw de un componente personalizado recibe la página y sus límites, y puede llamar allí a los métodos ordinarios de página. El cierre de página queda en manos de AddPage y EndDoc, así que con ImmediateFlushLayout activado en la instancia de THotPDF, las páginas terminadas se escriben a medida que avanza el renderizado y el renderizador no retiene ninguna página completada; la memoria depende entonces de las continuaciones abiertas, los recursos de fuente y el grafo de objetos del documento
El componente de texto del DOM parte las líneas a partir de un avance medio estimado de 0,55 × tamaño de fuente por carácter y da a cada línea el LineHeight resuelto. Así la medición se mantiene barata e idéntica en todas las máquinas, y es de sobra para informes impulsados por datos. El texto con glifos anchos, como mayúsculas, tramos en negrita o CJK, sale más ancho que la estimación, así que deje holgura en esos anchos de columna y pruebe la maquetación una vez con la cadena real más larga. Las páginas compuestas con métricas de glifo exactas, fuentes mezcladas en una misma línea o párrafos justificados salen mejor servidas por la API de texto directa; la justificación de texto recorre ese camino, y si lo único que duele es la paginación de tablas, generar tablas en PDF es el cambio más pequeño
El árbol de diseño, su renderizador, el etiquetado descrito aquí y la API de dibujo directa se incluyen en un solo componente para Delphi y C++Builder; las ediciones y la lista completa de funciones están en la página del componente PDF para Delphi de HotPDF