HotPDF puede guardar un documento cargado en una forma de diagnóstico pensada para que un humano la lea y la edite, y luego reparar el archivo después de que lo hayas editado. SaveLoadedDocumentDiagnostic escribe el documento con un orden determinista de los diccionarios, cada objeto como un objeto indirecto normal, sin object streams, sin cross-reference stream y sin linearización. RepairDiagnosticDocument reconstruye a continuación los desplazamientos de byte, las longitudes de flujo, la tabla de referencias cruzadas y el trailer que tu edición invalidó
Este par de funciones existe para un único flujo de trabajo: entender o corregir lo que realmente hay dentro de un PDF. Todo desarrollador que haya depurado un problema de renderizado ha querido abrir el archivo, cambiar un número en un diccionario, y ver el resultado. En un PDF normal eso es imposible, porque el contenido está comprimido en object streams y cada byte que insertas desplaza unos offsets que una tabla de referencias cruzadas registra con exactitud
¿Qué diferencia a un guardado de diagnóstico?
Seis ajustes cambian a la vez. Las claves de los diccionarios se escriben en un orden determinista, de modo que dos guardados del mismo documento producen archivos comparables. El modo de salida de diagnóstico anota la estructura. Se fuerza una reescritura completa, así que nada se arrastra como una revisión incremental sin tocar. La linearización se desactiva, ya que un archivo linearizado está organizado para un visor web y no para un lector humano. Los cross-reference streams se desactivan, de modo que la tabla queda en texto plano. Y los object streams se desactivan, así que ningún objeto queda oculto dentro de un contenedor comprimido
El resultado es un archivo cuya cabecera lleva un marcador de diagnóstico junto a la firma habitual %PDF-, y cuyo cuerpo puedes recorrer página a página en cualquier editor. Los objetos aparecen uno tras otro, los diccionarios son legibles y los flujos de contenido están donde puedes encontrarlos. La herramienta de reparación comprueba ese marcador y rechaza los archivos que no lo tienen, porque la estructura compacta de un PDF normal no es algo que un reparador por rangos de bytes deba intentar interpretar

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Legible, un objeto por bloque, nada oculto en object streams
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
¿Por qué la edición rompe el archivo, y qué hay que reconstruir?
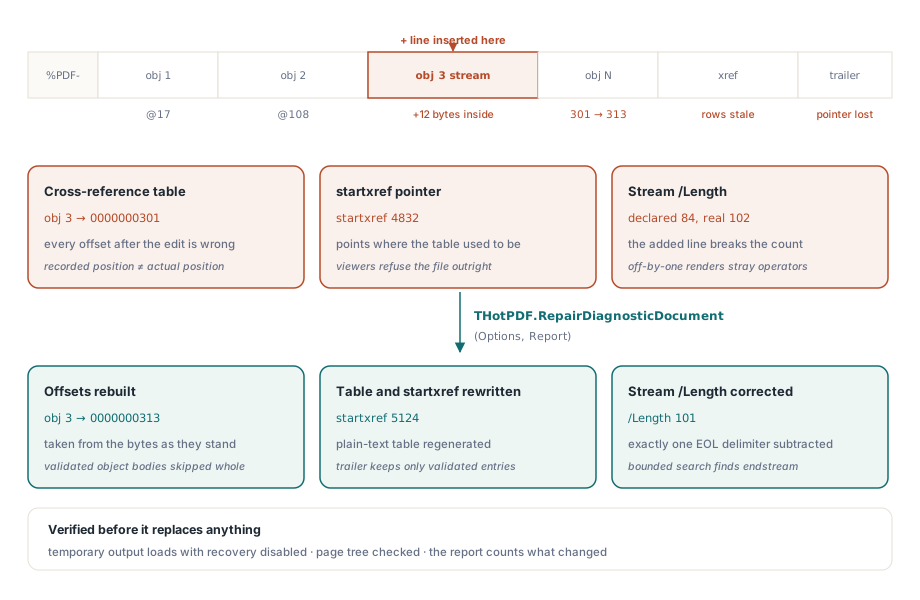
Tres cosas en un PDF codifican posiciones o recuentos de bytes. La tabla de referencias cruzadas asocia cada número de objeto a un offset de byte. El valor startxref al final del archivo apunta a esa tabla. Y cada diccionario de flujo lleva un /Length que indica cuántos bytes ocupa el cuerpo del flujo
Cambia un solo carácter en cualquier punto antes del final del archivo y los offsets posteriores quedan mal. Añade una línea a un flujo de contenido y su /Length también queda mal. La mayoría de los visores rechazarán el archivo, y los que lo recuperan lo hacen escaneando, lo que oculta el error en vez de corregirlo. La reparación reconstruye los tres elementos a partir de lo que los bytes dicen ahora realmente
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // carga el resultado antes de reemplazar

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Copiar bytes, no volver a serializar
La decisión de diseño que hace confiable a esta herramienta es que nunca carga el documento para volver a escribirlo. Copia los rangos de bytes de los objetos que ha validado, cambia únicamente los valores de /Length que están mal, y reconstruye a su alrededor la tabla, el trailer y el startxref
Cargar y volver a serializar sería mucho más fácil de implementar, pero cambiaría cosas en silencio. La sintaxis de objetos desconocidos se normalizaría, los escapes de cadenas se reescribirían en la forma preferida del escritor, y las cargas útiles de flujo ya codificadas podrían recodificarse. Para una herramienta de depuración eso es inaceptable: editaste un número, y el diff debería mostrar un número, no mil cambios de formato incidentales. Si quieres saber exactamente qué cambió entre dos archivos, ese es un problema de comparación, tratado en comparar dos archivos PDF por estructura y por píxeles

Las dos reglas de análisis que evitan objetos falsos
Un escáner por rangos de bytes se enfrenta a una trampa evidente: un texto con aspecto de cabecera de objeto puede aparecer dentro de la carga útil de un flujo o dentro de una cadena. Un escaneo ingenuo emitiría una fila de referencia cruzada que apuntara al medio de un flujo de contenido, y el archivo resultante quedaría roto de una forma nueva y más confusa
HotPDF evita esto saltándose todo el rango de bytes de cada objeto validado, usando su offset de fin registrado, de modo que nada dentro del cuerpo de un objeto se considera nunca un candidato. Entre objetos solo se permiten espacios en blanco y comentarios de PDF; cualquier otra cosa significa que la región no se entiende y sus bytes no deben incorporarse a la salida
Las longitudes de flujo requieren el mismo cuidado. La longitud real de la carga útil excluye el delimitador de fin de línea que un escritor inserta antes de endstream. Cuando la longitud declarada cae exactamente sobre el marcador, esa declaración se acepta. Cuando no lo hace, el reparador realiza una búsqueda acotada del par endstream y endobj y resta exactamente un delimitador: un CR, un LF o un CRLF. Equivocarse en esto por un solo byte produce un archivo que se abre y renderiza una página con un operador suelto al final de su flujo de contenido
Qué se le permite conservar al trailer
El trailer reconstruido no es una copia del anterior. /Size, /Prev y /XRefStm describen todos ellos la disposición anterior del archivo y se recalculan o se descartan. Solo sobreviven las entradas cuyos destinos se han validado: /Info, /ID y /Encrypt. Y /Root debe resolverse en exactamente un objeto Catalog — ni cero ni varios, que es lo que suele producir un archivo ensamblado copiando y pegando bloques de objetos
La seguridad de la salida se gestiona como corresponde a una herramienta que opera sobre archivos que le importan a la gente. El resultado se escribe en un archivo temporal dentro del directorio de destino, y luego se verifica cargándolo por la ruta normal con la recuperación de referencias cruzadas desactivada, de modo que un archivo que solo abre gracias a la recuperación cuenta como un fallo. Solo después de que el árbol de páginas se verifique, el archivo temporal reemplaza de forma atómica al destino. Una reparación fallida nunca sobrescribe una salida existente
Presupuestos y códigos de fallo honestos
Tres límites acotan el trabajo: bytes de entrada, número de objetos candidatos y número de objeto máximo, con valores por defecto de 8 GiB, dos millones y dos millones. El límite del número de objeto importa más de lo que parece, porque una tabla dispersa con unos pocos objetos numerados en los miles de millones inflaría enormemente la tabla de referencias cruzadas reconstruida si no existiera. Las tablas de referencias cruzadas clásicas también rechazan offsets que necesitarían más de diez dígitos decimales, lo cual es un límite del formato y no una decisión de implementación
Los fallos reportan un estado específico en lugar de un booleano: argumentos no válidos, origen demasiado grande, no es un archivo de diagnóstico, límite de objetos superado, objeto no válido, objeto duplicado, catálogo ausente, trailer no válido, error de salida, o validación fallida. Cada uno corresponde a una corrección distinta. Un objeto duplicado significa que pegaste un bloque de objeto dos veces. Un catálogo ausente suele significar que el objeto que contiene /Type /Catalog resultó dañado. Validación fallida significa que la estructura ya es consistente pero el árbol de páginas no carga, lo cual suele deberse a un array /Kids editado sin sincronizar con su /Count
Dos notas prácticas cierran el ciclo. Conserva el archivo de diagnóstico, no solo el reparado, para que la siguiente edición parta de una base legible. Y no entregues salida de diagnóstico a los usuarios finales: es más grande que un guardado normal porque nada está comprimido en object streams, y la ruta de producción para un archivo compacto es la ruta de guardado ordinaria descrita en object streams y actualizaciones incrementales. Cuando el objetivo es encontrar qué está mal en lugar de cambiarlo, la ruta automatizada de automatización de informes preflight responde más rápido que leer bytes
El guardado de diagnóstico, la reparación, el preflight y la comparación operan todos sobre el mismo modelo de documento cargado en Delphi y C++Builder; la lista completa de funciones está en la página del componente HotPDF Delphi PDF