Tu código de detección informa de que un fichero PDF/UA de otro productor no declara nada, y un escaneo PDF/R deja de ser PDF/R en el momento en que un editor añade una nota adhesiva. HotPDF lee estas declaraciones de un documento cargado mediante accesores como IsLoadedPDFUA, GetLoadedPDFR1Version y GetLoadedPDFDeclarations, cada uno de los cuales mira donde su propio estándar guarda el identificador
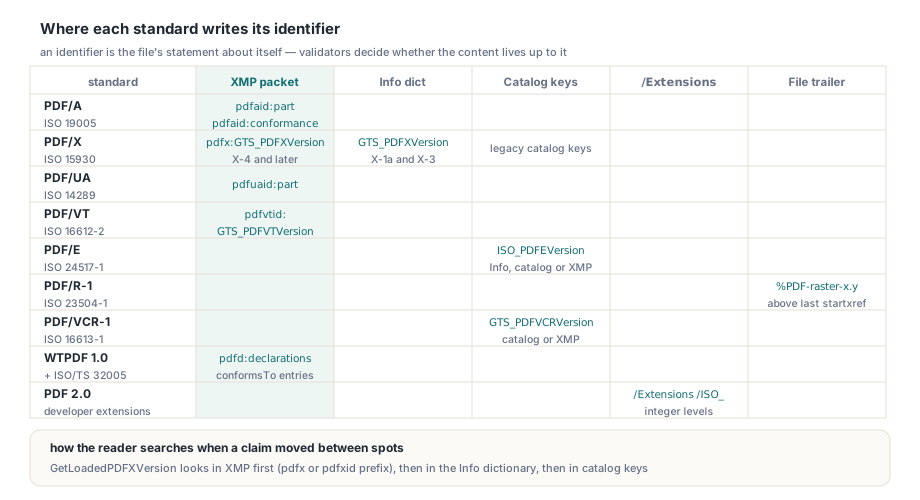
Dónde escribe su identificador cada estándar PDF
Los estándares subsidiarios nunca acordaron un único lugar para la declaración. La mayoría usa propiedades XMP en el flujo /Metadata del catálogo, unos cuantos antiguos siguen apoyándose en claves del diccionario de información del documento, PDF/R pone una línea de comentario junto al tráiler del fichero, y la generación PDF 2.0 añade dos mecanismos más: diccionarios de extensión de desarrollador en el catálogo y PDF Declarations dentro del XMP. Un identificador es la declaración del fichero sobre sí mismo; si el contenido está a la altura lo decide un validador, y producir salida PDF/A, PDF/X y PDF/UA conforme es un tema aparte. Para el enrutamiento (cola de impresión para PDF/X, archivo para PDF/A, pipeline de accesibilidad para WTPDF) lo que necesitas es la declaración, leída desde el sitio correcto:
| Estándar | Dónde vive la declaración | Accesor de HotPDF |
|---|---|---|
| PDF/A (ISO 19005) | XMP pdfaid:part y pdfaid:conformance, más pdfaid:rev en PDF/A-4 | IsLoadedPDFA, GetLoadedPDFAVersion, GetLoadedPDFARevision |
| PDF/X (ISO 15930) | GTS_PDFXVersion en el diccionario Info para PDF/X-1a y PDF/X-3, en XMP para las partes posteriores | IsLoadedPDFX, GetLoadedPDFXVersion |
| PDF/UA (ISO 14289) | XMP pdfuaid:part | IsLoadedPDFUA, GetLoadedPDFUAVersion |
| PDF/VT (ISO 16612-2) | XMP pdfvtid:GTS_PDFVTVersion | IsLoadedPDFVT, GetLoadedPDFVTVersion |
| PDF/E (ISO 24517-1) | ISO_PDFEVersion, leído del diccionario Info, del catálogo o del XMP | IsLoadedPDFE, GetLoadedPDFEVersion |
| PDF/R-1 (ISO 23504-1) | comentario %PDF-raster-x.y justo encima del último startxref | IsLoadedPDFR1, GetLoadedPDFR1Version |
| PDF/VCR-1 (ISO 16613-1) | GTS_PDFVCRVersion en el catálogo o en XMP | IsLoadedPDFVCR, GetLoadedPDFVCRVersion |
| WTPDF 1.0, ISO/TS 32005 | entradas pdfd:declarations en XMP | IsLoadedWTPDF, GetLoadedWTPDFVersion, IsLoadedISO32005 |
| PDF 2.0 developer extensions | /Extensions /ISO_ en el catálogo | HasLoadedISODeveloperExtension, GetLoadedISODeveloperExtensionLevels |
uses
  System.SysUtils, HPDFDoc;

procedure ReportClaims(const FileName: string; const Password: AnsiString);
var
  Pdf: THotPDF;
  PDFX, PDFXLevel: AnsiString;
begin
  Pdf := THotPDF.Create(nil);   // una instancia dedicada, usada solo para inspección
  try
    // La sobrecarga con contraseña descifra los flujos, paquete XMP incluido;
    // pasa una cadena vacía para los ficheros que abren sin preguntar
    if Pdf.LoadFromFile(FileName, Password) <= 0 then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);

    if Pdf.IsLoadedPDFA then
      Writeln('PDF/A: ', Pdf.GetLoadedPDFAVersion);        // p. ej. PDF/A-2b
    PDFX := Pdf.GetLoadedPDFXVersion;                       // primero XMP, luego Info
    if PDFX <> '' then
    begin
      PDFXLevel := Pdf.GetLoadedInfoKeyValue('GTS_PDFXConformance');
      if PDFXLevel <> '' then
        Writeln('PDF/X: ', PDFX, ', conformance ', PDFXLevel)
      else
        Writeln('PDF/X: ', PDFX);
    end;
    if Pdf.IsLoadedPDFUA then
      Writeln('PDF/UA: ', Pdf.GetLoadedPDFUAVersion);      // p. ej. PDF/UA-1
    if Pdf.IsLoadedPDFVT then
      Writeln('PDF/VT: ', Pdf.GetLoadedPDFVTVersion);
    if Pdf.IsLoadedPDFE then
      Writeln('PDF/E: ', Pdf.GetLoadedPDFEVersion);
    if Pdf.IsLoadedPDFR1 then
      Writeln('PDF/R: ', Pdf.GetLoadedPDFR1Version);       // p. ej. PDF/R-1.0
    if Pdf.IsLoadedWTPDF then
      Writeln('WTPDF: ', Pdf.GetLoadedWTPDFVersion);
  finally
    Pdf.Free;
  end;
end;
Usa una instancia THotPDF separada para la inspección, como hace el ejemplo. Las funciones IsLoaded… responden por el documento que el componente tenga cargado, incluido uno que esté construyendo: IsLoadedPDFUA también es True cuando PDFUACompliance se ha activado para la salida, y IsLoadedPDFX concuerda con un PDFXCompliance no vacío. Cómodo a mitad de construcción, pero en un componente reutilizado para los dos trabajos mezcla tus ajustes de salida en el veredicto sobre el fichero de otro
PDF/X es la única familia cuyo identificador se mudó entre partes. PDF/X-1a y PDF/X-3 son perfiles PDF 1.3 que ponen GTS_PDFXVersion en el diccionario de información del documento y no necesitan nada de XMP, mientras que PDF/X-4 y las partes posteriores exigen la propiedad XMP pdfx:GTS_PDFXVersion. GetLoadedPDFXVersion mira primero en el XMP, bajo el prefijo pdfx o el pdfxid, luego en el diccionario Info, después en las claves de catálogo que escriben algunos productores antiguos, y devuelve el valor declarado sin tocar. PDF/X-1a tiene una arruga que conviene programar: su valor de versión es PDF/X-1:2001, y el nivel de conformidad PDF/X-1a:2001 vive en una clave propia, /GTS_PDFXConformance, que el ejemplo lee con GetLoadedInfoKeyValue cuando necesita distinguir X-1a del X-1 llano
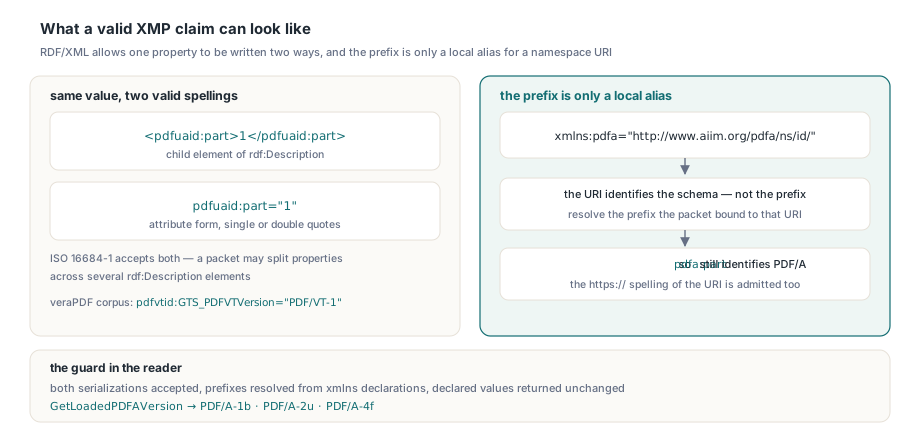
¿Cómo es una declaración XMP válida?
El XMP es RDF serializado como XML, y RDF/XML permite escribir una propiedad simple de dos maneras dentro de un rdf:Description: como elemento hijo, <pdfuaid:part>1</pdfuaid:part>, o como atributo de la propia descripción, pdfuaid:part="1", con comillas simples o dobles. La ISO 16684-1 acepta ambas, y un paquete puede repartir sus propiedades entre varios elementos rdf:Description. La división no es hipotética. HotPDF escribe la forma de elemento hijo para PDF/UA, PDF/VT, PDF/E y PDF/X, mientras que el corpus de pruebas de veraPDF y muchos productores externos escriben la forma abreviada, con descripciones como pdfuaid:part="1" o pdfvtid:GTS_PDFVTVersion="PDF/VT-1" que llevan la declaración entera en atributos. Un detector construido alrededor de Pos('<pdfuaid:part>', Xmp) y ejercitado solo con salida propia pasa todas las comprobaciones locales y luego declara sin identificador la primera muestra de veraPDF. El lector XMP de HotPDF maneja las dos formas en cada accesor de la tabla. GetLoadedPDFAVersion combina pdfaid:part y pdfaid:conformance en identificadores como PDF/A-1b, PDF/A-2u, PDF/A-4 o PDF/A-4f, y GetLoadedPDFARevision devuelve pdfaid:rev, el año de edición que PDF/A-4 exige (2020) y que las partes 1 a 3 no definen:
procedure ReportPDFALevel(Pdf: THotPDF);
var
  Level, Revision: AnsiString;
begin
  Level := Pdf.GetLoadedPDFAVersion;      // 'PDF/A-1b', 'PDF/A-2u', 'PDF/A-4f', ...
  if Level = '' then
    Exit;
  Revision := Pdf.GetLoadedPDFARevision;  // '2020' para PDF/A-4, vacío para las partes 1-3
  if Revision <> '' then
    Writeln(Level, ', edition ', Revision)
  else
    Writeln(Level);
  // Esperado: "PDF/A-2b" tanto si el productor escribió
  // <pdfaid:part>2</pdfaid:part> o pdfaid:part="2"
end;
Los prefijos son la otra parte móvil. En XML el prefijo es solo un alias local; lo que identifica al esquema PDF/A es el URI de espacio de nombres http://www.aiim.org/pdfa/ns/id/, que las erratas aprobadas de ISO 19005-4 admiten también en su grafía https://, y un productor puede ligarlo al prefijo que quiera. GetLoadedPDFAVersion busca el prefijo que el paquete declara para ese URI antes de leer parte y nivel, de modo que un paquete que escriba pdfa:part en lugar de pdfaid:part también se identifica. Cualquier otra propiedad XMP que leas tú mismo del paquete decodificado que devuelve GetLoadedXMPMetadata merece el mismo cuidado: las dos serializaciones, el prefijo resuelto desde su declaración xmlns, y espacio en blanco permitido alrededor del signo igual
Los ficheros cifrados esconden la declaración a las búsquedas de bytes
Un escaneo del fichero en bruto buscando pdfaid o ISO_PDFEVersion se salta el parseo y falla en dos casos ordinarios. La mayoría de los flujos XMP van comprimidos con Flate, así que los nombres de propiedad nunca aparecen como texto en disco. Y en un documento cifrado el flujo de metadatos es texto cifrado: la ISO 32000-2 §7.6.4.2 define EncryptMetadata con valor por defecto true, de modo que salvo que el productor renunciara expresamente, el paquete va cifrado junto con todos los demás flujos. Una búsqueda de bytes contra un fichero PDF/E-1 cifrado informa por tanto de que falta la declaración ISO_PDFEVersion aunque esté ahí. El orden fiable es cargar, descifrar, decodificar y después buscar. Abre el fichero por la sobrecarga con contraseña, LoadFromFile(FileName, Password), y pasa una cadena vacía para los ficheros que solo llevan contraseña de propietario y abren en cualquier visualizador sin preguntar. La LoadFromFile(FileName) de un solo argumento carga la estructura del documento sin descifrar sus flujos, lo que deja el paquete XMP ilegible; tras la sobrecarga con contraseña, GetLoadedXMPMetadata y todos los accesores de arriba trabajan sobre el paquete descifrado y descomprimido
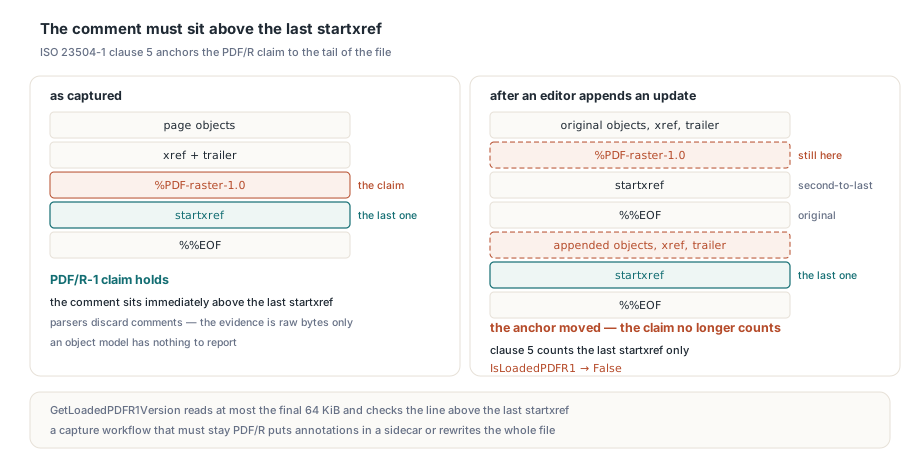
¿Por qué un fichero PDF/R pierde su identidad tras una edición?
PDF/R-1 se identifica de una manera que ningún otro estándar subsidiario practica. La cláusula 5 de la ISO 23504-1 exige una línea de comentario con el texto %PDF-raster-1.0 (o la versión que toque) en la línea inmediatamente anterior a la última línea que contiene startxref. Un parser PDF tira los comentarios mientras lee los datos de referencias cruzadas, así que un modelo de objetos no tiene nada que informar; la evidencia existe solo en los bytes en bruto al final del fichero. GetLoadedPDFR1Version vuelve a la fuente de la que se cargó el documento, lee como mucho los últimos 64 KiB, encuentra el último startxref y comprueba la línea de encima. Ahora sigue una actualización incremental. Un editor que añade una anotación agrega objetos nuevos, una nueva sección de referencias cruzadas, un nuevo tráiler y un nuevo startxref tras el %%EOF original. La línea %PDF-raster-1.0 sigue en el fichero, pero ahora se sienta sobre el penúltimo startxref, y el estándar no deja lugar a dudas sobre cuál cuenta. Esperado: IsLoadedPDFR1 devuelve False tras la edición, salvo que la herramienta de edición vuelva a emitir el comentario en su propia actualización. Un detector que escanee el fichero entero buscando %PDF-raster- diría que sí, y por la regla de la cláusula 5 esa respuesta está mal. Un flujo de captura que deba mantener sus ficheros como PDF/R manda las anotaciones a un fichero sidecar o a una herramienta que reescribe el fichero entero como PDF/R
Extensiones de desarrollador: niveles enteros, nombres y arrays
Los documentos PDF 2.0 anuncian las especificaciones técnicas ISO de las que dependen (hashes SHA-3 de la ISO/TS 32001, firmas ECC de la ISO/TS 32002, assets glTF de la ISO/TS 32007) mediante el diccionario /Extensions del catálogo, definido en la ISO 32000-2 §7.12. Bajo el prefijo registrado /ISO_, la Tabla 48 permite tanto un único diccionario de extensiones de desarrollador como, novedad de PDF 2.0, un array de ellos, y la Tabla 49 junto con la §7.12.5 convierte /ExtensionLevel en un entero. Un lector que solo maneje una de las dos formas de contenedor pierde todo fichero escrito de la otra manera. HasLoadedISODeveloperExtension y GetLoadedISODeveloperExtensionLevels aceptan ambas y resuelven referencias indirectas por el camino, aunque la §7.12.1 dice que estos diccionarios deben ser objetos directos:
procedure ReportISOExtensions(Pdf: THotPDF);
var
  Levels: THPDFIntegerArray;
  Revision, URL: AnsiString;
  I: Integer;
begin
  Levels := Pdf.GetLoadedISODeveloperExtensionLevels;
  for I := 0 to High(Levels) do
    Writeln('ISO_ extension level ', Levels[I]);

  if Pdf.HasLoadedISODeveloperExtension(32001, Revision, URL) then
    Writeln('ISO/TS 32001 revision ', Revision, ', documented at ', URL);
  // Esperado para un fichero escrito con EnsureISO32001Extensions:
  //   ISO/TS 32001 revision :2022, documentado en https://www.iso.org/standard/45874.html
  if Pdf.HasLoadedISODeveloperExtension(32007) then
    Writeln('glTF 3D assets per ISO/TS 32007');
end;
La primera edición de la ISO/TS 32007:2024 trae un ejemplo en §4.8 que escribe /ExtensionLevel /32007 como nombre; el PDF Errata Issue #835 lo corrigió al entero 32007, pero un productor que copiara el ejemplo original sigue escribiendo el nombre. El lector de HotPDF recurre por eso a parsear un valor de nombre o de cadena, con o sin la barra inicial, cuando la búsqueda del entero vuelve vacía, de modo que HasLoadedISODeveloperExtension(32007) encuentra las dos grafías. La otra errata afecta a /URL: la Tabla 49 de la ISO 32000-2:2020 lista /URL como opcional, y el Issue #732 la promueve a obligatoria. En el lado de escritura HotPDF emite la forma entera y un /URL en cada llamada EnsureISO…Extensions; en el lado de lectura un parámetro de salida URL vacío es lo normal en ficheros escritos según el texto de 2020, así que tómalo como información y jamás como motivo para rechazar la extensión
¿Qué URI WTPDF escribió el productor?
Las declaraciones WTPDF 1.0 e ISO/TS 32005 son PDF Declarations: entradas en una bolsa pdfd:declarations dentro del XMP, bajo el espacio de nombres http://pdfa.org/declarations/ definido por la nota técnica PDF Declarations de la PDF Association. Cada entrada lleva un URI conformsTo y campos opcionales claimBy, claimDate, claimCredentials y claimReport, que GetLoadedPDFDeclarations devuelve como un array de registros THPDFDeclarationEntry; en el lado de escritura, AddPDFDeclaration pone esos mismos cinco campos en el paquete XMP, junto a los espacios de nombres de identificación PDF 2.0, PDF/A-4 y PDF/UA-2. Partir la bolsa en entradas con una búsqueda de texto plano tiene su propia trampa: parte en cada aparición de conformsTo y la etiqueta de cierre </pdfd:conformsTo> de la forma de elemento hijo cuenta como inicio de una entrada nueva, lo que trunca la primera declaración antes de su propio final. El lector de HotPDF salta las etiquetas de cierre y acepta las dos serializaciones
Los URI son la parte más dura. La misma declaración te llega como http:// o como https://, y el WTPDF 1.0 Issue #395 cambió si una / va antes del #, de modo que ficheros escritos antes y después de la errata difieren en ese único carácter; una comparación de cadenas llana los trata como estándares distintos. HasLoadedPDFDeclaration compara URI sin distinguir mayúsculas, pliega https:// sobre http:// y suelta una / justo antes del # en ambos lados, así que la consulta de abajo acierta con la grafía que haya elegido el productor. El fragmento queda intacto: #accessibility1.0 y #accessibility1.0-validated son declaraciones distintas, la segunda afirma que un validador comprobó el fichero, y debes pedir la que le importe a tu flujo de trabajo. GetLoadedWTPDFVersion funde ambas en 'WTPDF 1.0 Accessibility' o 'WTPDF 1.0 Reuse' para el enrutamiento
procedure ReportDeclarations(Pdf: THotPDF);
var
  Decls: THPDFDeclarationEntryArray;
  I: Integer;
begin
  Decls := Pdf.GetLoadedPDFDeclarations;
  for I := 0 to High(Decls) do
    Writeln(Decls[I].ConformsTo, ' claimed by ', Decls[I].ClaimBy,
      ' on ', Decls[I].ClaimDate);

  // Acierta con http o https, con o sin la barra antes de '#'
  if Pdf.HasLoadedPDFDeclaration(
    'https://pdfa.org/declarations/wtpdf#accessibility1.0') then
    Writeln('WTPDF 1.0 Accessibility (unvalidated claim)');

  // Cubre la variante llana y la -validated tanto de Reuse como de Accessibility
  Writeln('WTPDF profile: ', Pdf.GetLoadedWTPDFVersion);
end;
Para un flujo de captura o un enrutador de impresión, el orden de las operaciones importa más que cualquier accesor concreto: prueba IsLoadedPDFR1 sobre el fichero tal como llegó, antes de que un paso de anotaciones o de sellado agregue su actualización, y enruta el PDF/X con GetLoadedPDFXVersion, que cubre por igual el diccionario Info de los trabajos PDF/X-1a y PDF/X-3 y el XMP de los trabajos PDF/X-4, leyendo /GTS_PDFXConformance solo donde haya que distinguir X-1a del X-1. Ambas comprobaciones corren sobre cualquier documento cargado en el HotPDF Delphi PDF component, incluidos los ficheros cifrados abiertos con su contraseña