Un informe etiquetado al que se le recorta la portada puede abrir con el número de páginas correcto y seguir roto en tres sitios: el bookmark «Contents» no hace nada al pulsarlo, el comprobador de accesibilidad reporta un elemento de estructura que no pertenece a ninguna página, y un validador estricto señala una referencia a un objeto libre. El árbol de páginas está bien. La ISO 32000-1 §7.7.3 solo pide que la página salga de /Kids y que /Count baje en uno, y un archivo puede cumplir esa cláusula con medio catálogo apuntando todavía a la página desaparecida
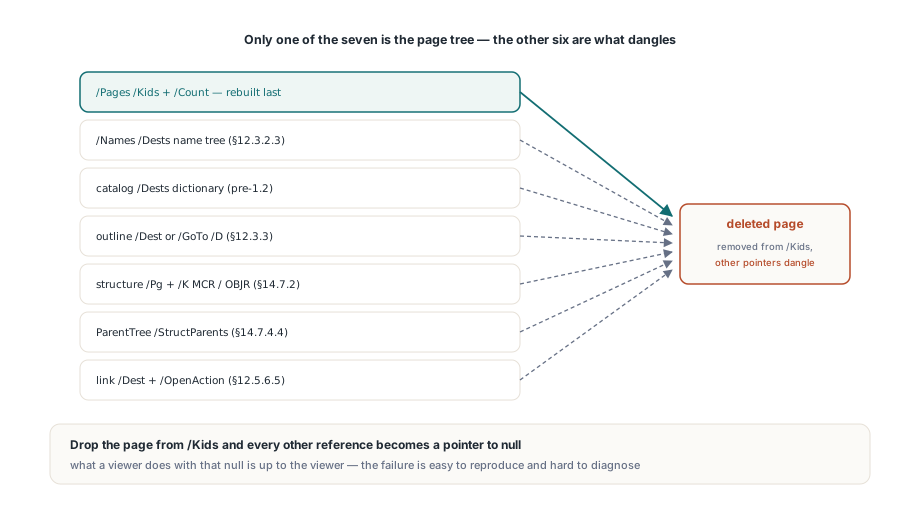
Siete estructuras pueden guardar una referencia a una página
Solo una de ellas es el árbol de páginas. Las demás se reparten entre el catálogo, el outline, la estructura lógica y las anotaciones de otras páginas, y todas resuelven a null en cuanto el objeto página desaparece del archivo. Lo que haga un visor con ese null es cosa suya, así que el mismo archivo recortado puede portarse distinto en dos lectores
- El árbol de nombres bajo
/Names/Dests(§7.7.4, §12.3.2.3) mapea nombres a arrays de destino cuyo primer elemento es la página - El diccionario
/Destsanterior a la 1.2, directamente en el catálogo, guarda arrays del mismo tipo indexados por nombre - Los elementos de outline (§12.3.3) llegan a una página o bien por un
/Destinline o bien por una acción/Acon/S /GoToy un array/D - Los elementos de estructura (§14.7.2) llevan una clave
/Pgque nombra la página en la que vive su contenido marcado, y sus hijos/Kpueden ser referencias a contenido marcado y referencias a objetos (§14.7.4.3) atadas a esa página - El
ParentTree(§14.7.4.4) mapea los números/StructParentsde páginas y anotaciones de vuelta a elementos de estructura, y un elemento puede vivir ahí sin aparecer en absoluto en la cadena/Kdesde la raíz - Las anotaciones de enlace en otras páginas (§12.5.6.5) llevan un
/Desto una acción/GoToque apunta a la página, y el/OpenActiondel catálogo puede hacer lo mismo
Qué hace THotPDF.DeletePage antes de tocar /Kids
THotPDF.DeletePage(PageIndex) sobre un documento cargado barre primero todas esas estructuras y reescribe el árbol de páginas al final. El índice es base cero. Antes de que cambie nada corren dos guardias: un índice fuera de rango lanza Invalid page number, y una petición de eliminar la única página que queda también lanza una excepción, porque un nodo /Pages con cero hijos no describe un documento válido
El orden del barrido es fijo: el árbol /Names /Dests, el diccionario /Dests heredado del catálogo, /OpenAction, el outline, /StructTreeRoot junto con su ParentTree y, por último, los arrays /Annots de cada página que se queda. Solo después se marca el objeto página como borrado, se desenganchan sus anotaciones widget del árbol de campos del AcroForm y se reescriben /Kids, /Count y el /Parent de cada página superviviente. En el lado del formulario, un campo padre que se queda sin hijos cuando su widget se va también se elimina, subiendo hasta /Fields, de modo que un formulario recortado no conserva ninguna entrada de campo sin nada en pantalla detrás
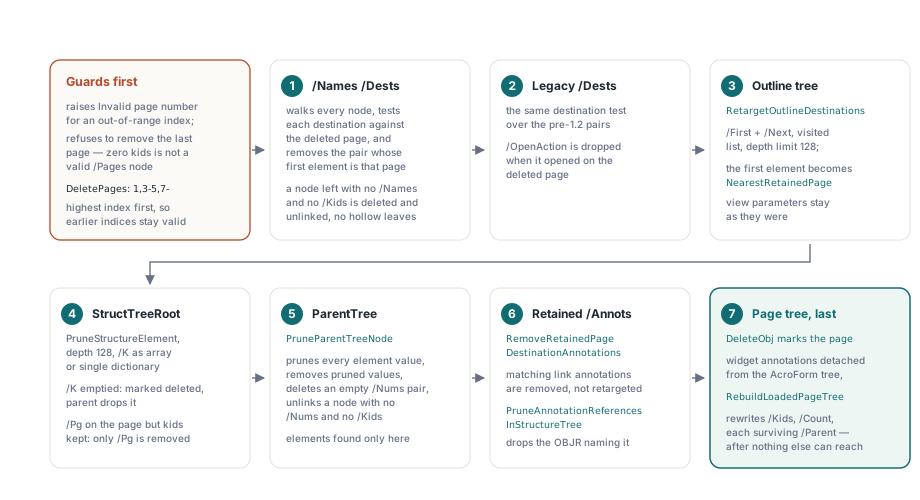
DeletePages acepta una cadena de rangos basada en uno como '1,3-5,7-', la misma notación que usan las demás operaciones de página sobre documentos cargados, y borra desde la página seleccionada más alta hacia abajo. Ir de arriba abajo mantiene válidos los números que escribiste mientras las páginas desaparecen debajo. Un rango que cubre todas las páginas lanza una excepción por la misma razón por la que DeletePage rechaza la última, y la función devuelve cuántas páginas ha eliminado
var
  Pdf: THotPDF;
  Removed: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile devuelve el número de páginas que cargó
    if Pdf.LoadFromFile('tagged-report.pdf') > 0 then
    begin
      // Base cero: la página 0 es la portada
      Pdf.DeletePage(0);
      // Rango basado en uno, numerado contra el documento tal como está ahora
      Removed := Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Los nombres desaparecen, los bookmarks se mueven
Los destinos con nombre que apuntaban a la página borrada se eliminan. Los bookmarks que apuntaban a ella se redirigen. En el árbol /Names /Dests se visita cada nodo y cada destino se comprueba en las dos formas que permite la especificación, el array pelado y el diccionario con clave /D; el par nombre/valor se va cuando el primer elemento del array es la página borrada. Un nodo intermedio que se queda sin /Names ni /Kids se desengancha de su padre, así que el árbol no conserva hojas huecas. El diccionario /Dests heredado del catálogo pasa la misma prueba, clave a clave, y un /OpenAction del catálogo que abriera en la página borrada se descarta, con lo que la vista inicial queda en manos del visor por defecto
Un nodo que pierde entradas también pierde su array /Limits. Las nuevas claves mínima y máxima no se recalculan, y los visores resuelven los nombres sin ellas. Eso sí, la §7.9.6 exige /Limits en los nodos intermedios y en las hojas, así que si algún paso de preflight de tu pipeline exige esa regla a rajatabla, pasa el archivo recortado por él dentro del mismo trabajo
El outline se recorre por /First y /Next con una lista de visitados y un límite de profundidad de 128, de modo que una cadena /Next corrupta que se cicla no pueda colgar la llamada. Para cada array /Dest o array /D de una acción /GoTo que apunte a la página borrada, el primer elemento se reemplaza por la página que le seguía, o por la anterior cuando la borrada era la última. Los parámetros de vista que van detrás de la referencia de página se quedan como estaban, así que un salto /XYZ conserva sus valores left, top y zoom y los aplica a la página nueva
La asimetría es deliberada. Un nombre que no resuelve a nada es legal e inofensivo; un GoTo que nombra un destino inexistente simplemente no hace nada. Un bookmark con destino null es peor: sigue sentado en la barra lateral, parece pulsable y falla. Aterrizar en la página superviviente más cercana es el mejor de dos resultados imperfectos. La redirección cubre solo arrays de destino explícitos. Un elemento de outline cuyo /Dest es una cadena de nombre resuelve a través del árbol de nombres, y cuando el barrido ya eliminó ese nombre el bookmark no lleva a ninguna parte, así que los documentos que abusan de bookmarks con nombre merecen una comprobación tras borrar. La comprobación de abajo lee nombres con ResolveLoadedNamedDestination, que mira solo el array /Names del nodo raíz; da una respuesta con sentido en un árbol de nombres plano, mientras que un árbol partido en /Kids devuelve -1 para todos los nombres. La estructura del propio outline, incluida la poco obvia semántica de /Count, está cubierta en la guía para añadir bookmarks y destinos con nombre en un PDF cargado
// Comprueba el resultado en lugar de darlo por bueno.
// Memo1 es un TMemo de tu propio formulario.
Pdf.DeletePage(0);
// ResolveLoadedNamedDestination lee solo el array /Names de la raíz,
// así que esta comprobación tiene sentido en un árbol de nombres
// plano; en un árbol que usa /Kids devuelve -1 para todos los nombres, borrados o no
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  Memo1.Lines.Add('"cover" is not resolvable from the root /Names array');
// Un bookmark que apuntaba a la portada ahora resuelve a la página
// que le seguía, que tras el borrado es el índice 0 en base cero
Memo1.Lines.Add(Format('Bookmark "Contents" -> page index %d',
  [Pdf.GetLoadedBookmarkPageIndex('Contents')]));
Podar el árbol de estructura y el ParentTree
Los elementos de estructura que existían solo para la página borrada se eliminan, y los elementos que abarcan varias páginas pierden su clave /Pg pero conservan sus hijos. El recorrido empieza en /StructTreeRoot, desciende por /K hasta una profundidad de 128 y acepta tanto la forma de array como la de diccionario único de /K que permite la §14.7.2. Los hijos de cada elemento se podan antes de juzgar al propio elemento. Si la poda dejó su /K vacío, el elemento se elimina y su padre lo suelta. Si su propio /Pg nombra la página borrada pero todavía tiene hijos y un padre /P, solo se va /Pg, porque el /Pg de un elemento es simplemente la página por defecto para los hijos de contenido marcado que no nombran el suyo, y esos hijos bien pueden vivir en otras páginas. Un elemento cuyo /Pg es la página borrada y que no tiene nada debajo se elimina sin más; los diccionarios de referencia a contenido marcado cuyo /Pg nombra la página caen bajo esa última regla
El ParentTree recibe el mismo tratamiento, por una razón que es fácil de pasar por alto: un elemento puede ser alcanzable desde el ParentTree y desde ningún otro sitio. Ese árbol de números mapea enteros /StructParents a un único elemento o a un array de elementos. Cada valor se poda con las reglas de arriba, los valores eliminados caen de sus arrays, un par /Nums cuyo array acaba vacío se borra y un nodo sin /Nums ni /Kids se desengancha. Sáltate esta pasada y los huérfanos seguirán apuntando a una página liberada a través de /Pg. Para quien extrae texto en orden de etiquetas esto es directo: la extracción de texto en orden de estructura recorre exactamente estos árboles, y un elemento con /Pg null es un párrafo que desaparece del orden de lectura
¿Por qué los enlaces de las páginas que sobreviven se eliminan en vez de redirigirse?
Una anotación de enlace en una página retenida cuyo array /Dest o acción /GoTo apunta a la página borrada se elimina de los /Annots de esa página, y su etiqueta se va con ella. El diccionario OBJR cuyo /Obj nombraba la anotación se saca de su elemento de estructura; si ese OBJR era el único hijo del elemento, el elemento también se elimina y el ParentTree se poda de nuevo. Dejar el OBJR atrás rompería la §14.7.4.3, que espera que /Obj referencie un objeto real, y un comprobador de PDF/UA vería un elemento Link cuya referencia a objeto no lleva a ninguna parte
Los bookmarks se mueven; los enlaces no. Una referencia cruzada en el cuerpo del texto que dice «ver página 3» está mal en cuanto la página 3 desaparece, y apuntarla en silencio a la página 4 convierte un enlace roto en uno engañoso. Un bookmark que aterriza en el capítulo siguiente es navegación; un enlace del cuerpo es una afirmación sobre el contenido. Eliminar es el valor por defecto más seguro. Si tu flujo necesita que esos enlaces sobrevivan, reescribe sus destinos antes de llamar a DeletePage, porque después de la llamada ya están fuera de los arrays /Annots
Guardados incrementales y la trampa del hijo directo
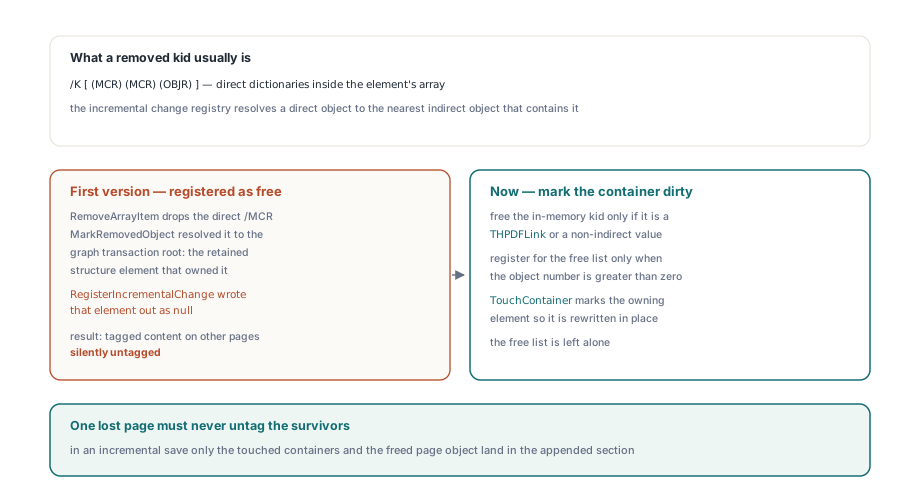
DeletePage se comporta igual entre BeginIncrementalUpdate y SaveIncrementalUpdate. La sección añadida guarda los objetos que el barrido cambió, más entradas libres para los objetos eliminados que tenían número de objeto propio, como la página y las anotaciones de enlace borradas. Todo lo que queda por encima del %%EOF original se conserva byte a byte, como exige la §7.5.6
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
  // Los elementos de estructura que perdieron un hijo /MCR directo
  // se añaden reescritos con un array /K más corto
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
end;
Aquí es donde un podador escrito a mano se equivoca. Las referencias a contenido marcado (/Type /MCR) y las referencias a objetos (/Type /OBJR) suelen ser diccionarios directos sentados dentro del array /K de su elemento padre. Un objeto directo no tiene número de objeto ni entrada en la xref, así que no puede liberarse por su cuenta. El movimiento obvio es «liberar» cada hijo eliminado de todos modos, y cualquier escritor que mapee un objeto directo al objeto indirecto que lo contiene acabará liberando al contenedor, que es el elemento de estructura retenido. Ese elemento sale como null, y el contenido etiquetado de páginas que nunca se tocaron pierde sus etiquetas. HotPDF solo manda un objeto eliminado a la lista de libres cuando tiene número de objeto; para un hijo directo marca el elemento contenedor como cambiado, de modo que el elemento se reescribe con el hijo fuera y la lista de libres queda limpia
La misma cautela decide lo que DeletePage deja tranquilo en un documento cargado. Los content streams, los XObjects y las anotaciones que no son widget de la página borrada se quedan como objetos, porque un archivo cargado puede compartir cualquiera de ellos con una página que permanece y no hay forma barata de demostrar lo contrario en el momento del borrado. Soltar la referencia del árbol de páginas basta para un archivo correcto. Cuántos bytes cuestan todavía esos restos es una medida aparte, y para eso está el análisis de grafo de dependencias y bytes retenidos
¿DeletePage o DeleteLoadedPage?
Usa DeletePage para cualquier borrado de página que pida un usuario. THotPDF.DeleteLoadedPage(PageIndex) es la variante ligera: aplica las mismas dos guardias, desplaza la lista de páginas cargadas, reescribe /Kids y /Count, invalida la caché de páginas renderizadas y lanza OnLoadedDocumentModified. No toca el árbol de nombres, el outline, el árbol de estructura ni las anotaciones de otras páginas, y no marca el objeto página como borrado. ComposeLoadedPagesNUp es el trabajo donde encaja: añade hojas recién compuestas que dibujan las páginas de origen como form XObjects y luego suelta cada original con DeleteLoadedPage(0), porque las hojas referencian el contenido de las páginas y no los objetos página. Para un «quita la página 7 de este contrato» sobre un archivo etiquetado, con bookmarks y con referencias cruzadas, DeletePage es la llamada que deja todas las referencias consistentes, tanto si guardas con SaveLoadedDocument como si añades con SaveIncrementalUpdate
Ambos métodos, el DeletePages por rangos y la ruta de actualización incremental usada arriba forman parte del HotPDF Delphi Component, que edita PDFs cargados desde código Delphi y C++Builder sin ningún runtime de visor en la máquina