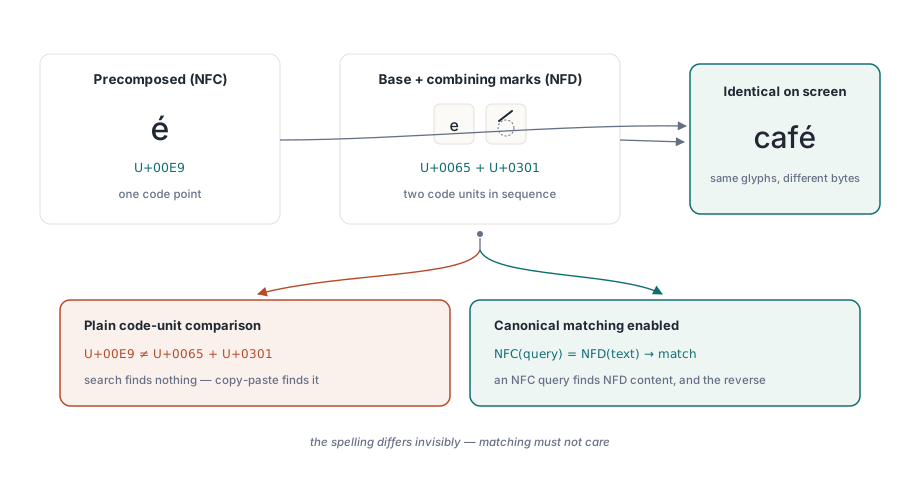
Un usuario teclea Müller en un cuadro de búsqueda, no obtiene nada, copia el mismo nombre del PDF, lo pega de vuelta en el cuadro, y de repente tiene aciertos. Mirad las dos cadenas en el depurador y Length devuelve 6 para la tecleada y 7 para la pegada. La palabra tecleada lleva U+00FC, una ü precompuesta única; el documento guarda una u llana seguida de U+0308 COMBINING DIAERESIS. Ambas se renderizan con los mismos glifos, y una comparación por unidades de código jamás las llamará iguales
¿Por qué cadenas de aspecto idéntico comparan desiguales?
Unicode permite deliberadamente más de una codificación para el mismo carácter abstracto, y llama a las codificaciones canónicamente equivalentes. Unicode Standard Annex #15 define dos formas normales que importan para la búsqueda: NFC, que prefiere puntos de código precompuestos, y NFD, que parte cada carácter precompuesto en una letra base más sus signos combinantes en un orden fijo. Las letras latinas con diacríticos existen en ambas formas. También las sílabas hangul, que pueden aparecer como una sílaba precompuesta o como una racha de dos o tres jamo enlazables
Qué forma acaba en un PDF depende del software que lo produjo, de la plataforma sobre la que corrió y a veces de cómo se construyó el mapa ToUnicode de una fuente. Un documento tecleado en una máquina y editado en otra puede mezclar ambas formas en la misma página. Nada de eso es visible para quien busca. Su teclado y su método de entrada suelen producir NFC, así que cualquier contenido descompuesto en el archivo se vuelve imposible de buscar desde su lado
El arreglo obvio es tirar el problema al mismo cubo que el plegado de mayúsculas: pasar ambos lados a minúsculas, quitar acentos, comparar. Eso falla por una razón estructural. El plegado de mayúsculas y el quitado de acentos son uno a uno a nivel de unidades de código, así que el texto plegado mide exactamente lo mismo que el original y un acierto en la posición 17 de la copia plegada es un acierto en la posición 17 del texto extraído. La normalización cambia longitudes. Una letra precompuesta se convierte en dos o tres unidades de código, una secuencia descompuesta colapsa de vuelta a una, las sílabas hangul se expanden en jamo, y después de esa transformación las posiciones que os devuelven ya no apuntan al texto que extrajisteis
Buscar con soCanonicalEquivalent en PDF Library for Delphi
En PDF Library for Delphi, el miembro soCanonicalEquivalent de TPDFlibSearchOptions hace que SearchText compare descomposiciones canónicas de la consulta y del texto de la página, así que una consulta NFC encuentra contenido NFD y una consulta NFD encuentra contenido NFC. La opción forma parte de un conjunto, lo que significa que se combina con soWholeWord, soCaseSensitive, soWildcards y soDiacriticInsensitive sin ninguna API aparte:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // rellena ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // rango de páginas vacío = todas las páginas

    // Found cuenta todos los aciertos; solo los primeros Length(Hits) se copiaron
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Dos detalles de ese bucle hacen tropezar a la gente. SearchText devuelve el número total de aciertos aunque el buffer sea más pequeño, así que iterar hasta Found - 1 sobre un documento grande se sale por el final de un array de 500 elementos; acotad con Min o cambiad a SearchTextEach, que entrega cada acierto a un callback y no necesita buffer alguno. Y MatchText es el bloque de texto entero que contenía el acierto, con MatchStart como índice de base 1 dentro de él, así que la palabra acertada es el Copy de arriba
Lanzad eso contra un archivo que guarda Bäcker descompuesto y la longitud impresa es 7; contra un archivo NFC es 6. Misma consulta, mismo conjunto de opciones. La rebanada es siempre el texto tal como está en el documento
Dónde aterriza el acierto en el texto original
Esa última propiedad es lo que hace que la búsqueda normalizada sirva para algo más allá de un sí/no. PDF Library for Delphi registra, para cada unidad de código que produce el normalizador, el principio y el fin del rango UTF-16 original del que salió. Una descomposición recursiva hereda el rango de su padre, una composición fusiona los rangos de sus entradas, y cuando se encuentra un acierto la búsqueda escanea el intervalo mapeado buscando el principio más pequeño y el fin más grande
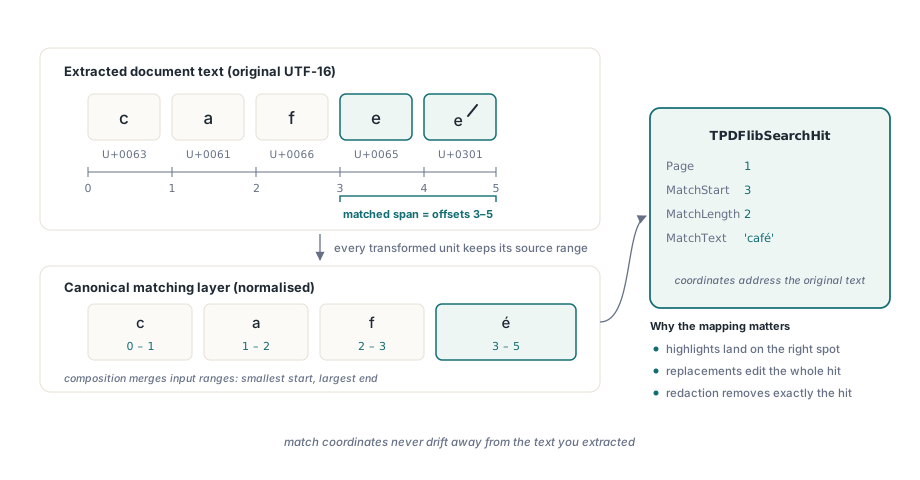
Como resultado, MatchStart, MatchLength, ContextBefore, ContextAfter y ambos puntos de entrada de reemplazo direccionan el texto extraído que el llamador ya tiene. Una búsqueda capaz de decir "hay un acierto en este bloque" pero no exactamente dónde estaría bien para un contador de resultados y mal para todo lo demás: los resaltados se desviarían un carácter o dos por letra acentuada, y un reemplazo reescribiría la tanda de texto equivocada
El normalizador viaja dentro de la biblioteca. Lleva tablas compactas de descomposición canónica, composición y clase combinante canónica de Unicode 15.1, aplica las reglas algorítmicas para el hangul en vez de entradas de tabla, y reordena los signos combinantes de forma estable durante la NFD. No se carga ningún archivo de datos externo y no se hace ninguna llamada de normalización del sistema operativo, así que un servicio de Windows, un demonio de Linux y un build de Free Pascal devuelven aciertos idénticos para el mismo archivo. Lo preferimos así aunque el sistema operativo podría hacer el trabajo en Windows: un índice de búsqueda construido en un servidor y consultado en otro nunca debería discrepar porque las dos máquinas corrieron versiones de Unicode distintas
La opción viene apagada por defecto, y ese defecto es razonable. Construir el texto NFD y su mapa de posiciones cuesta tiempo, y una búsqueda sobre facturas de ASCII puro jamás lo necesita. Cuando soCanonicalEquivalent está fijado, cada bloque de texto guarda dos copias transformadas, una con signos combinantes y otra sin ellos, así que un lote de consultas sobre el mismo bloque lo normaliza una vez. El plegado de mayúsculas llano se queda en la ruta más barata uno a uno
Qué va mal cuando un acierto acaba dentro de un carácter
La equivalencia canónica responde "es este el mismo texto", pero no dice nada sobre dónde se permite parar un acierto. Buscad un café descompuesto por cafe con solo soCanonicalEquivalent y las primeras cuatro unidades de código coinciden; el acento agudo combinante que va detrás queda fuera del acierto. soWholeWord no lo caza, porque sus caracteres de palabra siguen reglas de identificador (letras ASCII, dígitos y guion bajo) y un signo combinante cuenta como frontera. El resaltado cubre cafe, y un reemplazo deja un acento suelto flotando sobre lo que venga después
Lo mismo pasa mucho más allá de los acentos latinos. Un emoji de bandera son dos puntos de código de indicador regional. Un emoji de familia son varias personas unidas por joiners de ancho cero. Una conjunta devanagari es una consonante, una virama y otra consonante, y una vocal vietnamita puede cargar dos signos apilados. Cualquier cosa fuera del plano multilingüe básico es un par suplente en UTF-16, y partir uno por la mitad produce un suplente sin pareja que muchos pipelines de texto sustituyen por U+FFFD
soGraphemeClusters exige que ambos extremos de cada acierto, literal o comodín, caigan sobre fronteras de clústeres de grafos extendidos según los define Unicode Standard Annex #29. La segmentación cubre el emparejamiento CR/LF, los caracteres de control, los tipos de sílaba hangul, Extend y SpacingMark, Prepend, las secuencias emoji ZWJ, los pares de indicadores regionales y los quiebres de conjuntas índicas, y jamás coloca una frontera dentro de un par suplente. Con el flag fijado, cafe ya no coincide en absoluto con un café descompuesto; añadid soDiacriticInsensitive si lo que queréis es precisamente ignorar acentos
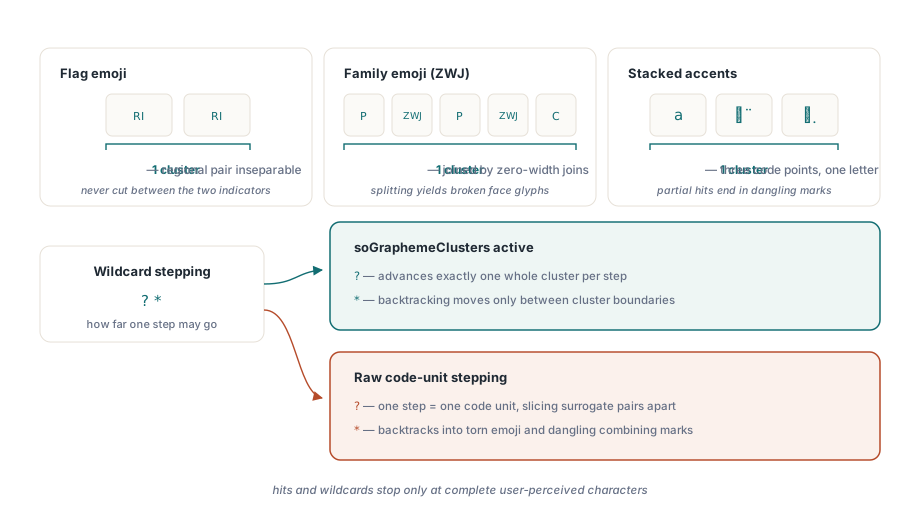
Los comodines son donde el flag cambia los resultados de forma más visible. Bajo soCanonicalEquivalent el texto de la página se compara en NFD, así que côté se convierte en c o U+0302 t e U+0301 sin importar cómo lo guardó el archivo. Sin soGraphemeClusters, el ? de c?té consume exactamente una unidad de código, la o, y luego espera una t y encuentra U+0302. Sin acierto. Con el flag, ? avanza un clúster entero y el backtracking de * también se mueve solo entre fronteras de clúster:
// "?" avanza un carácter percibido por el usuario, así que esto coincide con côté
// tanto si el PDF lo guardó precompuesto como descompuesto
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// El reemplazo usa los mismos rangos seguros por clúster, así que nunca
// parte un emoji ni deja un acento huérfano atrás
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent reescribe el texto dentro del contenido de página y devuelve el número de coincidencias que reemplazó. Cuando devuelve cero, GetLastUnicodeReplacementDiagnostics dice por qué, por ejemplo que un acierto no pudo mapearse de vuelta al contenido que lo dibujó. El otro punto de entrada, SearchAndReplaceText, acepta el mismo conjunto de opciones y dibuja el reemplazo sobre el bloque acertado
Elegir un conjunto de opciones por carga de trabajo
Tres combinaciones cubren la mayoría de las aplicaciones. Para un cuadro de búsqueda de usuario final dentro de un visor de documentos, usad soCanonicalEquivalent más soDiacriticInsensitive: ambas formas de codificación coinciden, y también las escrituras con y sin acento, que es lo que la gente espera tras años de búsqueda web. Para revisión legal o de conformidad, donde un falso positivo le cuesta una tarde a alguien, usad soCanonicalEquivalent con soCaseSensitive y soWholeWord y dejad el plegado de acentos apagado, así la equivalencia se mantiene exacta mientras se ignora cómo le tocó al archivo codificarlo
Para cualquier cosa que cambie el documento, añadid soGraphemeClusters siempre. Es el único sitio donde no lo dejaríamos al gusto. Una búsqueda que devuelve un rango una unidad de código corto solo despista a quien lee los resultados; un reemplazo o una eliminación que usen el mismo rango escriben el error en el archivo, y nadie lo nota hasta que la página se imprime o se extrae de nuevo. La eliminación que tiene que destruir contenido en vez de cubrirlo es tema propio, cubierto en redacción verdadera y eliminación de contenido
Cuando varios términos corren contra el mismo documento, preferid SearchTextBatch. Evalúa cada consulta no vacía mientras los bloques de texto de una página están residentes, así que cada página se extrae una vez y cada bloque se normaliza una vez, y cada consulta lleva su propio conjunto de opciones:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul: NFC o jamo en el archivo
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Los aciertos vuelven ordenados por página, luego por bloque, luego por consulta, y QueryIndex es la posición de base cero en el array que pasasteis. SearchTextBatchEach es la forma de callback para conjuntos de resultados que no podéis dimensionar por adelantado. Cómo se extraen en primer lugar los bloques de texto está descrito en búsqueda de texto y enumeración de elementos de página
Escrituras donde la equivalencia canónica no es opcional
Para el coreano, la equivalencia canónica decide si se encuentra un nombre, porque las sílabas precompuestas y los jamo descompuestos aparecen los dos en documentos reales. El vietnamita apila una marca tonal sobre una vocal que puede llevar ya un breve o un circunflejo, así que su forma de composición depende por completo del productor. Para devanagari, bengalí y las demás escrituras índicas, las reglas de conjunta deciden si la frontera de un acierto aterriza en un sitio que un lector pueda reconocer. El japonés y el chino son comparativamente fáciles por el lado de la búsqueda, aunque el lado del trazado no lo es, como cubre la escritura vertical para japonés y chino
Nuestra recomendación es tajante. Si el corpus contiene cualquier idioma distinto del inglés, activad soCanonicalEquivalent primero y solo apagadlo después de cronometrarlo sobre vuestros propios documentos y encontrar el coste inaceptable. El fallo que evita aterriza exactamente en los nombres que vuestros usuarios más buscan
El mismo motor consciente de Unicode mueve la búsqueda, la extracción, el reemplazo y la redacción desde Delphi, C++Builder y Free Pascal; los conjuntos de opciones, la API por lotes y el resto del toolkit de texto están listados en la página del producto PDF Library for Delphi