El diccionario de un encoder LZW va siempre una entrada por delante del decoder que leerá su salida, así que los dos lados no pueden compartir un único umbral de anchura de código. PDFlibPas da a TPLLZWEncoder y a TPDFLZWDecompressor umbrales separados derivados del mismo flag EarlyChange, y esa ventaja de una entrada es toda la razón de que el flag exista
Casi toda implementación LZW hecha a mano falla en el mismo sitio. Escribes primero el decoder, porque es lo que necesitas para abrir archivos. Funciona. Luego escribes el encoder, espejando la lógica del decoder línea por línea porque LZW es simétrico, ejecutas un test de round-trip y pasa. Publicas. Seis meses después un cliente abre tu salida en un visor que no es el tuyo, y a partir de algún punto del stream es basura. El espejo era el bug: las dos mitades de LZW no son simétricas, y fingir que lo son produce streams que solo tu propio código puede leer
¿Por qué el encoder necesita un umbral distinto del decoder?
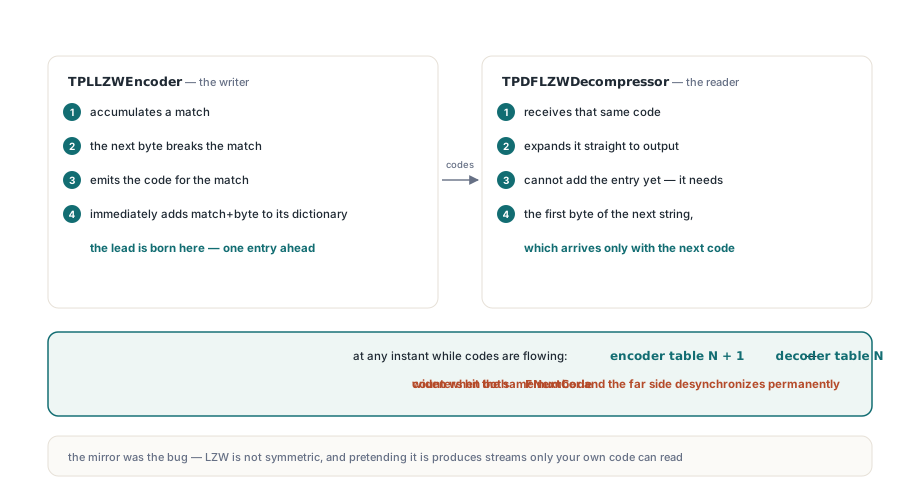
Porque el encoder aprende cada entrada del diccionario un paso antes de lo que puede el decoder. Eso no es una decisión de diseño de PDFlibPas; es inherente a cómo funciona LZW, y toda implementación correcta tiene que compensarlo en algún sitio. Recorre el bucle y verás de dónde viene la ventaja. El encoder acumula una coincidencia, descubre que el siguiente byte la rompe, emite el código de la coincidencia e inmediatamente añade coincidencia-más-byte a su diccionario. El decoder recibe ese mismo código y lo expande, pero todavía no puede añadir la entrada correspondiente, porque la entrada nueva necesita el primer byte de la siguiente cadena, que llega solo con el siguiente código. Así que en cualquier instante mientras fluyen códigos, la tabla del encoder tiene una entrada más que la del decoder. Si ambos lados ensanchan el código de 9 a 10 bits cuando su propio FNextCode alcanza el mismo número, se ensanchan con un código de diferencia y el lector de bits del extremo opuesto se desincroniza para siempre. En TPDFLZWDecompressor.ResetDictionary el umbral del decoder se calcula una vez y se guarda en FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: el lado del decoder del umbral
FCodeSize := FInitialCodeSize;                 // 9 para LZWDecode de PDF
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // ensancha cuando FNextCode llega a 511
else
  FChangeCode := FBitMask + 1;                 // ensancha cuando FNextCode llega a 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
El bucle de decode ensancha justo después de añadir una entrada, comprobando (FNextCode = FChangeCode) and (FCodeSize < 12) y recalculando tanto FBitMask como FChangeCode para la nueva anchura. Nueve bits saltan en 511 o 512, diez bits en 1023 o 1024, once bits en 2047 o 2048, y doce bits es el techo donde el diccionario tiene que vaciarse con un ClearCode en lugar de crecer. El encoder no puede reutilizar ninguno de esos números. Su GrowCodeSize suma uno para compensar la ventaja, así que con EarlyChange activado ensancha en 512 mientras el decoder ensancha en 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 con 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 con 9 bits
  // El decoder añade su última entrada pendiente antes de leer EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;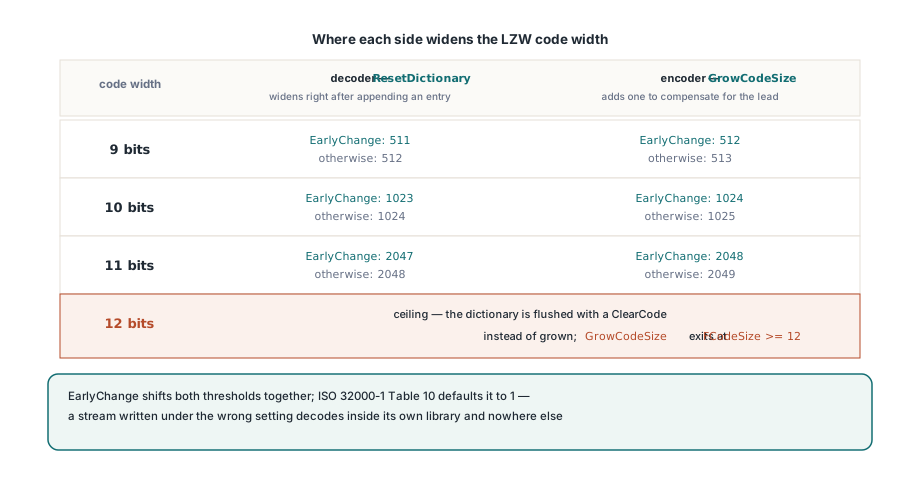
El último código de datos es donde los dos lados por fin se encuentran
El final del stream es el único sitio donde el encoder tiene que dejar de liderar y pensar como el decoder, que es para lo que sirve el parámetro FinalDataCode de GrowCodeSize. Emite el código EOI con la anchura equivocada y todo lo anterior sigue siendo perfectamente válido, así que el defecto se esconde detrás de miles de bytes correctos. La secuencia es esta. El encoder emite su último código de datos y, a diferencia de todas las iteraciones anteriores, después no añade nada a su propio diccionario, porque no queda ningún byte siguiente con el que extender la coincidencia. El decoder hace lo contrario: recibe ese código final, y solo ahora puede completar la entrada que ha estado reteniendo desde el código anterior. En el último paso el decoder se pone al día, la ventaja colapsa a cero, y la anchura que usará para leer EOI la decide una entrada que el encoder nunca creó. Dec(ChangeCode) es el encoder fingiendo, durante exactamente una llamada, que es el decoder:
// TPLLZWEncoder.Compress, la cola del stream
EmitCode(CurCode);      // código de datos final, con la anchura actual
GrowCodeSize(True);     // puede ensanchar usando el umbral decrementado
EmitCode(FEOICode);     // EOI con la anchura que leerá de verdad el decoder
FlushBits;
FlushOutput;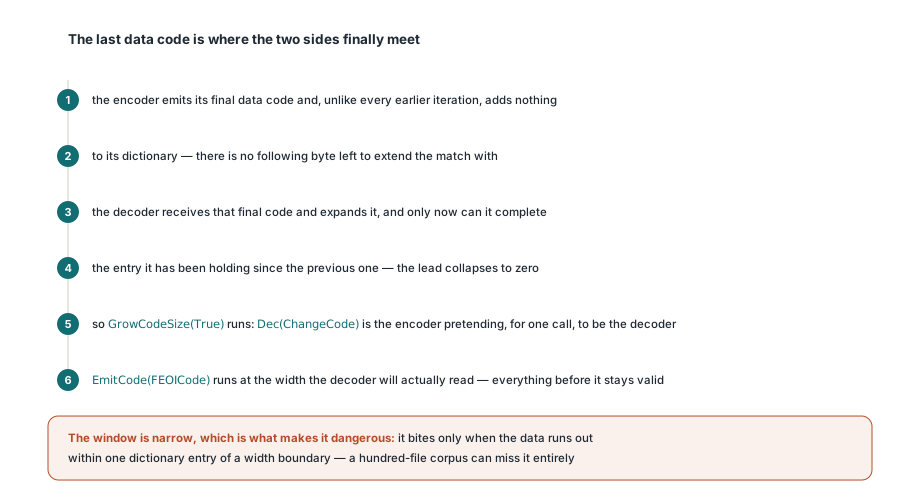
La ventana en la que esto importa es estrecha, que es lo que lo hace peligroso. Solo muerde cuando los datos se agotan justo a una entrada de diccionario de un límite de anchura, así que un corpus de cien archivos de prueba puede no verlo nunca mientras un archivo de un cliente lo pilla siempre. Los casos límite de Compress hay que forzarlos a propósito: prepara entradas cuyo diccionario aterrice en 510, 511 y 512 entradas, y luego lee la anchura de bits del EOI emitido directamente del stream en lugar de inferirla de un decode con éxito
¿Por qué un test de round-trip que pasa puede seguir escondiendo un stream roto?
Porque dos implementaciones que cometen el mismo error se ponen de acuerdo entre ellas. Si tu encoder y tu decoder ensanchan ambos un código demasiado pronto, o ambos demasiado tarde, se mantienen sincronizados, el round trip reproduce la entrada byte a byte y la suite está en verde mientras el stream que produjiste no lo puede leer nadie más. Eso es lo más valioso que se puede sacar de todo el ejercicio: en LZW, la autoconsistencia no vale nada como evidencia. Así que el round-trip propio no puede ser el test principal, y PDFlibPas valida el camino LZW de otras tres maneras. Streams de códigos construidos a mano con el patrón de bits esperado escrito a mano, de modo que la aserción va sobre los bytes y no sobre el resultado de decodificarlos. Interoperabilidad bidireccional contra implementaciones independientes, donde streams producidos por este encoder se decodifican en otro sitio y streams producidos en otro sitio los decodifica TPDFLZWDecompressor. Y decode diferencial, leyendo los mismos bytes dos veces con EarlyChange activado en ambos sentidos, de modo que un stream que decodifica limpiamente bajo la configuración equivocada te dice que los límites de anchura nunca se ejercitaron:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // deliberadamente la regla equivocada para PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A debe coincidir con la fuente; B NO debe coincidir. Si B también coincide,
// la entrada era demasiado corta para cruzar un límite de anchura de código.
Las entradas externas son las que de verdad dan esta cobertura. El material de prueba actual cruza anchos de 9, 10, 11 y 12 bits y fuerza 34 resets de diccionario en un solo stream, que es la única forma realista de probar que el camino ClearCode en el techo de 4095 funciona. Si tus fixtures nunca pasan de unos kilobytes, nada de ese código ha llegado a ejecutarse. Y cuando un fix cambia lo que produce tu encoder, trata la salida antigua como rota en lugar de como una línea base de compatibilidad que valga la pena conservar; un stream que mezcla anchos de código mal no es un formato legado, es un bug que acabó escrito en disco
PDF dice 1, TIFF dice depende
PDFlibPas fija EarlyChange a True por defecto tanto en TPLLZWEncoder como en TPDFLZWDecompressor porque la Tabla 10 de la ISO 32000-1 define EarlyChange como un parámetro de decode de LZWDecode con valor por defecto 1, lo que significa que la longitud de código aumenta un código antes. Eso está especificado en la sección 7.4.4.2 de la ISO 32000-1 junto a los parámetros de predictor, y un PDF que quiera el otro comportamiento tiene que decir /EarlyChange 0 explícitamente en su diccionario /DecodeParms. TIFF es la razón de que el flag sea una propiedad y no una constante: la sección 13 de TIFF 6.0 describe la compresión LZW sin la misma afirmación inequívoca, y los encoders de la vida real se han dividido históricamente sobre esto, que es muy probablemente por qué la spec de PDF sintió la necesidad de nombrar el parámetro. En una pipeline TIFF a PDF, por tanto, la configuración no es algo que puedas hardcodear en ninguno de los dos extremos. Lo que haya resultado necesario en el lado TIFF tiene que trasladarse explícitamente al /DecodeParms del PDF, o conviertes un archivo que se abría bien en uno que no se abre. El mismo cuidado se aplica a FillOrder, donde foTop y foBottom seleccionan por qué extremo del byte rellena el lector de bits, y al predictor 2 de TIFF, el differencing horizontal, que TPDFLZWParms traslada a través de Predictor, Colors, BitsPerComponent y Columns. Nuestras notas sobre endurecer el decoder TIFF integrado para BigTIFF y diseños en tiles cubren el resto de ese camino
Dos trampas menores que merece la pena nombrar
Las dos son fáciles de cablear mal cuando tienes los objetos del encoder y del decoder abiertos lado a lado y asumes que la simetría se mantiene también ahí:
InitialCodeSizeno significa lo mismo en las dos clases.TPLLZWEncoder.InitialCodeSizees la anchura de símbolo raíz, validada de 2 a 8, conInitDictionaryderivandoFClearCodecomo1 shl FInitialCodeSizey fijandoFCodeSizeaFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizees la primera anchura de código, validada de 2 a 9, conResetDictionaryderivandoFClearCodecomo1 shl (FCodeSize - 1). Para datos PDF ordinarios de 8 bits los valores por defecto son 8 y 9 respectivamente y nunca lo notas; fíjalos ambos al mismo número a mano y habrás construido un par desajustado- Decodificar LZW no confiable es un problema de seguridad de memoria antes que de corrección, porque los índices del diccionario salen directamente del archivo.
TPDFLZWDecompressorrechaza cualquier código por encima de 4095 o en o por encima deFNextCode, se niega a añadir entradas más allá de 4095, comprueba la entrada restante en bits antes de cadaGetNextCodey exponeSawExplicitEOIpara que un caller pueda distinguir un stream terminado correctamente de uno que simplemente se quedó sin bytes. Un stream truncado no es un éxito parcial. El estudio más amplio de endurecer un parser de PDF en Pascal contra archivos maliciosos cubre la clase de defecto que cierran estas salvaguardas
Con lo que te quedas
LZW parece simétrico y no lo es. El diccionario del encoder va una entrada por delante durante el cuerpo del stream y la ventaja desaparece en el código final, así que una implementación correcta lleva dos umbrales más un caso especial, y el flag EarlyChange desplaza los dos umbrales a la vez. Que te salga uno solo con un código de error y produces salida que es válida justo hasta que deja de serlo, sin error y sin excepción en ningún sitio, solo un visor en algún lugar renderizando ruido. El límite honesto es que nada de esto es testeable desde dentro: nada en tu propia suite puede distinguir un stream correcto de uno consistentemente erróneo, así que el check de interoperabilidad no es una pasada extra opcional, es la única evidencia real que vas a tener nunca. Ambas clases viajan en la PDF Library for Delphi, que también se encarga del trabajo estructural circundante descrito en nuestras notas sobre object streams y cross-reference streams, para Delphi y C++Builder en las versiones de compilador que soporta la librería