Un importador de anotaciones FDF puede devolver el número de entradas que parseó sin añadir ninguna al documento: cada entrada contada, cada entrada descartada. TPDFlib.ImportAnnotationsFromFDFString de losLab PDF Library lee las claves en cualquier orden, parsea /Rect correctamente y de forma independiente del locale, y devuelve el número de anotaciones realmente añadidas, mientras que el exportador correspondiente escribe el /Rect real de la anotación, así que un export, un import y un segundo export producen FDF idéntico byte a byte. El resto de esta nota explica cómo un offset inicial equivocado produce un fallo silencioso perfecto, qué otras tres trampas se esconden detrás y cómo comprobar una importación por su cuenta en lugar de fiarse del valor de retorno
El escenario es de lo más corriente. Un revisor anota un contrato, los comentarios viajan en un archivo FDF (Acrobat lo llama Export Comments), y su servicio en Delphi los fusiona en una copia limpia con una llamada de importación FDF. La llamada devuelve 7, el log dice «7 comments imported», el trabajo se pone en verde, y el PDF de salida no tiene ni un solo comentario. Nada lanzó una excepción, nada avisó, y el número parecía plausible porque era el conteo real de entradas del archivo. Esa es la peor forma que puede tomar un bug: una función cuya única señal de éxito es un contador que se calcula al margen del trabajo que dice estar reportando
¿Por qué puede una importación FDF reportar éxito sin añadir nada?
Porque un lector de nombres puede arrancar en el sitio equivocado, y un contador puede vivir fuera del código que hace el trabajo. Un buscador de claves que devuelve la posición inmediatamente posterior a /Subtype aterriza en el espacio en blanco antes del valor. Un ReadName que arranca en ese espacio y se detiene en el primer carácter de espacio en blanco se para antes de leer nada, así que cada subtype vuelve vacío. Un helper como AddAnnotationToPage que se niega a construir una anotación sin subtype toma la elección defensiva correcta en aislamiento, pero si es un procedure sin valor de retorno y el Inc(Result) de quien llama vive fuera, los dos guards juntos convierten «no funcionó nada» en «funcionó todo». El lector de nombres correcto se salta el espacio en blanco, exige la / inicial de un name object de PDF y se para en cualquier delimitador, incluidos [, ( y ), de modo que /Subtype/Text y /Subtype /Text devuelven ambos Text; así lee los nombres losLab PDF Library
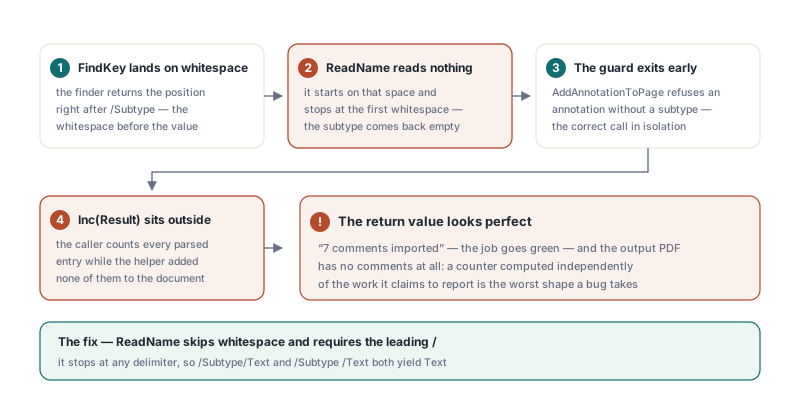
Ese valor de retorno merece cuidados también más allá. Un importador que incrementa por cada diccionario bien formado del array /Annots sigue sobre-reportando cuando una entrada tiene un /Page 0-based fuera de rango o un /Subtype ausente, dos casos que se saltan. En losLab PDF Library, ImportAnnotationsFromFDFString y ImportAnnotationsFromFDF devuelven el número de anotaciones realmente añadidas, como la importación XFDF: el helper FDF AddAnnotationToPage devuelve un Boolean y el contador solo se mueve si hay éxito. Medir el documento sigue siendo la comprobación más fuerte, porque vale sea cual sea el código que produjo el número, así que el sketch de abajo compara AnnotationCount en cada página antes y después de la importación
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // por página seleccionada, widgets incluidos
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // iguales cuando cada entrada aterrizó en una página
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
Tres trampas más detrás de la primera
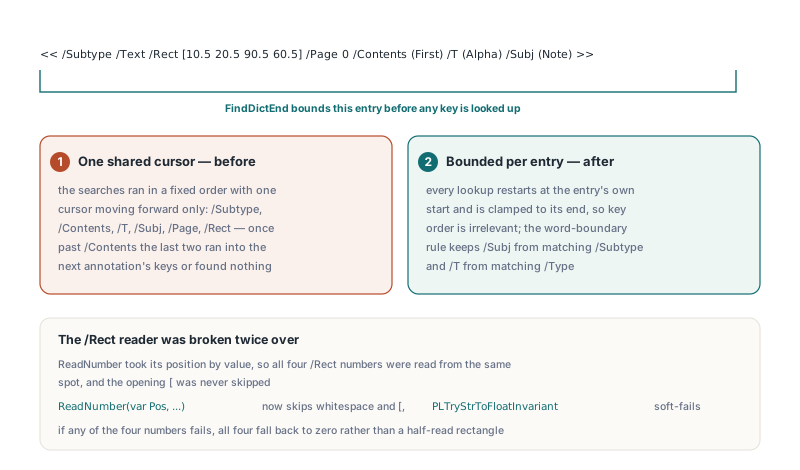
Arreglar el subtype a secas destapa otras tres trampas en el mismo tipo de parser, cada una invisible mientras ninguna anotación llegue jamás a una página. Primero, un ReadNumber que recibe su posición como parámetro por valor lee el mismo punto cuatro veces cuando se le llama por los cuatro números del /Rect en secuencia, y si no se salta el [ de apertura, en la práctica no lee nada. Segundo, un FindKey que comparte un único cursor hacia adelante entre todas las búsquedas depende del orden de las claves. Un exportador puede escribir /Subtype, /Rect, /Page, /Contents, /T, /Subj mientras el importador busca en el orden /Subtype, /Contents, /T, /Subj, /Page, /Rect; en cuanto el cursor pasa /Contents, la búsqueda de /Page y /Rect sigue más allá de la entrada actual y o no encuentra nada o empareja las claves de la anotación siguiente, así que el importador no puede ni leer el output de su propio exportador. Tercero, los números parseados mediante una rutina que sigue el separador decimal del sistema, como PLStrToFloat, se rompen en máquinas con locale de coma. ISO 32000-1 §12.7.7 define FDF como sintaxis de objetos PDF, y las claves de diccionario en PDF no tienen orden (§7.3.7), así que cualquier parser FDF que asuma un orden de claves está mal por construcción, venga el archivo de la herramienta que venga
losLab PDF Library acota primero cada entrada. FindDictEnd camina desde el << de apertura hasta su >> correspondiente, contando los diccionarios anidados y saltándose los cuerpos de literal string con sus escapes de barra invertida, de modo que un >> dentro de un comentario como (see section >> 4) no puede cortar la entrada antes de tiempo. Cada búsqueda de clave arranca entonces en el inicio de la propia entrada y queda limitada a su final, lo que vuelve irrelevante el orden de las claves y evita que una anotación tome prestado el /Page de otra. La comparación de claves acepta además un delimitador justo detrás del nombre, porque /Contents(Hi) es tan válido como /Contents (Hi), mientras que la regla de frontera de palabra impide que /Subj empareje con el comienzo de /Subtype o que /T lo haga con /Type. ReadNumber recibe su posición como parámetro var, se salta el espacio en blanco y el [, y parsea con PLTryStrToFloatInvariant, que falla suavemente ante un token malformado en lugar de lanzar. Si alguno de los cuatro números del rectángulo falla, los cuatro caen a cero en lugar de producir un rectángulo leído a medias
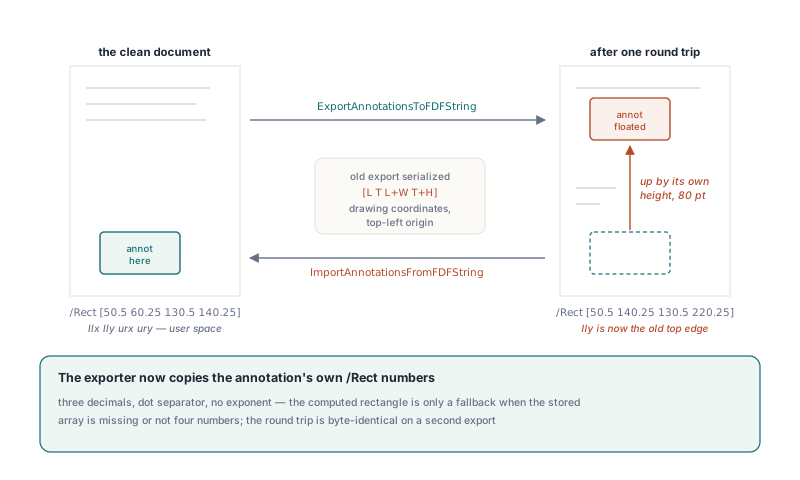
¿Por qué los round-trips FDF pueden desplazar cada anotación su propia altura?
Porque es fácil escribir un rectángulo en el modelo de coordenadas equivocado. El /Rect de una anotación es [llx lly urx ury] en default user space (ISO 32000-1 §12.5.2, con los rectángulos definidos en §7.9.5), y FDF lleva el mismo array. GetAnnotRectEx, sin embargo, reporta Left, Top, Width y Height en las coordenadas de dibujo de la librería, el espacio que controla SetOrigin. Un exportador que serializa esos valores como [L T L+W T+H] le entrega al importador cuatro valores que, escritos de vuelta tal cual como rectángulo PDF, ponen el borde superior donde pertenece la esquina inferior izquierda, así que cada round trip sube la anotación su propia altura. El exportador de losLab PDF Library copia los números del /Rect de la propia anotación, tres decimales, separador punto, sin exponente, y solo recurre al rectángulo calculado cuando el array guardado falta o no tiene cuatro números
Un test de round-trip que merece ser copiado afirma sobre el documento y sobre un segundo export, no sobre el valor de retorno del importador. Fíjese en el conteo esperado de 2: AddNoteAnnotation crea una anotación Text más su Popup, y ambas viajan. El test ejecuta además el export y el import bajo un separador decimal con coma, que es donde vive la otra mitad de esta historia
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // ahora dos páginas
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // simula un escritorio alemán o francés
    try
      FDF := Source.ExportAnnotationsToFDFString;   // sigue escribiendo /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // la nota y su popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
La vía FDF está construida alrededor del diccionario básico de la anotación. El importador reconstruye cada entrada con /Type, /Subtype, /Rect, /Contents, /T y /Subj, y el exportador deja las anotaciones Widget en manos de los métodos de form-data, donde pertenecen los campos de formulario. Antes de fiarse de FDF para color, flags, estilo de borde, enlaces popup o appearance streams, consulte el mapa general de qué datos viajan por qué método en la visión de conjunto del intercambio de datos de formulario FDF, XFDF y XFA, y si necesita inspeccionar qué llegó de verdad, los lectores por índice como GetAnnotType, GetAnnotTitle y GetAnnotContentsEx están cubiertos en introspección de outlines, anotaciones y actions
¿Cómo se leen archivos FDF y XFDF con decimales con coma?
Para FDF la respuesta es inequívoca: una coma no es un delimitador en la sintaxis PDF, así que un token numérico que contiene exactamente una coma y ningún punto solo puede ser un decimal escrito en una máquina con locale de coma. Tales archivos existen, por ejemplo /Rect [10,500 20,250 40,750 60,125] de un exportador que formateó los números con el locale del sistema, y ReadNumber convierte esa única coma en punto antes de parsear. Un token con dos comas, o con una coma y un punto, se rechaza en lugar de adivinar. El lector tampoco consume notación de exponente, lo que casa con ISO 32000-1 §7.3.3: los números PDF nunca la usan
XFDF es más delicado, porque en atributos XML la coma es el separador. El XFDF estándar (ISO 19444-1) escribe rect="50.5,80.25,70.75,100.125" y dashes="4,2", mientras que un escritor dependiente del locale, en un sistema con locale de coma, produce rect="50,500 80,250 70,750 100,125" y opacity="0,600". losLab PDF Library lee y escribe los números XFDF de forma invariante en ambas direcciones, y reconoce la forma legada mediante XFDFNormalizeLegacyDecimals solo cuando el atributo parte por espacios en blanco en exactamente el número de tokens esperado (cuatro para rect, uno para opacity y width) y cada token tiene la forma dígitos-coma-dígitos. Un rect estándar nunca encaja: o es un token con tres comas o son tokens que acaban en coma. dashes se deja deliberadamente tranquilo, porque 4,2 puede ser dos longitudes de guion o un 4.2 legado, y ninguna regla sabe distinguirlos
const
  // Claves fuera del orden del exportador, más decimales con coma de un export con locale de coma
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // un documento nuevo tiene una página
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // Reexportado como XFDF con decimales con punto: rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
¿Qué debe afirmar de verdad un test de importación de anotaciones?
Un test de importación útil afirma sobre el estado del documento destino, nunca solo sobre lo que el importador cuenta de sí mismo; en el fallo de cero silencioso, el valor de retorno es justo el número que queda intacto. Tres afirmaciones cazan cada trampa descrita aquí: el conteo de anotaciones en la página esperada, un campo leído de vuelta con GetAnnotType o GetAnnotContentsEx, y un segundo export comparado byte a byte con el primero. La misma disciplina vale para cualquier API que reescriba la estructura del documento en bloque, incluida la consolidación de campos descrita en la fusión de campos de formulario duplicados: revise el árbol resultante, no un total devuelto. Los métodos de anotaciones FDF y XFDF, con sus variantes de archivo y de cadena, vienen en losLab PDF Library for Delphi y C++Builder