Codifique el OID 2.999.3 como suele hacer una función DER rápida, con los dos primeros arcos empaquetados en un solo byte, y el decodificador le devuelve 1.15.3. Otros dos errores de lectura de CMS se comportan igual: un recuento de certificados que se traga los bytes del vecino y un firmante emparejado con un número de serie leído del campo equivocado. En PDF Library for Delphi (PDFlibPas), el lector de firmas recorre el CMS de /Contents como DER puro, acota cada lectura anidada por su elemento padre, recorta el padding en la longitud que declara el propio CMS y codifica en base-128 el primer arco combinado del OID
Mucho código necesita el lado de lectura de una firma. La long-term validation tiene que extraer el certificado del firmante y sus emisores de una firma existente antes de poder pedir ningún dato de revocación. Un informe de auditoría tiene que decir quién firmó. Y una compilación Lazarus en Linux no tiene funciones de mensajería de Windows a las que agarrarse, porque las llamadas CMS de la plataforma están sustituidas por stubs que fallan fuera de Windows; esa es la razón por la que PDFlibPas hace este recorrido en Pascal puro y no usa CryptoAPI para nada
Leer los certificados del firmante de un PDF firmado
Cinco métodos de TPDFlib cubren todo el lado de lectura, y todos reciben InputFile, Password, FieldName. Cada llamada abre el archivo en solo lectura, responde y lo vuelve a cerrar, así que no hay ningún estado de documento que gestionar. GetSignatureEmbeddedCertificateCount y GetSignatureEmbeddedCertificateDER enumeran el conjunto de certificados del CMS en orden de codificación. GetSignatureSignerCertificateDER devuelve el certificado que produjo un SignerInfo dado. GetSignatureCertificateChainLength y GetSignatureCertificateChainDER caminan desde ese firmante hasta el emisor más lejano que la firma lleve. Todos los índices empiezan en cero
Los resultados llegan como AnsiString, y conviene dejarlos así. Un blob DER pasado por string o por un TStrings atraviesa una conversión de juego de caracteres, y los bytes que salen al otro lado ya no se pueden parsear. Por eso también la biblioteca mantiene las listas de certificados como arrays de AnsiString y devuelve las listas de URLs como texto de una dirección por línea: las direcciones son ASCII plano y sobreviven a la conversión; los bytes de un certificado, no
uses
  SysUtils, Classes, PDFlibrary, PDFlibEnterprise;

procedure SaveDer(const FileName: string; const Der: AnsiString);
var
  Fs: TFileStream;
begin
  Fs := TFileStream.Create(FileName, fmCreate);
  try
    if Der <> '' then
      Fs.WriteBuffer(Der[1], Length(Der));
  finally
    Fs.Free;
  end;
end;

const
  Src = 'contract-signed.pdf';
  Field = 'Signature1';
var
  Pdf: TPDFlibEnterprise;
  Count, ChainLen, I: Integer;
  SignerDer, LastDer: AnsiString;
begin
  Pdf := TPDFlibEnterprise.Create;
  try
    Count := Pdf.GetSignatureEmbeddedCertificateCount(Src, '', Field);
    WriteLn(Field, ': ', Count, ' certificate(s) in the CMS');
    for I := 0 to Count - 1 do
      SaveDer(Format('embedded-%d.cer', [I]),
        Pdf.GetSignatureEmbeddedCertificateDER(Src, '', Field, I));

    SignerDer := Pdf.GetSignatureSignerCertificateDER(Src, '', Field, 0);
    if SignerDer = '' then
      raise Exception.CreateFmt('%s: signer certificate missing or not matched', [Field]);
    SaveDer('signer.cer', SignerDer);

    ChainLen := Pdf.GetSignatureCertificateChainLength(Src, '', Field, 0);
    for I := 0 to ChainLen - 1 do
      SaveDer(Format('chain-%d.cer', [I]),
        Pdf.GetSignatureCertificateChainDER(Src, '', Field, 0, I));
    if ChainLen > 0 then
    begin
      // el último eslabón puede tener aún un emisor que la firma no incrustó
      LastDer := Pdf.GetSignatureCertificateChainDER(Src, '', Field, 0, ChainLen - 1);
      WriteLn('Issuer locations: ', Pdf.GetCertificateIssuerURLs(LastDer));
    end;
  finally
    Pdf.Free;
  end;
end;
Dos resultados de ese programa se malinterpretan con facilidad. Un recuento de 0 no dice casi nada por sí solo: un campo que no existe, una contraseña equivocada, un blob que no es DER y un SignedData que simplemente omite el conjunto opcional de certificados devuelven todos 0 o una cadena vacía. Registre el nombre del campo junto al número, como hace el ejemplo, o acabará depurando el archivo equivocado. El segundo es la longitud de la cadena. El constructor de cadenas usa solo los certificados incrustados en la firma, así que una cadena que se detiene antes de una raíz autofirmada de emisión propia es algo normal. Firma un archivo con nuestro certificado de demostración, emitido por una raíz de prueba, y GetSignatureCertificateChainLength devuelve 1 porque esa raíz no está en el CMS. El siguiente salto viene de las direcciones que reporta GetCertificateIssuerURLs, una llamada que pertenece a la edición Enterprise junto con el resto de la API de long-term validation
El emparejamiento del firmante maneja las dos formas de SignerIdentifier que permite el RFC 5652 §5.3. issuerAndSerialNumber es la que todo el mundo prueba. La forma [0] subjectKeyIdentifier, un OCTET STRING con tag implícito $80, es la rama que los lectores escritos a mano olvidan con más frecuencia, y los firmantes que se identifican por key identifier sí la emiten. Cuando se usa la forma issuer-and-serial, las dos mitades tienen que coincidir: un número de serie solo es único dentro de un emisor, así que emparejar solo por la serie puede aterrizar en un certificado de otra CA
¿Cuánto de /Contents es realmente el CMS?
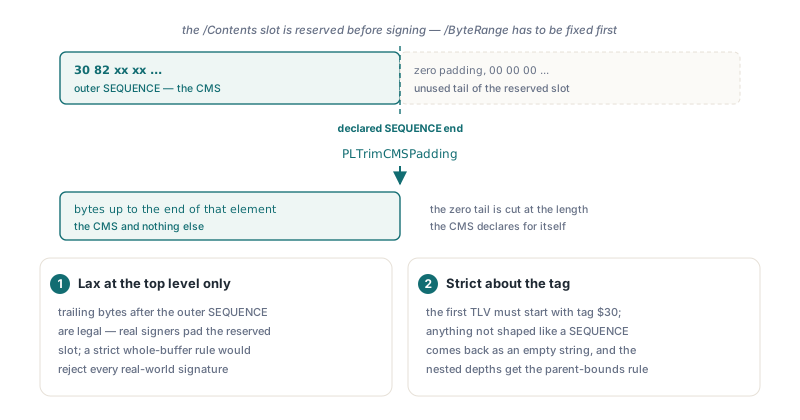
Solo el prefijo cubierto por el SEQUENCE exterior, y PLTrimCMSPadding de la unidad PDFlibCMSRead corta todo lo que venga después. La razón es el orden. ISO 32000-1 §12.8.1 exige que el /ByteRange quede fijo antes de que exista el valor de la firma, de modo que el firmante reserva por adelantado el hex string de /Contents, lo dimensiona con generosidad y rellena la cola sin usar con ceros una vez conocido el CMS. Un archivo firmado típico lleva por tanto una ristra de ceros finales tras el CMS, tan larga como lo que el firmante sobre-reservó
PLTrimCMSPadding lee el primer TLV, exige el tag $30 y devuelve los bytes hasta el final de ese elemento. Aliméntelo con 30 03 02 01 00 00 00 00 y recupera los primeros cinco bytes; dele 'not der' y obtiene una cadena vacía. Este nivel superior es el único sitio donde los bytes finales son legales. Una regla estricta que exigiera que el elemento consuma todo el buffer rechazaría archivos firmados ordinarios, mientras que una regla laxa de «lo que sobre está bien» aplicada a cualquier profundidad es exactamente como los campos anidados acaban leyendo bytes que no les pertenecen
¿Por qué un lector DER necesita el offset final del padre?
Porque un elemento anidado solo es válido si termina dentro de su padre, y comprobarlo contra el final del buffer no demuestra eso. DERReadTLV, en PDFlibASN1, acota cada elemento contra la cadena completa, rechaza las longitudes que se pasarían del final y hace la aritmética como una resta, de modo que una longitud de cuatro bytes manipulada como $7FFFFFFF no puede volver negativa la comprobación. Eso es memory safety. No dice nada sobre si el elemento pertenece al sitio donde se encontró
Imagine un SignerInfo cuyo issuerAndSerialNumber declara 40 bytes mientras el issuer Name de dentro reclama 60. Todos los bytes siguen en el buffer, así que un lector acotado al buffer acepta el Name, luego lee el «número de serie» del digest algorithm que viene detrás, y después compara ese par contra los certificados incrustados. Nada falla. A veces la comparación hasta tiene éxito con el certificado equivocado
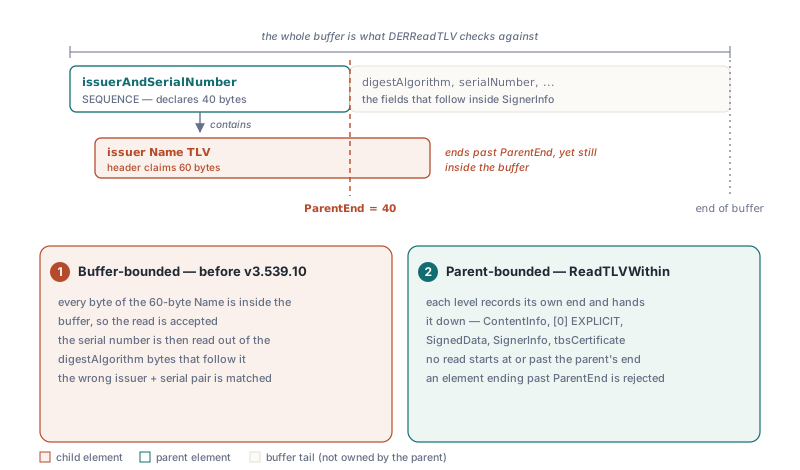
El walker CMS de PDFlibPas hace pasar la posición final del padre a cada lectura, desde ContentInfo (RFC 5652 §3) pasando por el envoltorio [0] EXPLICIT, los campos de SignedData (§5.1), cada SignerInfo y su identificador, hasta los campos de tbsCertificate que lee al emparejar un firmante. Si escribe su propio walker encima del DERReadTLV público, para un timestamp token o una respuesta OCSP, el mismo patrón son una docena de líneas:
uses
  PDFlibASN1;

// Una lectura hija, rechazada si el hijo terminaría más allá de su padre.
function ReadChild(const Data: AnsiString; ParentEnd: Integer;
  var Offset: Integer; out Tag: Byte; out Start, Len: Integer): Boolean;
begin
  Result := False;
  if (Offset < 1) or (Offset >= ParentEnd) then
    Exit;                          // nada queda dentro del padre
  if not DERReadTLV(Data, Offset, Tag, Start, Len) then
    Exit;
  Result := Offset <= ParentEnd;  // Offset queda una posición después del hijo
end;

// Cuenta los miembros SEQUENCE de un SET OF cuyo contenido va de
// Data[SetStart .. SetEnd - 1]. Se detiene en el primer miembro que se desborda.
function CountSequences(const Data: AnsiString; SetStart, SetEnd: Integer): Integer;
var
  Offset, Start, Len: Integer;
  Tag: Byte;
begin
  Result := 0;
  Offset := SetStart;
  while Offset < SetEnd do
  begin
    if not ReadChild(Data, SetEnd, Offset, Tag, Start, Len) then
      Break;                       // sin resincronización: la alineación se perdió
    if Tag = $30 then
      Inc(Result);
  end;
end;
Fíjese en el Break. Dentro del conjunto de certificados y del conjunto de signerInfos, PLExtractCMSCertificates hace lo mismo: un elemento que se pasa del final del conjunto detiene el bucle, y la función devuelve los certificados que ya había aceptado. Nunca pega los bytes siguientes de crls o signerInfos al último certificado. Saltarse el elemento defectuoso y continuar es tentador, y es la decisión equivocada. En cuanto una longitud declarada está mal, el lector ya no sabe dónde empieza el siguiente elemento, y cualquier «recuperación» es una apuesta sobre qué byte parece un tag. Con el bucle detenido, un conjunto cuyo segundo certificado se desborda por un solo byte arroja un recuento de 1 y los bytes del primer certificado exactamente tal y como están codificados
¿Por qué 2.999.3 salía como 1.15.3?
Los dos primeros arcos de un OID se combinan en un solo subidentificador, y ese subidentificador se codifica en base-128 como cualquier otro arco: no es un solo byte. X.690 §8.19.4 define el valor como 40 * arc1 + arc2. Un codificador que lo escribe con Byte(...) es correcto hasta 127, que es 2.47. Para 2.999 la suma es 1079, un cast a byte se queda con 55, y 55 se decodifica como 1.15. El identificador pasa a nombrar otra rama del árbol y nadie se queja. Los valores de 128 a 255 fallan de otra manera: el cast emite un byte con el bit de continuación activo, y el decodificador se traga el siguiente arco dentro de él
El atajo sobrevive tanto tiempo en código real porque la mayoría de los identificadores PKI nunca llegan al límite. Todo lo que cuelga de 1.2.840, 2.5.29 y 0.4.0 tiene un primer valor combinado muy por debajo de 128, así que una suite de pruebas construida solo con OIDs de firma comunes nunca ejercita el segundo byte. Solo los arcos joint-iso-itu-t desde 2.48 hacia arriba cruzan la línea. En PDFlibPas una única función, DER_OID, sirve al codificador para signed attributes, a la búsqueda dentro de DERFindExtensionByOID y a la comprobación del content-type de SignedData, así que escribir y emparejar no pueden divergir. Los vectores de prueba pertenecen a ambos lados del límite:
uses
  SysUtils, PDFlibASN1;

function Hex(const S: AnsiString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + IntToHex(Byte(S[I]), 2) + ' ';
  Result := Trim(Result);
end;

procedure Check(const Oid, Expected: AnsiString);
begin
  if Hex(DER_OID(Oid)) <> Expected then
    WriteLn('MISMATCH ', Oid, ': ', Hex(DER_OID(Oid)), ' expected ', Expected)
  else
    WriteLn('ok       ', Oid);
end;

begin
  Check('2.47.1',               '06 02 7F 01');     // último valor de un byte
  Check('2.48.1',               '06 03 81 00 01');  // primer valor de dos bytes
  Check('2.999.3',              '06 03 88 37 03');  // un cast a Byte da 1.15.3
  Check('2.5.29.14',            '06 03 55 1D 0E');
  Check('1.2.840.113549.1.7.2', '06 09 2A 86 48 86 F7 0D 01 07 02');
end.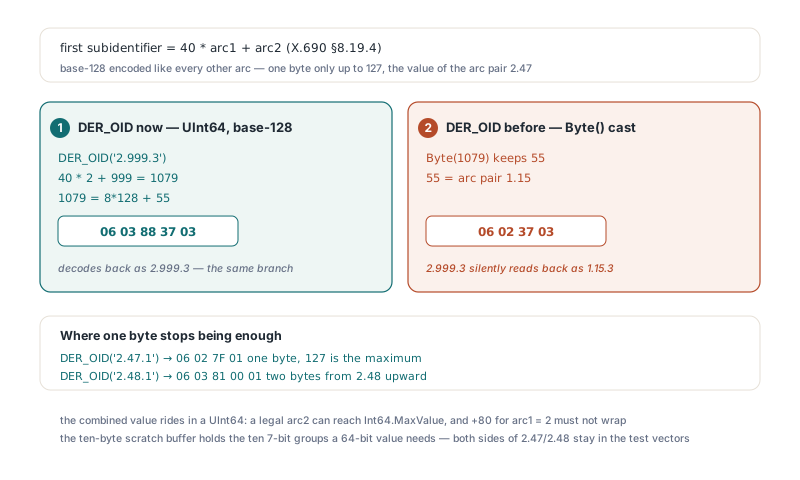
Queda un desbordamiento más escondido en la misma línea de aritmética. DER_OID parsea los arcos en Int64, así que un segundo arco legal puede ser tan grande como Int64.MaxValue, y sumar 80 para arc1 = 2 desborda un entero de 64 bits con signo. Por eso el valor combinado se guarda en un UInt64, que acarrea Int64.MaxValue + 80 sin envolverse. Nadie emite OIDs tan grandes, pero una cadena manipulada puede seguir pidiendo uno. El buffer temporal de diez bytes de DER_OID guarda los diez grupos de 7 bits que un valor de 64 bits puede necesitar, así que incluso 2.9223372036854775807 se codifica como un subidentificador de diez bytes en lugar de envolverse
Qué acepta el walker CMS y dónde vive la verificación
PDFlibCMSRead devuelve bytes que están donde RFC 5652 dice que deben estar, y ese es todo su trabajo. No comprueba ningún valor de firma, ningún digest ni ningún periodo de validez. El walker acepta solo DER: DERReadTLV rechaza las longitudes indefinidas y los números de tag de varios bytes, así que un CMS codificado en BER de un firmante no conforme reporta cero certificados. Preferimos eso a un parseo parcial de BER. En la práctica, la pista es un byte de longitud $80 justo después del tag exterior $30, que es con lo que arranca un SEQUENCE de longitud indefinida
Los certificados de atributo y las demás alternativas de CertificateChoices se saltan mientras se recorre el conjunto de certificados, ya que solo la alternativa Certificate plana es un certificado X.509 que la construcción de cadenas y las búsquedas de revocación pueden usar. Todo lo criptográfico se queda con el código que lo posee, que empieza con las comprobaciones de cobertura de bytes en firma PAdES y validación de ByteRange en Delphi y continúa con clasificar qué cambió después de que se firmara un PDF. El mismo hábito de desconfiar de las longitudes declaradas atraviesa endurecer un parser PDF en Pascal frente a archivos maliciosos
La extracción de certificados, la construcción de cadenas y las llamadas de long-term validation mostradas arriba son parte de losLab PDF Library for Delphi, que funciona en Delphi, C++Builder y Lazarus, de modo que el mismo código de lectura de firmas sirve en un servicio de Windows y en una compilación Linux