Un lote de escaneos puede ser nada más que un JPEG por página, sin fuentes, sin anotaciones y sin marcadores, y aun así fallar como PDF/raster. ISO 23504-1 le pide más al archivo que páginas de solo raster: tiene que identificarse con un comentario %PDF-raster-1.0 en el área del trailer, llevar metadatos XMP y un /ID de trailer, y mantener su catálogo y diccionario Info en listas cortas permitidas. Verificar un lote de captura toma entonces dos lecturas distintas, una sobre los bytes crudos y otra sobre lo que cada página realmente dibuja
Dos lecturas del mismo archivo
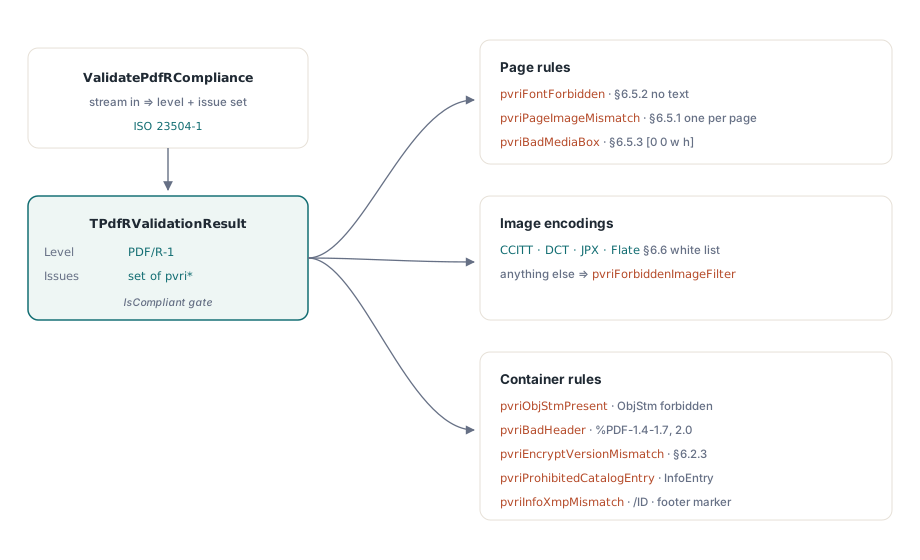
La validación PDF/R y SaveAsPdfR vienen con las ediciones Small Business y Enterprise de PDFium Component, que divide la validación siguiendo esa línea. ValidatePdfRCompliance en la unidad FPdfPdfr lee un stream y revisa las reglas a nivel de bytes: versión del encabezado, el marcador raster, object streams, entradas de catálogo e Info, XMP, /ID del trailer, orígenes de MediaBox, recursos de fuente, nombres de filtros prohibidos y si el número de objetos de imagen coincide con el número de páginas. ValidatePdfRPageFacts revisa una página a la vez desde un record TPdfRPageFacts: cuántos objetos de texto, trazados, formularios y sombreados dibuja la página, dónde está la única imagen de tira, su tamaño en píxeles, profundidad de bits, espacio de color y cadena de filtros
Ambas lecturas reportan mediante una sola enumeración, TPdfRValidationIssue, y los puntos de entrada combinados las funden en un único TPdfRValidationResult. Su campo Conformance se vuelve prc1 solo cuando el marcador raster aparece, y IsCompliant devuelve True solo cuando el nivel es prc1 y el conjunto de hallazgos está vacío. Un archivo perfecto en todo lo demás pero sin el marcador reporta prcNone, algo que sorprende la primera vez que se pasa un escaneo limpio por ahí
La pregunta es de dónde salen los datos de página. TPdf.ValidatePdfR los recolecta del documento cargado, pero primero serializa ese documento a un almacén temporal y corre las comprobaciones de bytes sobre la copia re-guardada, así que los veredictos de marcador y catálogo describen un guardado fresco, que puede diferir del archivo en disco. ValidatePdfRasterSource en FPdfBusinessWorkflows toma una sola instantánea del stream de entrada y corre ambas lecturas sobre ella. Para un archivo que está por entrar a un archivo de archivo, esa es la llamada que corresponde: el veredicto entonces se refiere a los bytes que se van a archivar
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // el presupuesto por defecto es 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // nuestro contrato de captura
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues guarda los hallazgos de bytes más cada hallazgo de página
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues dice qué páginas volver a escanear
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Guarde el veredicto legible por máquina junto al archivo archivado
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Dos valores por defecto de TPdfRasterSourceValidationOptions importan para lotes de escaneo. MaxInputBytes es 64 MiB y MaxPages es 1000; un lote largo de escaneos a color puede pasarse del presupuesto de bytes, y la comprobación termina entonces con estado prssBudgetExceeded y Complete en False. MemoryLimitBytes es 8 MiB, más allá de lo cual la instantánea se derrama a TemporaryDirectory y el reporte pone SnapshotSpilled. Report.IsCompliant también exige Complete, así que una comprobación que se detuvo a medias nunca se lee como un pase
¿Por qué una capa de texto OCR hace fallar PDF/R?
Porque una página raster dibuja la imagen escaneada y nada más. Una capa OCR invisible es una adición normal en un flujo PDF/A, y pone en el archivo dos cosas que PDF/R excluye: un recurso de fuente, reportado por la lectura de bytes como pvriFontForbidden, y objetos de texto en la página, reportados por la lectura de página como pvriNonRasterPageContent. El mismo hallazgo de página se dispara con trazados vectoriales, sombreados y form XObjects, así que un número de página estampado o un borde dibujado falla igual que el texto oculto
La relación página-imagen también es estricta. Cada página tiene que llevar exactamente una imagen de tira; pvriPageImageMismatch se dispara en una página sin imagen y en una página cuyo escaneo se escribió como dos imágenes lado a lado. Del lado de los bytes el conteo se toma sobre todo objeto cuyo /Subtype sea /Image, así que cualquier objeto de imagen extra, una máscara suave adjunta a la tira por ejemplo, empuja el total más allá del conteo de páginas
La geometría recibe dos comprobaciones. pvriBadMediaBox reporta un MediaBox que no empieza en [0 0 ...]; la lectura de bytes inspecciona arreglos numéricos en línea. La lectura de página luego compara los límites dibujados de la tira con el MediaBox y reporta pvriStripGeometryInvalid cuando cualquier borde se desvía más de GeometryTolerancePoints, 0.5 puntos por defecto. Un driver de escáner que deja un margen blanco escalando la imagen al 98% de la página falla aquí, aunque la página se vea bien en pantalla. Poner RequireFullPageStrip en False apaga la prueba de cobertura para archivos internos donde un margen es aceptable
Qué codificaciones de imagen pasan
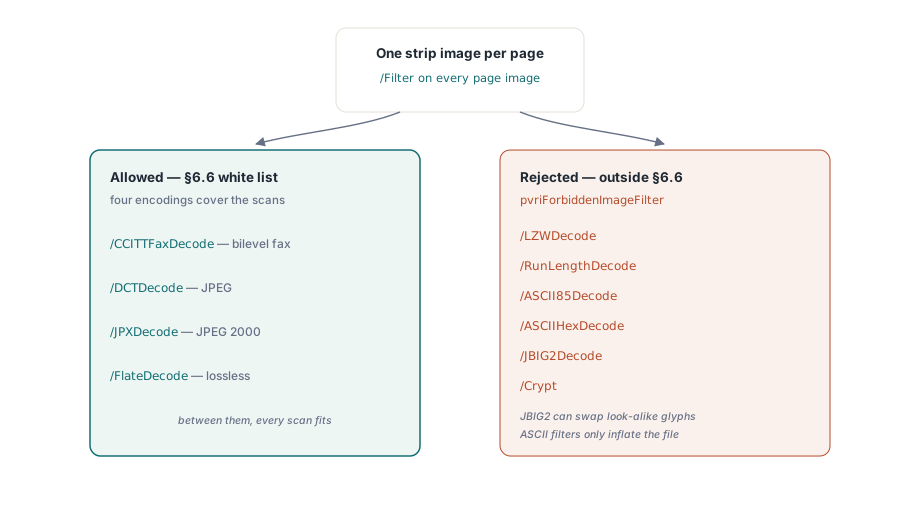
El validador acepta cuatro filtros de tira: /CCITTFaxDecode, /DCTDecode, /JPXDecode y /FlateDecode. La lectura de bytes marca por nombre los demás filtros estándar como pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode y /Crypt
JBIG2 es el rechazo que los equipos de captura golpean primero. Está permitido en PDF/A y comprime páginas bilevel muy bien, así que un perfil de captura construido para PDF/A puede ya estar emitiéndolo. Su modo de emparejamiento de patrones con pérdida además es conocido por reemplazar un glifo escaneado por otro de aspecto similar, un problema documentado con dígitos en formas escaneadas, y un archivo raster existe precisamente para que lo que estaba en papel sea lo que está en el archivo. Re-codificar esas páginas como CCITT Group 4 las mantiene bilevel y sin pérdida
La lectura de página va un paso más allá y mira la cadena de filtros junto con la profundidad de bits y el espacio de color de la imagen, reportando los desajustes como pvriImageCompressionParametersInvalid:
- Una cadena de más de un filtro se rechaza, así que una imagen Flate envuelta en ASCII85 falla dos veces, una del lado de los bytes y otra aquí
/CCITTFaxDecodedebe ir sobre una tira DeviceGray de 1 bit/DCTDecodedebe ir sobre una tira de 8 o 24 bits en DeviceGray o DeviceRGB/FlateDecodese acepta en tiras de 1 bit; una página Flate de 24 bits falla esta comprobación/JPXDecodese acepta a 1, 8 o 24 bits por píxel
Con independencia del filtro, una tira cuyo espacio de color no es ni DeviceGray ni DeviceRGB recibe pvriImageColorInvalid. Un escaneo basado en ICC o CMYK tiene que convertirse antes de envolverse, y el lugar más barato para hacerlo es el perfil del escáner, antes de escribir cualquier PDF
Cómo se calcula la resolución de la tira
Cuando la imagen trae su propia resolución, la lectura de página la usa. Cuando no, la resolución efectiva se deriva de los píxeles y el tamaño de página: ancho en píxeles por 72 dividido entre el ancho del MediaBox en puntos, y lo mismo para el alto. Suponga que un escáner escribe una tira de 2550 por 3300 píxeles sobre una página US Letter de 612 por 792 puntos. Eso da exactamente 300 dpi en ambas direcciones. La misma página a 600 por 776 píxeles da alrededor de 70.6 dpi en horizontal, por debajo del mínimo por defecto de 72, así que la página recibe pvriImageResolutionInvalid
El rango por defecto en TPdfRValidationOptions es de 72 a 2400 dpi. Esos límites solo atrapan páginas evidentemente rotas. Un contrato de captura por lo general promete un mínimo específico, a menudo 200 o 300 dpi, y ese valor pertenece a MinimumResolutionDpi: una página de 150 dpi pasa el rango por defecto, y es exactamente la página que ese contrato fue escrito para excluir. Poner cualquiera de los dos límites en 0 apaga ese lado de la comprobación
ValidatePdfRPageFacts es público, así que las mismas reglas pueden correr antes de que exista cualquier PDF, directo de lo que el escáner reporta sobre cada imagen:
uses
  FPdfPdfr;

//// Construye los datos de página desde la salida del escáner; este helper es suyo, no forma parte de la biblioteca
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // la tira cubre la página completa
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi se deja en 0: se deriva
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // JPEG a color de 300 dpi sobre Letter: conjunto vacío
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // La misma página comprimida con Flate a 24 bits:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Catálogo, diccionario Info y XMP
Además de los /Type y /Pages requeridos, ISO 23504-1 solo permite Version, ViewerPreferences, PageLayout, PageMode, AcroForm y Metadata en el catálogo. El validador revisa el catálogo contra las 21 claves estándar fuera de ese conjunto y lanza pvriProhibitedCatalogEntry cuando cualquiera de ellas aparece, entre ellas Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties y OutputIntents. La última importa en la práctica: un archivo PDF/A siempre lleva un output intent, así que un solo archivo no puede satisfacer ambos perfiles
El diccionario Info puede llevar Creator, Producer, CreationDate y ModDate; Title, Author, Subject, Keywords y Trapped lanzan pvriProhibitedInfoEntry. Un catálogo sin stream /Metadata recibe pvriMissingXmpMetadata. Cuando el stream está pero su XMP carece de cualquiera de xmp:CreateDate, xmp:ModifyDate y xmp:MetadataDate, el hallazgo es pvriMetadataInvalid en su lugar. pvriInfoXmpMismatch compara Producer con pdf:Producer y Creator con xmp:CreatorTool. Las fechas quedan fuera de esa comparación porque las dos codificaciones legítimamente difieren, y los valores de Info guardados como cadenas hex se saltan. Un detonante típico es una herramienta posterior que reescribe el Producer del Info sin tocar el XMP
Las reglas de contenedor restantes son cortas. El encabezado tiene que ser %PDF-1.4 a %PDF-1.7 o %PDF-2.0 (pvriBadHeader), cualquier stream /Type /ObjStm lanza pvriObjStmPresent, y un archivo cifrado debe usar un encabezado %PDF-2.0 (pvriEncryptVersionMismatch). Con RequireEncryptedPdf20Profile activo, el diccionario de cifrado también debe declarar /V 5 o 6 con /R 5 o posterior, o el archivo recibe pvriEncryptedPdf20ProfileInvalid
Escribir los marcadores
TPdfRSaveOptions lleva Creator, Producer, CreationDate, ModDate, DocumentId e InstanceId, y no tiene campo para Title, Author, Subject o Keywords porque el perfil los prohíbe. StripInfoOptionalEntries y StripCatalogOptionalEntries están en True por defecto y quitan las entradas excluidas del origen; ponga cualquiera en False y las entradas se quedan, al costo de la conformancia. TPdf.SaveAsPdfR llena los campos de opciones vacíos con los metadatos y los identificadores de archivo del propio documento cargado, elimina la seguridad, y luego escribe el marcador, los diccionarios recortados, el paquete XMP y el /ID del trailer
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, fechas e IDs vienen del origen
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Revise los bytes que se escribieron, no el documento en memoria
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
El envuelto cambia solo metadatos e identificación. Una página de origen que dibuja texto vectorial, o que no lleva imagen de tira, sale de SaveAsPdfR con el mismo contenido de página y falla las mismas comprobaciones de página. El contenido de la página se deja tranquilo a propósito, porque re-renderizar en silencio un escaneo cambiaría justamente los píxeles que el archivo quiere preservar. Correr CheckDeliveredScan del primer listado sobre OutFile da el veredicto completo, lecturas de página incluidas
Dónde encaja PDF/R en un flujo de captura
PDF/R sirve para los entregables donde el escaneo mismo es el registro y la fidelidad es el contrato completo: imágenes con valor probatorio, captura de cheques y remesas, archivos de planos desde un escáner de gran formato. En cuanto un documento necesita texto buscable, etiquetado, adjuntos o marcadores, pertenece a PDF/A, porque cada una de esas funciones cae en las listas de excluidos de arriba
Muchos equipos conservan ambos. Un original PDF/R se escribe una vez y nunca cambia, y un derivado PDF/A con una capa OCR sirve para la recuperación. Los validadores son independientes, así que un mismo trabajo por lotes puede verificar cada archivo contra el perfil que afirma. El lado de archivo está cubierto en el cumplimiento de archivo PDF/A y la validación preflight de PDF/A, y la salida de impresión en la validación de documentos PDF/X listos para impresión
Las comprobaciones PDF/R mostradas aquí son parte de las ediciones Small Business y Enterprise de PDFium Component para Delphi, C++Builder y Lazarus, junto a validadores para PDF/A, PDF/X, PDF/E y PDF/UA; las ediciones y las versiones de IDE soportadas están en la página de producto de PDFium Component