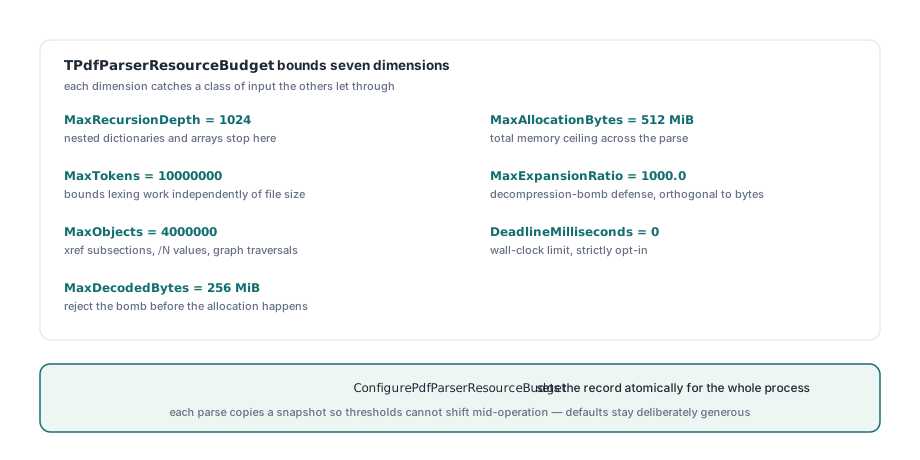
PDFium Component expone TPdfParserResourceBudget, un solo record que acota la profundidad de recursión, el conteo de tokens, el conteo de objetos, los bytes decodificados, el ratio de expansión, la asignación y un deadline de reloj de pared para todos los parsers PDF de la librería. ConfigurePdfParserResourceBudget lo establece atómicamente para el proceso, y cada parse copia una instantánea para que sus umbrales no puedan desplazarse a mitad de operación
Seis parsers, seis techos privados
La situación que forzó esto era mundana y probablemente familiar. El recorrido sparse de xref tenía su propio techo de objetos. El inspector de streams tenía su propio tope de bytes decodificados. XMP tenía uno, XFDF y FDF tenían otro, la normalización de contenido un tercero, y los defaults de preflight un cuarto. Cada uno de esos números era defendible por sí solo y ninguno era alcanzable desde afuera, así que un llamador que quisiera decir "este camino de ingreso maneja subidas anónimas, nada aquí puede asignar más de 64 MiB ni correr más de cuatro segundos" no tenía dónde decirlo. El segundo problema era peor porque era silencioso: donde un límite vivía en un global mutable, un parse que empezaba bajo una política podía terminar bajo otra. Un thread llama a un setter mientras otro va a mitad de un object stream, y la primera mitad de ese recorrido queda acotada por el techo viejo mientras la segunda mitad queda acotada por el nuevo. Nada crashea, nada se loguea, y después no puedes decir bajo qué límites corrió realmente la operación, que es exactamente la propiedad para la que necesitabas los límites
¿Qué acota realmente TPdfParserResourceBudget?
Siete dimensiones, elegidas porque cada una atrapa una clase de entrada que las demás dejan pasar. MaxRecursionDepth tiene un default de 1024 y evita que los diccionarios y arreglos anidados conviertan la sintaxis de objetos de ISO 32000-1 §7.3 en un stack overflow. MaxTokens tiene un default de 10,000,000 y acota el trabajo de lexing con independencia del tamaño del archivo. MaxObjects tiene un default de 4,000,000 y cubre los conteos de subsecciones de la cross-reference, los valores /N de object streams y los recorridos de grafos. MaxDecodedBytes tiene un default de 256 MiB y MaxAllocationBytes de 512 MiB, así que un archivo puede rechazarse antes de la asignación en lugar de después. MaxExpansionRatio tiene un default de 1000.0 y es el que la gente subestima: los filtros de stream de ISO 32000-1 §7.4 son compresión de propósito general, unos pocos kilobytes de datos Flate pueden expandirse legítimamente a cientos de megabytes, y un techo de ratio es la defensa estándar contra una bomba de descompresión. Es ortogonal al tope absoluto de bytes, porque un stream de 200 KiB que quiere volverse 200 MiB está bajo el techo de 256 MiB y sigue siendo absurdo. DeadlineMilliseconds tiene un default de 0, que significa sin deadline, así que esa dimensión es estrictamente opt-in. Los defaults como conjunto son deliberadamente generosos, dimensionados para que los documentos de negocio ordinarios no tropiecen con nada en lugar de ser un perfil endurecido; si tu entrada llega por un formulario de subida público quieres algo más cercano a los números de abajo, junto con las reglas descritas en endurecer un panel de previsualización PDF en Delphi
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Defaults kept: MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // default 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // default 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // default 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // default 0 = off
  ConfigurePdfParserResourceBudget(Budget);
end;
¿Por qué tomar una instantánea en lugar de leer el global?
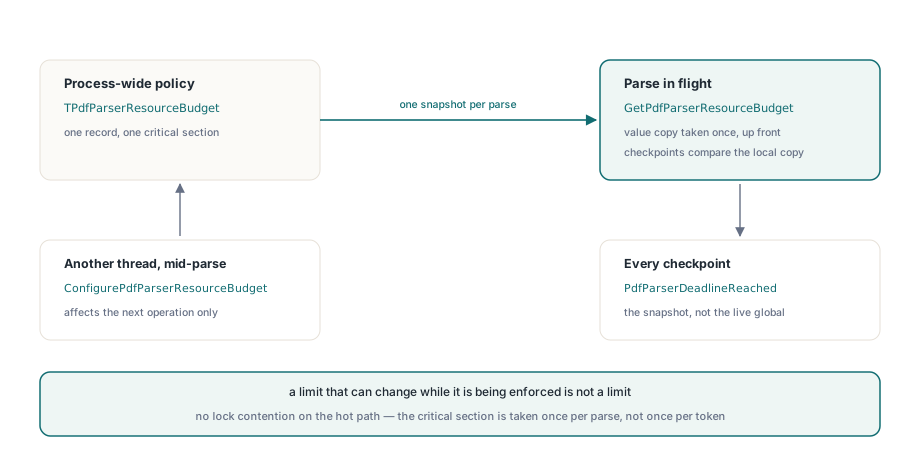
Porque un límite que puede cambiar mientras se está aplicando no es un límite. Este es el punto de diseño central de toda la funcionalidad, y es una línea de disciplina en cada punto de entrada: lee la política una vez al inicio de la operación en un TPdfParserResourceBudget local, y luego haz que cada checkpoint compare contra esa copia local. GetPdfParserResourceBudget toma la sección crítica y devuelve una copia por valor del record, y después de eso el parse nunca vuelve a tocar estado global mutable. El resultado es que una llamada a ConfigurePdfParserResourceBudget desde otro thread afecta a la siguiente operación, nunca a la que está en vuelo. Los parses concurrentes corren bajo políticas distintas sin interferir, una operación que falló por un límite de recursos falló contra un conjunto coherente de umbrales, y no hay contención de lock en el camino caliente porque el lock se toma una vez por parse en lugar de una vez por token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // instantánea tomada una sola vez, por adelantado
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Si escribes tu propio parser sobre la librería, copia esa forma en lugar de llamar a GetPdfParserResourceBudget dentro de tu loop de tokens. Llamarla por token es correcto pero inútil: pagas una sección crítica en cada iteración y reintroduces la deriva a mitad de operación que la instantánea estaba para prevenir
¿Por qué un techo de bytes no detiene un archivo patológico?
Porque el tamaño y el costo solo están vagamente relacionados en PDF. Un archivo de 400 KiB con un stream de cross-reference de ISO 32000-1 §7.5.8 cuyos arreglos /Index y /W describen un conteo de entradas plausible pero hostil, una cadena de object streams que revisita los mismos offsets, o un stream de contenido con operadores que cada uno cuesta más de lo que parece, se sentará cómodamente bajo todos los techos de bytes y objetos que pongas y aun así ocupará un thread de trabajo por minutos. Los conteos de bytes acotan la memoria; no acotan el tiempo. Para eso están PdfParserStartTick y PdfParserDeadlineReached. PdfParserStartTick captura un valor de tick al inicio de la operación y PdfParserDeadlineReached compara el tiempo transcurrido contra DeadlineMilliseconds, devolviendo False siempre que el deadline sea 0. La resta corre en aritmética sin signo, así que un rebalse del contador de ticks no produce un timeout espurio. El parseo de cross-references, la decodificación de object streams, la normalización de tokens de contenido y los lectores de FDF y XFDF lo verifican en las cabezas de sus loops, así que un parse que excede el presupuesto se detiene en un checkpoint en lugar de ser matado desde afuera
Dos advertencias honestas. Es tiempo de reloj de pared, no tiempo de CPU, así que una máquina que hace swapping o un build server bajo carga puede disparar un deadline que una máquina tranquila superaría, lo que aboga por ponerlo muy por encima de tu peor caso observado en lugar de cerca de tu mediana. Y está apagado por default, porque un deadline que se dispara con un documento legítimamente grande durante el procesamiento por lotes de fin de mes es un fallo peor que el que previene. Actívalo por camino de ingreso en lugar de globalmente, y combínalo con las comprobaciones estructurales de validar streams de cross-reference
El presupuesto es un techo, no un reemplazo de los límites de formato
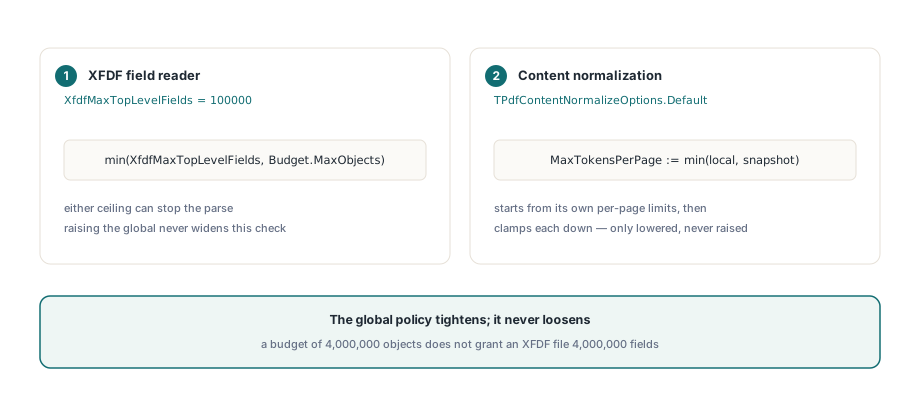
Cada parser conserva sus propias constantes específicas del formato y aplica ambas. XFDF es el ejemplo más claro: el lector de campos aplica XfdfMaxTopLevelFields y una constante MaxFieldNodes de 100000 junto con el valor de la instantánea, y cualquiera de las dos puede detener el parse
const
  XfdfMaxTopLevelFields = 100000;   // format-local, always applies
...
  // Ambos topes están activos; gana el más bajo
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
Esto es intencional y vale la pena internalizarlo antes de ir a buscar una perilla que no existe. Un presupuesto global de 4,000,000 de objetos no le otorga a un archivo XFDF 4,000,000 de campos, porque 100000 campos ya está muy fuera de cualquier cosa que produzca una exportación real de anotaciones, y subir un techo global no debería ensanchar en silencio una comprobación de cordura específica del formato. La normalización de contenido funciona igual desde la otra dirección: TPdfContentNormalizeOptions.Default parte de sus propios límites por página y luego recorta cada uno de ellos hasta la instantánea, así que MaxTokensPerPage solo puede bajar por el presupuesto, nunca subir. La política global aprieta; nunca afloja
La configuración mala falla cuando la configuras
ConfigurePdfParserResourceBudget valida antes de asignar. Un valor no positivo en cualquiera de las seis dimensiones numéricas lanza de inmediato, y MaxDecodedBytes por encima de High(Integer) se rechaza por exceder los límites de la plataforma en lugar de truncarse en silencio en algún lugar profundo de un decoder. Esto importa más de lo que parece: un presupuesto construido desde un archivo de configuración al que le falta una clave te da ceros, y un techo de objetos en cero aceptado al arrancar se convierte en un fallo de parse desconcertante con el primer documento tres horas después, momento en el que nadie sospecha de la configuración. El mismo cuidado aplica a cualquier código que apriete el presupuesto temporalmente, incluidos los tests. La política es de todo el proceso, así que dejar instalado un deadline de 4 segundos cuando un fixture termina envenena a todos los siguientes; guarda y restaura alrededor del cambio
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget es la versión más contundente, restaurando TPdfParserResourceBudget.Default de plano. Úsalo en el teardown de tests donde quieres un estado conocido, y usa guardar-y-restaurar en código de producción, donde lo que la aplicación anfitriona configuró al arrancar es el estado al que debes volver
Dónde el presupuesto deja de ayudar
Es una sola política de todo el proceso, y esa es su principal limitación. No puedes darle a un thread de trabajo un perfil estricto y a otro uno permisivo, porque hay un solo record detrás de una sola sección crítica; si de verdad necesitas límites por tenant, la forma que funciona es serializar cada clase de política en su propio proceso, o enmarcar el trabajo con guardar-y-restaurar y aceptar que el marco solo es seguro cuando nada más está parseando en paralelo. También acota el parseo, no el renderizado: la memoria de rasterización, el crecimiento del cache de fuentes y la decodificación de imágenes quedan fuera de estas siete dimensiones y necesitan sus propios controles. Y un presupuesto te dice que una operación fue demasiado cara, nunca por qué. El techo que se disparó es el síntoma, y el arreglo /Index mal formado o la cadena de filtros desbocada que hay detrás todavía tiene que diagnosticarse a mano, que es por lo que vale la pena entender el camino de decodificación descrito en decodificación de object streams y predictors antes de empezar a mover números. Trata el presupuesto como la cosa que evita que un documento malo se lleve el proceso con él, y mantén tu logging lo bastante bueno para descubrir qué estaba haciendo el documento
Toda la superficie de API del parser, el record del presupuesto y un build desde código fuente para Delphi, C++Builder y Lazarus están en la página del producto: PDFium Component