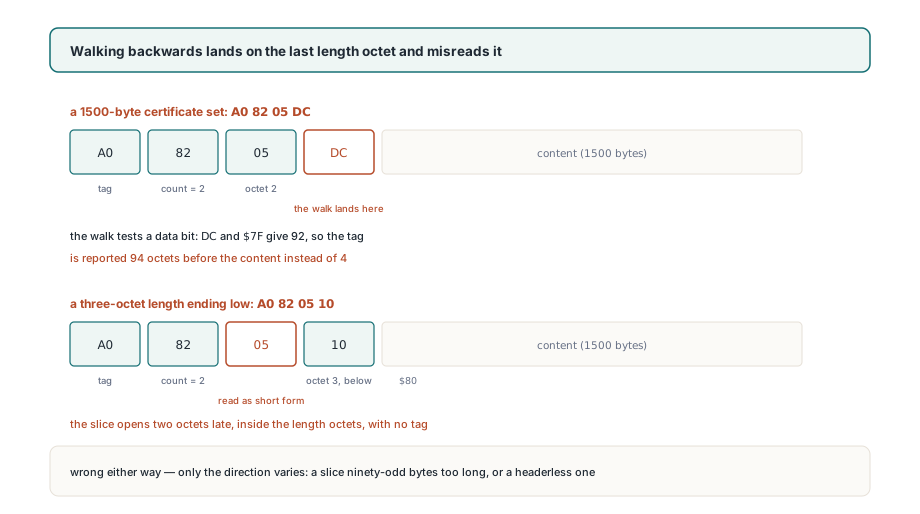
Los cuatro bytes A0 82 05 DC abren un elemento context-specific [0] que carga 1500 bytes de contenido. Leídos de izquierda a derecha son inequívocos: etiqueta A0, un octeto de longitud inicial 82 anunciando dos más, luego 05 DC. Leídos de derecha a izquierda, arrancando desde el primer byte de contenido, el primer octeto que usted encuentra es DC. Su bit alto está en uno y sus siete bits bajos dicen 92, así que un helper que le cree reporta la etiqueta 94 bytes antes del contenido. La distancia real es 4
Nadie camina hacia atrás a propósito. Pasa porque la mayoría de los lectores DER devuelven el offset de contenido y la longitud de cada elemento, que es exactamente lo que usted necesita para descender en él, mientras que copiar un elemento hermano sin cambios necesita el offset de su etiqueta. Restar desde el offset de contenido parece un trabajo de dos líneas, y se queda correcto mientras cada longitud quepa en un solo octeto. La longitud de un conjunto de certificados real nunca cabe en uno
Lo que un sello de tiempo de firma le hace a un CMS firmado
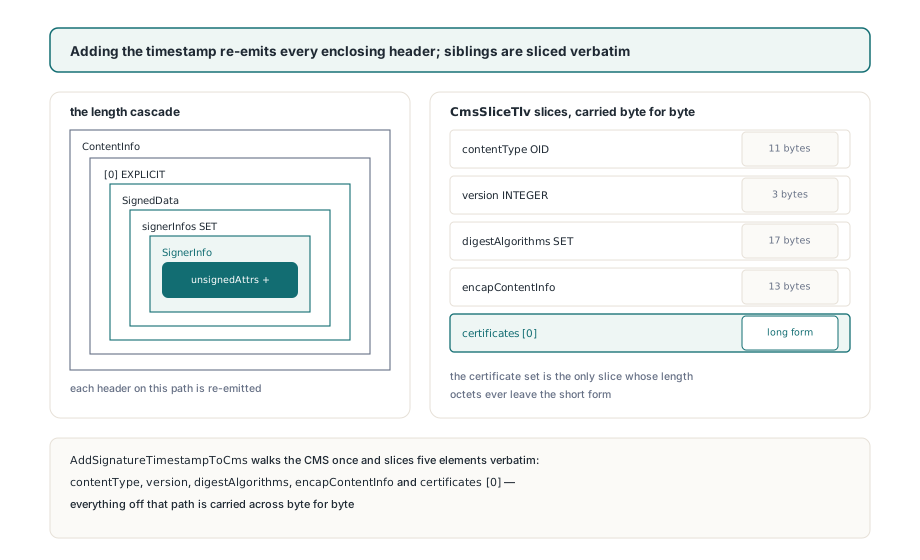
Agregar un sello de tiempo PAdES B-T obliga a re-codificar cada cabecera contenedora del CMS mientras cinco elementos hermanos tienen que pasar byte por byte. El atributo signature-time-stamp que la cláusula 5.3 de ETSI EN 319 122-1 define bajo el OID 1.2.840.113549.1.9.16.2.14 vive en el unsignedAttrs del SignerInfo que describe la cláusula 5.3 de RFC 5652, y el token RFC 3161 dentro de él se calcula sobre el valor de firma. Así que el CMS ya está construido y ya firmado cuando el token llega de la TSA. Un atributo extra alarga el SignerInfo, que alarga el SET signerInfos, luego SignedData, luego el envoltorio EXPLICIT [0], luego el ContentInfo externo
En PDFium Component esa secuencia son tres llamadas exportadas en FPdfCms.pas y FPdfTsa.pas. SignPadesBytes las corre por usted cuando TPadesSignOptions.Level es plB_T o superior y TsaUrl está fijada, y lanza EPadesCrypto cuando se pide un nivel B-T con un TsaUrl vacío en lugar de escribir una firma B-B simple. Si usted construye el CMS usted mismo con BuildSignedData, la cadena se ve así
// CmsDer carga el ContentInfo que BuildSignedData devolvió.
// SignPadesBytes hace los mismos tres pasos cuando Options.Level >= plB_T
var
  SigValue: TBytes;
  Ts: TPadesTimestamp;
begin
  if not ExtractSignatureValue(CmsDer, SigValue) then
    raise Exception.Create('CMS carries no signature value');
  // El messageImprint de la TSA se calcula sobre los octetos del valor de firma
  Ts:= RequestTimestamp(TsaUrl, SigValue, Nonce);
  // Re-codifica SignerInfo hasta ContentInfo, copia los hermanos sin cambios
  AddSignatureTimestampToCms(CmsDer, Ts.TokenDer);
end;
AddSignatureTimestampToCms traslada cinco elementos intactos: el OID contentType, el INTEGER de versión de SignedData, el SET digestAlgorithms, la SEQUENCE encapContentInfo y, cuando está presente, el set certificates [0]. En el CMS que BuildSignedData emite con SHA-256, cuatro de esos son diminutos: 11 bytes para el OID, 3 para la versión, 17 para el set de algoritmos de digest, 13 para el encapContentInfo detached. El set de certificados carga el certificado del firmante seguido de cada certificado de cadena que usted pasó. Un certificado X.509 real llega a varios cientos de bytes. Esta es la única porción cuyos octetos de longitud siempre usan la forma larga
¿Por qué los octetos de longitud DER no se pueden recorrer hacia atrás?
El conteo de octetos de longitud está guardado en el primero de ellos, y un camino hacia atrás encuentra al último primero. La cláusula 8.1.3.4 de X.690 define la forma corta: un octeto, bit 8 en cero, bits 7 a 1 cargando una longitud de 0 a 127. La cláusula 8.1.3.5 define la forma larga. Su octeto inicial tiene el bit 8 en uno, y los bits 7 a 1 cuentan los octetos siguientes que cargan la longitud como entero sin signo big-endian. Nada marca un octeto siguiente como siguiente. Su bit 8 es un bit de magnitud como los otros siete. Así que un helper que prueba el bit alto de Buf[ContentOffs- 1] está probando datos y después leyendo datos como un conteo
// El helper tentador, al que solo se le da el offset de contenido. No lo embarque
function NaiveHeaderStart(const Buf: TBytes; ContentOffs: Integer): Integer;
var
  P, LenByte: Integer;
begin
  P:= ContentOffs- 1;            // cae en el ÚLTIMO octeto de longitud
  if P< 0 then
    Exit(ContentOffs);
  LenByte:= Buf[P];
  if (LenByte and $80)= 0 then   // solo tiene sentido para el PRIMERO
    Result:= P- 1
  else
    Result:= P- (LenByte and $7F)- 1;
end;

// A0 82 05 DC (1500 bytes): Buf[ContentOffs- 1]= $DC, $DC and $7F= 92
//   Result= ContentOffs- 94, la etiqueta está en ContentOffs- 4
// A0 82 05 10 (1296 bytes): $10 tiene el bit 8 en cero, se lee como forma corta
//   Result= ContentOffs- 2, que apunta al 05 dentro de los octetos de longitud
Ambas direcciones de falla aparecen con tamaños ordinarios. Un set de certificados de 1500 bytes termina su cabecera en DC, y el helper arranca la porción 90 bytes demasiado temprano. Un set de 1296 bytes termina en 10, el helper lo toma por una longitud de forma corta, y la porción arranca dos bytes tarde sin etiqueta alguna. Que una cadena dada caiga en el primer o el segundo caso no depende de más que del byte bajo de su longitud total
El caso temprano también puede salirse por el frente del búfer. Para un CMS dispuesto como lo dispone BuildSignedData, con cada longitud contenedora tomando dos octetos, el contenido del set de certificados arranca 60 bytes adentro: 4 por la cabecera del ContentInfo, 11 por el OID, 4 cada uno por las cabeceras [0] y SignedData, luego 3, 17 y 13 por los hermanos pequeños y 4 por la cabecera del set de certificados. Resta 94 de 60 y el helper devuelve -34. Su único guardia está sobre ContentOffs- 1, así que el resultado negativo va directo a la copia
Lo que la cláusula 10.1 de X.690 fija
DER hace de la codificación de longitud una función pura de la longitud. La cláusula 10.1 de X.690 restringe DER a la forma definida y exige la cantidad mínima de octetos, lo que elimina las dos libertades que BER permite: la forma indefinida, y una longitud de forma larga rellenada con octetos cero a la izquierda. Bajo esa regla una longitud de contenido por debajo de 128 toma siempre exactamente un octeto de longitud. Cualquier otra longitud toma un octeto inicial más exactamente tantos octetos siguientes como bytes significativos tenga el valor. Eso da 81 80 para 128. En 256 la cabecera crece a 82 01 00, y 65536 necesita 83 01 00 00. Código que ya tiene la longitud de contenido puede calcular el tamaño de la cabecera sin leer un solo byte del búfer
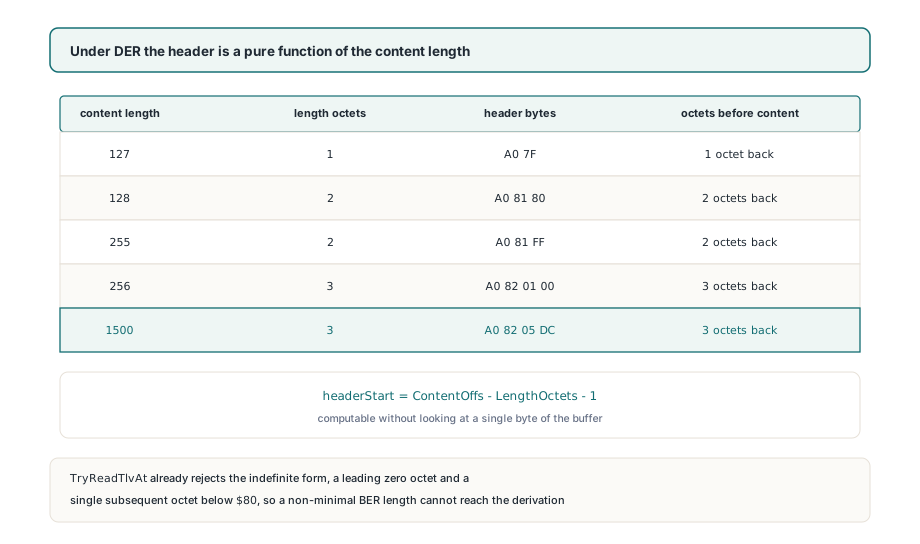
La derivación es solo tan buena como la afirmación de que la entrada realmente es DER. TDerReader.TryReadTlvAt hace cumplir esa afirmación antes de que cualquier porción se corte. Rechaza un octeto de longitud inicial de $80 (la forma indefinida), una longitud de forma larga cuyo primer octeto siguiente es cero, un único octeto siguiente por debajo de $80 que debió ser una forma corta, y más de cuatro octetos siguientes. ReadTlv está construido sobre TryReadTlvAt, así que cada elemento que AddSignatureTimestampToCms recorre ya pasó esos chequeos. Una longitud rellenada estilo BER nunca llega a la aritmética
Dentro de AddSignatureTimestampToCms el offset de etiqueta de cada hermano se deriva de su offset de contenido y longitud de contenido de esta manera. Cuando el arranque derivado cae antes del comienzo del búfer, lo que significa que los offsets no pueden ir juntos, el procedimiento lanza una excepción con el mensaje CMS: TLV header precedes the buffer start y no produce ningún CMS. Una reconstrucción malformada que igual parsea es mucho más difícil de trazar que una excepción en el punto donde los offsets dejaron de concordar
La derivación carga una suposición más: el identificador toma un solo octeto. X.690 permite identificadores de varios octetos para números de etiqueta de 31 en adelante, y TryReadTlvAt los parsea. El SignedData de CMS nunca usa uno, ya que sus etiquetas son SEQUENCE, SET, INTEGER y OID universales más el [0] y el [1] context-specific, así que la suposición se sostiene para cada elemento que la reconstrucción del sello de tiempo toca
Copiar elementos hermanos en su propio código DER
Si usted escribe código contra TDerReader, sáltese la derivación por completo. PeekTlv y ReadNextTlv llenan un record TDerTlv cuyo Offset ya apunta a la etiqueta y cuyo HeaderLength es el tamaño medido de etiqueta más octetos de longitud, y EncodedBytes devuelve el elemento desde Offset hasta NextOffset. Ese camino también se las arregla con identificadores de varios octetos, que ninguna aritmética de longitudes puede recuperar. El ReadTlv de cuatro parámetros de salida es conveniente para descender. Solo reporta el lado del contenido, sin embargo, así que úselo cuando necesita contenido y la forma de record cuando necesita el elemento completo
// Cada hijo de SignedData como TLV completo: etiqueta, octetos de longitud, contenido.
// TDerTlv.Offset apunta a la etiqueta, así que no hay aritmética de cabeceras
function SignedDataChildren(const CmsDer: TBytes): TDerByteArrays;
var
  Root, Ci, Explicit0, Sd: TDerReader;
  Tlv: TDerTlv;
begin
  Result:= nil;
  Root.Initialize(CmsDer);
  if not Root.ReadNextTlv(Tlv) or not Root.EnterConstructed(Tlv, Ci) then
    raise Exception.Create('ContentInfo SEQUENCE expected');
  if not Ci.SkipTlv then                            // OID contentType
    raise Exception.Create('contentType OID expected');
  if not Ci.ReadNextTlv(Tlv) or not Ci.EnterConstructed(Tlv, Explicit0) then
    raise Exception.Create('[0] EXPLICIT content expected');
  if not Explicit0.ReadNextTlv(Tlv) or not Explicit0.EnterConstructed(Tlv, Sd) then
    raise Exception.Create('SignedData SEQUENCE expected');
  while not Sd.AtEnd do
  begin
    if not Sd.ReadNextTlv(Tlv) then
      raise Exception.Create('SignedData child malformed');
    SetLength(Result, Length(Result)+ 1);
    Result[High(Result)]:= Sd.EncodedBytes(Tlv);   // p. ej. A0 82 05 DC ...
  end;
end;
Para los casos donde alguna otra API le da nada más que un offset de contenido y una longitud, la derivación hacia adelante es corta. DerHeaderStart, mostrado con su chequeo de frontera en la siguiente sección, es código suyo; refleja la regla de la cláusula 10.1 y devuelve -1 para offsets que no pueden ser consistentes, así que el caller tiene un valor que puede rechazar en lugar de un byte de arranque de apariencia plausible
¿Por qué los certificados de prueba cortos esconden el error?
Un certificado de relleno pequeño mantiene el set de certificados en la forma corta, y el camino hacia atrás es correcto exactamente para ese caso. Un set de 32 bytes se codifica como A0 20 y uno de 64 como A0 40. Caminando hacia atrás desde el contenido se aterriza en ese único octeto de longitud, y su bit alto está en cero porque es el primero y único. Respuesta correcta, razón equivocada. Un test de sello de tiempo construido sobre certificados tan pequeños puede re-parsear el resultado, encontrar el atributo, reportar B-T, y jamás empujar un set de certificados de tamaño realista por la porción
Cualquier ruta de código que dependa de cómo se codifica una longitud necesita entrada de test que cruce la frontera de codificación. Para DER eso significa contenido de 128 bytes o más, que fuerza la forma larga, y de 256 bytes o más, que fuerza un segundo octeto siguiente. El chequeo de abajo compara DerHeaderStart contra la cabecera que el reader midió mientras parseaba, en ambas fronteras y en el caso de 1500 bytes de la apertura. Un SET OF sin ordenar en signedAttrs se escapa de los round trips de mismo origen por la misma razón estructural: el test solo alimenta entradas en las que el código equivocado y el correcto concuerdan
// Su propio helper para APIs que reportan solo offset de contenido y longitud.
// Asume un identificador de un octeto, cierto para cada etiqueta en CMS SignedData
function DerHeaderStart(ContentOffs, ContentLen: Integer): Integer;
var
  LengthOctets, Remaining: Integer;
begin
  LengthOctets:= 1;                  // forma corta, X.690 8.1.3.4
  if ContentLen>= 128 then
  begin
    Remaining:= ContentLen;          // forma larga, X.690 8.1.3.5
    while Remaining> 0 do
    begin
      Inc(LengthOctets);             // uno por byte significativo
      Remaining:= Remaining shr 8;
    end;
  end;
  Result:= ContentOffs- LengthOctets- 1;
  if Result< 0 then
    Result:= -1;                     // offsets inconsistentes: deje que el caller lance
end;

// Chequeo de frontera, escrito como código de test suyo: el offset de etiqueta derivado
// debe ser igual al offset que TDerReader midió mientras parseaba la cabecera
procedure CheckHeaderDerivation;
const
  Lens: array[0..6] of Integer= (127, 128, 255, 256, 1500, 65535, 65536);
var
  W: TDerWriter;
  R: TDerReader;
  Tlv: TDerTlv;
  Content: TBytes;
  I: Integer;
begin
  W:= TDerWriter.Create;
  try
    for I:= Low(Lens) to High(Lens) do
    begin
      SetLength(Content, Lens[I]);
      R.Initialize(W.Wrap($A0, Content));   // A0 7F / A0 81 80 / A0 82 05 DC ...
      W.Clear;
      if not R.PeekTlv(Tlv) then
        raise Exception.CreateFmt('unreadable TLV for %d bytes', [Lens[I]]);
      if DerHeaderStart(Tlv.ContentOffset, Tlv.ContentLength)<> Tlv.Offset then
        raise Exception.CreateFmt('header start wrong for %d bytes', [Lens[I]]);
    end;
  finally
    W.Free;
  end;
end;
La misma frontera es alcanzable de punta a punta a través de las funciones exportadas. Entréguele a BuildSignedData certificados de cadena cuyo tamaño combinado deje el set de certificados justo por debajo y justo por encima de 128 y 256 bytes, corra AddSignatureTimestampToCms sobre cada resultado, luego recorra la salida con SignedDataChildren y compare el elemento del set de certificados byte por byte con el del CMS antes de que el sello de tiempo se agregara
Lo que AddSignatureTimestampToCms acepta
AddSignatureTimestampToCms está escrito para el CMS que BuildSignedData emite: un SignerInfo, un set certificates [0] opcional, sin crls [1] y sin unsignedAttrs todavía. Entréguele un SET signerInfos con más de un SignerInfo y lanza una excepción en lugar de quedarse con el primer firmante y tirar el resto. Un CMS que carga un set crls [1] se detiene en la excepción CMS: signerInfos SET expected, porque el elemento después de los certificados no es el SET que el recorrido busca. Ambas negativas suceden antes de que algo se escriba de vuelta en CmsDer
El nuevo unsignedAttrs carga exactamente un atributo, así que la regla de ordenamiento SET OF de la cláusula 11.6 de X.690 se cumple sin ordenar. La parte firmada del SignerInfo, desde su versión hasta el OCTET STRING de la firma, se copia como un bloque, lo que significa que un validador que re-digiere signedAttrs ve los mismos bytes antes y después de que el token se agregue. Cuando un validador igual rechaza el documento, las causas suelen sentarse en otro lado y están cubiertas en esta checklist de razones de rechazo PAdES. Lo que el token le compra con el tiempo, y cómo B-LT y B-LTA se construyen sobre él, está en el recorrido de sellos de tiempo RFC 3161 y el DSS
El lector y escritor DER en FPdfAsn1.pas, el constructor CMS y el paso de sello de tiempo en FPdfCms.pas son todo código fuente Pascal que viene con el PDFium Component for Delphi. Cuando un SignedData reconstruido se niega a parsear en un validador, usted puede recorrer paso a paso el código que cortó cada elemento y chequearlo contra la cláusula de X.690 que cita