HotXLS, la biblioteca nativa de Excel para Delphi y C++Builder, analiza las hojas de cálculo XLSX en varios hilos mediante una carga de tres fases: el XML de las hojas se descomprime en serie, se analiza en paralelo y las partes pequeñas se leen en serie después. La primera versión de esa función ganó solo un 12–25%, porque el bloqueo del gestor de memoria predeterminado de Delphi serializaba los hilos de trabajo. Reducir las asignaciones de heap de aproximadamente 20 a 9.1 por celda elevó la aceleración paralela a ×1.90 con ocho hilos. Este artículo recorre las mediciones, los desvíos equivocados y las dos correcciones que realmente funcionaron
¿Cómo analiza HotXLS las hojas de cálculo XLSX en paralelo?
HotXLS divide Open en tres fases, y solo la del medio se ejecuta en hilos de trabajo. La razón es el contenedor zip: un archivo zip es un único flujo de entrada compartido con una única máquina de estados de inflate, y esa máquina de estados no puede ser leída por dos hilos a la vez. Envolverla en un bloqueo sería inútil, porque inflate es inherentemente serial por entrada, así que un bloqueo solo reproduciría la ejecución serial con sobrecarga adicional. Por eso la fase A descomprime el XML de cada hoja de cálculo en su propio TMemoryStream todavía en un solo hilo; en nuestro archivo de referencia esto tomó unos 4 ms para ocho partes de hoja, así que está muy lejos de ser el cuello de botella. La fase B ejecuta ParseWorksheetXml para cada hoja en un pool de trabajadores, que es donde vive casi todo el tiempo de carga. La fase C vuelve al zip en serie para las partes pequeñas: comentarios, dibujos, gráficos y tablas
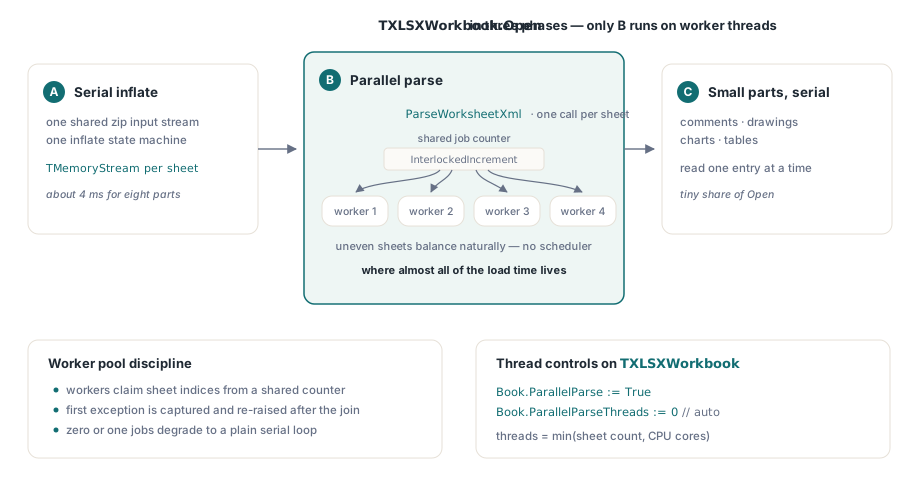
El pool de trabajadores en sí es deliberadamente simple. Los trabajadores toman índices de trabajo de un contador compartido con InterlockedIncrement, así que las hojas de tamaño desigual se balancean de forma natural sin ningún planificador. El número de hilos es min(sheet count, CPU cores), la primera excepción de un trabajador se captura con AcquireExceptionObject y se vuelve a lanzar en el hilo principal después del join, y el despachador se degrada a un bucle serial simple cuando hay cero o un trabajo. Dos propiedades de TXLSXWorkbook controlan la función: ParallelParse habilita el pool y ParallelParseThreads limita el número de hilos, donde 0 significa automático. Los libros de trabajo con varias hojas son la forma que se beneficia, incluido el tipo que se produce al duplicar una hoja de cálculo de plantilla docenas de veces
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // habilita el pool paralelo de trabajadores
    Book.ParallelParseThreads := 0;  // 0 = auto: min(hojas, núcleos de CPU)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... lea las celdas como siempre; el libro está completamente materializado ...
  finally
    Book.Free;
  end;
end;
¿Por qué agregar hilos hace más lento el análisis de XLSX en Delphi?
Porque el gestor de memoria predeterminado de Delphi protege su heap con un bloqueo global, y el análisis de hojas de cálculo es denso en asignaciones: celdas, Variants y WideStrings por millones. Cada trabajador que toca el heap hace fila en ese bloqueo, así que hilos que parecen independientes en el código fuente se ejecutan casi de uno en uno en la práctica. Nuestra primera prueba de referencia lo hizo dolorosamente concreto. En un libro de trabajo de 8 hojas con 5,000 filas por 4 columnas por hoja, medido en un i5-11600K (6 núcleos, 12 hilos) bajo Win64, el Open paralelo mejoró solo un 12–25% frente a una estimación del plan de al menos 40%. Un barrido de conteo de hilos por 2, 3, 4, 6 y 8 hilos produjo una curva plana, y en corridas instrumentadas posteriores la configuración de 2 hilos fue en realidad 26% más lenta que la serial, la firma clásica de dos hilos peloteando un bloqueo en disputa
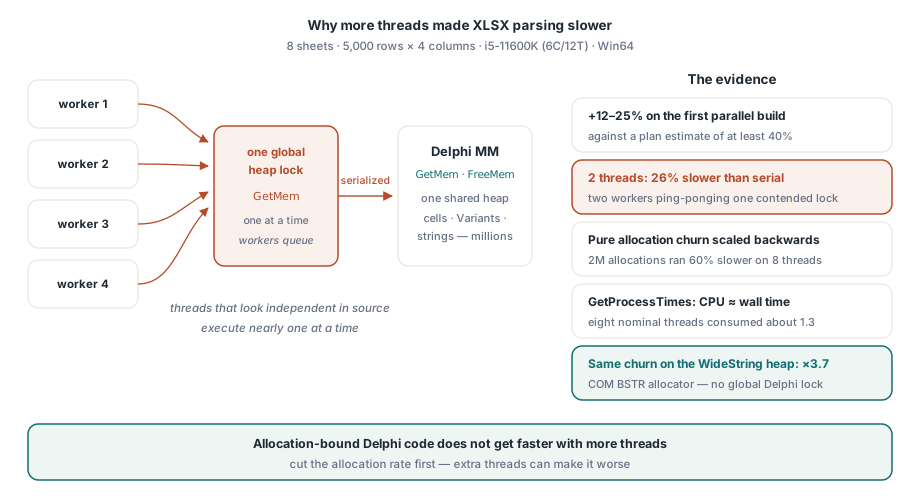
Tres mediciones fijaron el diagnóstico, y cada una derribó la intuición anterior. Primero, un archivo diminuto (8 hojas de 1 fila) se abrió en 1.2 ms, lo que demostró que el análisis es esencialmente el 100% de Open y que no había ningún costo fijo oculto al que culpar. Segundo, un microbenchmark de pura rotación de asignaciones mostró al gestor de memoria de Delphi escalando al revés: el mismo volumen total de 2 millones de asignaciones de objetos y AnsiString corrió 60% más lento con 8 hilos que con uno, mientras que la misma rotación contra el heap de WideString, que es el asignador COM BSTR y no el MM de Delphi, escaló a ×3.7. Que HotXLS use WideString en todas partes resultó ser un accidente histórico que jugaba a nuestro favor. Tercero, GetProcessTimes mostró que durante un Open paralelo el tiempo de CPU era aproximadamente igual al tiempo de reloj: ocho hilos nominales consumían el equivalente a unos 1.3 hilos de CPU. Los trabajadores no estaban girando; estaban dormidos en la ruta de contención del gestor de memoria, bloqueados en lugar de ocupados
La lección práctica se generaliza más allá de las hojas de cálculo. Si una carga de trabajo de Delphi asigna intensamente, aumentar el número de hilos no sirve de nada hasta que baje la tasa de asignación, y fácilmente puede empeorar las cosas. Antes de esta corrección, les decíamos a los usuarios que ajustaban ParallelParseThreads la pura verdad: en archivos limitados por asignaciones, más hilos compraban casi nada
¿De dónde salen 20 asignaciones de heap por celda?
Un envoltorio contador instalado con SetMemoryManager respondió esa pregunta con precisión: unas 20 asignaciones del MM de Delphi por celda, 2.87 millones de ellas de 32 bytes o menos. El culpable no eran los objetos de celda en absoluto. TXMLScaner.GetTokenValue materializaba un AnsiString nuevo en cada llamada, y se le llama aproximadamente 15–20 veces por celda: una vez por cada nombre de elemento, nombre de atributo, valor de atributo y contenido de texto. Encima de eso, la ruta UTF8ToWideString de la RTL fabricaba un UnicodeString intermedio temporal por cada conversión. Los objetos de celda representaban solo 160 mil asignaciones, alrededor del 8% del total, lo que mató nuestro plan original en el acto: pretendíamos construir un pool de objetos de celda, y los números decían que nunca se pagaría a sí mismo
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // la rotación de objetos pequeños que nos interesa
  Result := OldMM.GetMem(Size);
end;

// instalar antes de Open, restaurar después
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Ese diagnóstico de diez minutos vale la pena robarlo para cualquier investigación de rendimiento en Delphi. Contar asignaciones por rango de tamaño no cuesta casi nada de construir y le dice dónde se origina realmente la presión sobre el gestor de memoria, que en nuestro caso eran dos hábitos a nivel de RTL dentro del escáner XML y no nada del modelo de objetos. Los perfiladores seguían señalando al analizador como un todo; el envoltorio señaló dos líneas específicas
La corrección: internado de tokens y un decodificador UTF-8 sin intermedios
Dos cambios puntuales en el lector XML eliminaron más de la mitad de las asignaciones por celda sin tocar la estructura del analizador. El primero es el internado de nombres de elemento. El XML de hoja de cálculo repite sin cesar un vocabulario diminuto: row, c, v, r, t, s y un puñado de nombres de atributo. InternTokenName mantiene una caché de 64 ranuras con nombres ya vistos y compara el búfer del constructor del escáner con una entrada en caché mediante TokenEqualsAnsi, una comparación directa de bytes que no asigna nada. En un acierto, devuelve el AnsiString en caché, y aquí importa la elección de tipo: AnsiString tiene conteo de referencias, así que devolver una instancia en caché cuesta un incremento de refcount y cero tráfico de heap. WideString no tiene conteo de referencias, y cada asignación pasa por SysAllocString, así que internar WideStrings no ahorraría nada. El internado solo vale la pena en el tipo de cadena con conteo de referencias
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // solo refcount++, sin asignación
  else
  begin
    Result := GetTokenValue;        // materializar una vez, luego cachear
    FInternNames[Slot] := Result;
  end;
end;
El segundo cambio ataca el texto de las celdas. La ruta antigua construía un token AnsiString, se lo entregaba a UTF8ToWideString, que construía un UnicodeString intermedio, que finalmente se convertía al WideString que la celda almacena: dos asignaciones del MM de Delphi por token de texto antes de la real. El reemplazo, XmlUtf8ToWide(TokenPtr, TokenLen), es un decodificador UTF-8 de dos pasadas en Pascal puro que lee directamente del búfer de escaneo: la primera pasada mide la longitud UTF-16, la segunda decodifica en un WideString asignado una sola vez. Costo neto por token de texto: una asignación COM, cero asignaciones del MM de Delphi. Una nota semántica para los cautelosos: ante secuencias UTF-8 malformadas el nuevo decodificador deja pasar los bytes en lugar de sustituir caracteres de reemplazo como hace la RTL, lo que solo afecta a cómo se degradan los archivos corruptos; con entrada válida la salida es idéntica byte a byte. Las entidades de carácter XML nunca llegan al decodificador, porque el escáner ya las ha resuelto a UTF-8 en el búfer de tokens
Qué se ganó, y dónde el análisis paralelo todavía no ayudará
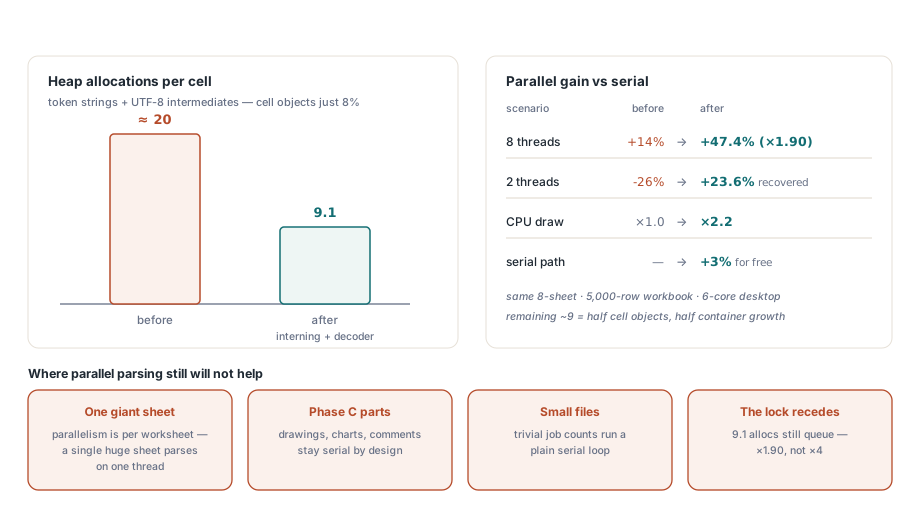
Las dos correcciones redujeron las asignaciones por celda de unas 20 a 9.1, y los números paralelos se movieron como decía la teoría que debían. En la misma prueba de referencia de 8 hojas y 5,000 filas y la misma máquina 6C12T, la mejora con 8 hilos pasó del 14% al 47.4%, una aceleración de ×1.90 sobre la serial. El caso de 2 hilos pasó de ser 26% más lento a 23.6% más rápido, y la utilización de CPU medida subió de ×1.0 a ×2.2. La ruta serial se volvió cerca de 3% más rápida como extra, ya que menos asignaciones también ayudan a un solo hilo. Las ~9 asignaciones restantes por celda son aproximadamente mitad objetos de celda y mitad crecimiento amortizado de contenedores; las medimos, juzgamos que los retornos eran decrecientes y nos detuvimos, con el envoltorio del MM listo para volver a muestrear por sitio de llamada si una carga de trabajo futura justifica otra ronda
Los límites merecen enunciarse tan claramente como las ganancias. HotXLS paraleliza a granularidad de hoja de cálculo, así que un libro de trabajo que es una sola hoja gigante se analiza en un hilo diga lo que diga ParallelParseThreads; para esa forma, el lector directo en streaming es la mejor herramienta, ya que evita materializar el libro de trabajo por completo. Los archivos cuyo tiempo se va en partes de la fase C, dibujos y gráficos y comentarios, ven menos beneficio porque esa fase permanece serial por diseño. Los archivos pequeños no valen la pena de enhebrar en absoluto, y por eso el despachador corre en serie silenciosamente para conteos de trabajo triviales. Y el techo del gestor de memoria no ha desaparecido, solo retrocedió: con 9.1 asignaciones por celda el bloqueo global todavía grava a los trabajadores, y por eso ocho hilos rinden ×1.90 en lugar de ×4. Para el conjunto más amplio de herramientas para recortar tiempos de carga y guardado, incluidos estilos, pools y callbacks de filas en bloque, vea nuestra guía sobre rendimiento con libros de trabajo grandes en Delphi
El análisis paralelo de XLSX, las propiedades ParallelParse y ParallelParseThreads y el lector XML ligero en asignaciones descrito aquí se distribuyen como partes estándar de HotXLS Delphi Excel Component, que lee y escribe XLS, XLSX y ODS de forma nativa desde Delphi y C++Builder sin automatización de Excel de por medio