Un workbook ODS con una tabla dinámica pasa por una biblioteca, se edita una sola celda fuente, y el archivo guardado se abre con todos los valores intactos y la tabla dinámica desaparecida: content.xml traía un <table:data-pilot-table> al entrar y trae cero al salir. La reparación obvia es copiar el XML del pivot como cadena. Eso restaura el conteo de elementos, y entonces un parser consciente de namespaces rechaza la parte guardada de plano con un error de prefijo sin enlace. Ambos fallos tienen una sola raíz. Un fragmento de XML solo viaja con seguridad cuando las declaraciones de namespace de las que depende viajan con él
Dónde vive una definición de pivot ODS en content.xml
Una tabla dinámica de OpenDocument, que el formato llama data pilot, es una definición guardada después de las hojas en content.xml, y un writer que reconstruye esa parte desde su propio modelo de objetos solo la conserva si el modelo tiene dónde ponerla. ODF 1.3 Part 3 §9.6 describe el contenedor: <table:data-pilot-tables> guarda un <table:data-pilot-table> por pivot, cada uno con un table:source-cell-range, un conjunto de hijos table:data-pilot-field, un table:target-range-address y una lista table:buttons. Las celdas de resultado que la tabla dinámica muestra viven dentro de la hoja como celdas ordinarias. Así que un writer que solo regenera celdas, estilos, validaciones, named expressions y database ranges produce una hoja de cálculo perfectamente válida con los mismos números en pantalla y sin el pivot detrás
HotXLS Delphi Excel Component lee todo el subárbol <table:data-pilot-tables> de content.xml durante OpenODS, antes de parsear una sola celda, y luego intenta traducir la colección a su modelo de pivots. Una definición en la forma simple que el modelo representa, con rango fuente local, un campo de fila, medidas de agregación y resultados guardados que concuerdan con los datos fuente, se convierte en un TXLSPivotTable en la lista PivotTables de la hoja, el mismo objeto que se obtiene de un pivot XLSX y se puede ampliar con campos calculados y refrescar desde Delphi. Todo lo que quede fuera de esa forma mantiene la colección como XML capturado, y SaveAsODS lo escribe de vuelta. Basta un atributo en un namespace que el traductor no conoce: los pivots guardados por LibreOffice pueden traer atributos loext: y calcext:, y un atributo loext: manda la definición por la ruta de captura
El fallback es todo o nada por workbook. Si un pivot de una colección de tres queda fuera de la forma traducible, los tres se quedan como XML capturado. Partirlos dejaría content.xml con dos fuentes de verdad para un mismo contenedor, media parte reconstruida desde objetos y media reproducida desde texto, y cualquier desacuerdo entre las mitades aterrizaría en el archivo del usuario. Mantener la colección entera es el valor por defecto más seguro, y es la misma política que HotXLS aplica a los bloques extLst desconocidos en XLSX: lo que el modelo no puede cargar se conserva tal como fue escrito
Por qué una definición de pivot cortada rompe el archivo guardado
Una definición de pivot recortada de content.xml con una búsqueda de cadenas pierde las declaraciones de namespace que dan significado a sus prefijos, y Namespaces in XML trata un prefijo sin declaración como un error de buena formación. El enfoque de cadenas es corto: decodificar la parte a un WideString, buscar <table:data-pilot-tables con Pos, buscar la etiqueta de cierre correspondiente después, y copiar todo lo de en medio. El texto que sale parece completo. Trae loext:ignore-selected-page="true" en un campo de página y calcext:repeat-item-labels="false" en cada nivel, pero las declaraciones xmlns:loext y xmlns:calcext que enlazan esos prefijos están en la raíz del documento, <office:document-content>, miles de caracteres antes
Namespaces in XML 1.0 §6.1 pone una declaración en alcance desde la etiqueta inicial que la lleva hasta la etiqueta de cierre correspondiente, y todo nombre con prefijo dentro se resuelve contra ella. Recorte un subárbol del documento y lo recorta fuera de ese alcance. Cuando el fragmento se pega en un documento nuevo, cada prefijo se resuelve solo si la nueva raíz casualmente lo declara. HotXLS escribe su propio <office:document-content> con los namespaces que su writer usa, entre ellos office, table, text, style, fo, draw, calcext, tableooo y of. En la copia recortada table: se resuelve, calcext: se resuelve, y loext: no. Un solo prefijo sin enlace basta para que un parser consciente de namespaces rechace la parte completa, así que el pivot no degrada con elegancia; los datos de la hoja alrededor también se vuelven ilegibles
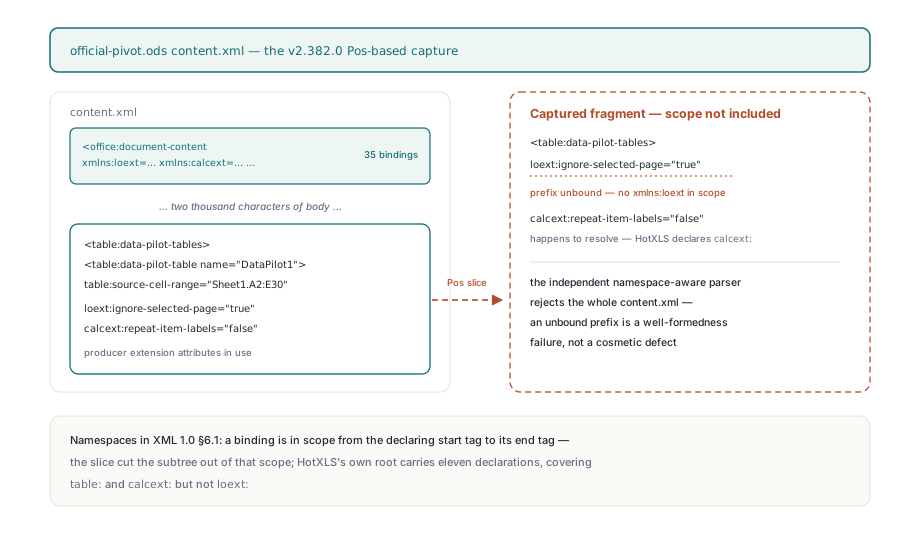
La búsqueda de cadenas tiene otros puntos ciegos que una captura basada en reader nunca encuentra. Pos coincide con el texto de la etiqueta dentro de un comentario, dentro de una sección CDATA o dentro de un valor de atributo que lo cite. No puede distinguir elementos anidados del mismo nombre. Y coincide con el prefijo literal table:, mientras ODF permite al productor enlazar el namespace table al prefijo que le guste
Cómo HotXLS traslada el alcance de namespace al fragmento
HotXLS captura el subárbol del pivot con un lector XML de streaming que rastrea cada declaración de namespace junto con la profundidad donde apareció, y copia las declaraciones vigentes a la etiqueta de apertura del fragmento en el momento en que llega el elemento objetivo. La pila crece con cada etiqueta inicial que declara xmlns o xmlns:prefix y se encoge cuando cierra el elemento que declaró un enlace. Los elementos vacíos necesitan el mismo tratamiento: <x xmlns:p="..."/> nunca produce un evento de etiqueta de cierre separado, así que el pop tiene que dispararse también en la etiqueta inicial vacía, o un enlace se filtra hacia sus hermanos
En el objetivo, la captura recorre la pila desde el enlace más interno hacia afuera y escribe cada prefijo una vez. Recorrer de adentro hacia afuera es lo que implementa el sombreado (shadowing). Si <office:spreadsheet> reenlaza un prefijo que la raíz ya declaró, el valor más cercano es el que está en vigor en el pivot, exactamente como exige §6.1, y un conjunto de prefijos ya escritos evita que el valor externo lo siga. Un prefijo que el propio elemento pivot declara sobre sí se salta, porque escribir xmlns:table dos veces en una etiqueta es un error de buena formación distinto
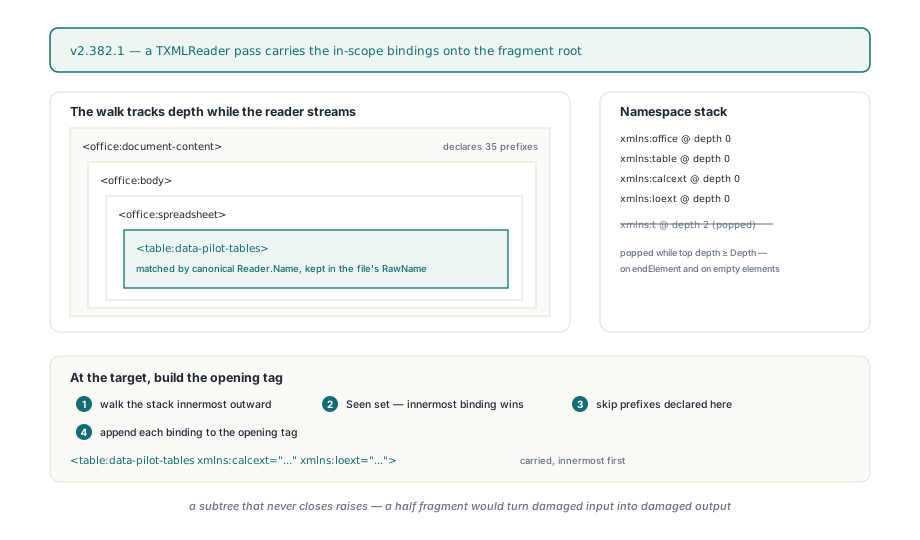
El objetivo se empareja por namespace, así que un productor que escribe <t:data-pilot-tables> con t enlazado al URI de tabla ODF sigue siendo reconocido, mientras las etiquetas capturadas conservan la ortografía del archivo. Los nodos de texto con espacios vuelven exactamente como fueron escritos. El entrecomillado de atributos y la elección entre <x/> y <x></x> se normalizan, porque el fragmento se re-serializa desde eventos del lector en lugar de copiarse byte a byte. Si content.xml termina mientras el subárbol del pivot sigue abierto, como pasa en un archivo truncado, la apertura falla con una excepción en lugar de conservar media definición que se escribiría de vuelta en el siguiente guardado
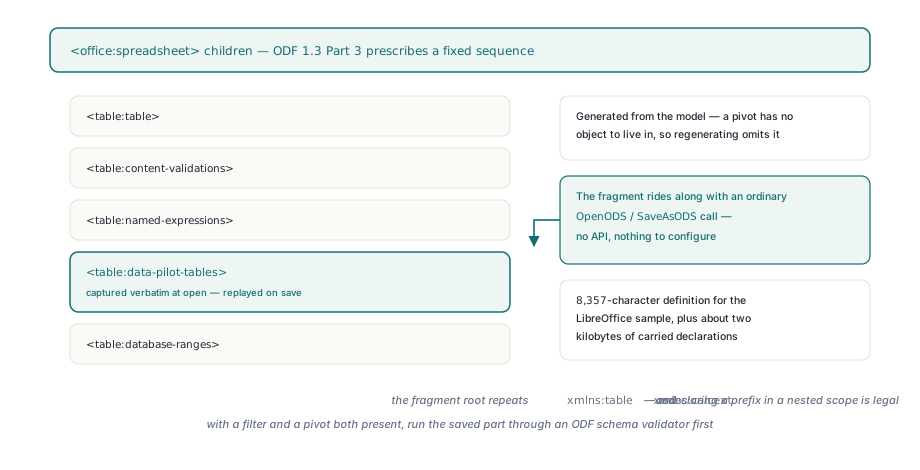
El conjunto trasladado es deliberadamente generoso. La captura copia cada enlace en alcance, lo use el subárbol o no, así que la raíz del fragmento repite xmlns:table y xmlns:calcext aunque la raíz del documento guardado también los declare. Redeclarar un prefijo en un ámbito anidado es legal bajo Namespaces in XML, y un archivo de un productor que declara docenas de namespaces en su raíz gana un par de kilobytes. Recortar la lista significaría escanear el subárbol buscando cada prefijo en nombres de elementos, nombres de atributos y valores de atributos que contienen QNames, y un solo fallo ahí trae de vuelta de inmediato el error de prefijo sin enlace. Unas cuantas declaraciones redundantes cuestan mucho menos que ese riesgo
Abrir, editar y guardar un workbook que trae un pivot
Desde el lado de quien llama no hay nada que activar: la definición del pivot viaja con un OpenODS y un SaveAsODS ordinarios. Las hojas se numeran desde 1, y ambos métodos devuelven 1 en caso de éxito:
uses
  System.SysUtils, lxHandleX;

procedure EditPivotSource(const InFile, OutFile: string);
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS(InFile) <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InFile]);
    // E2 está dentro del rango fuente del pivot Sheet1.A2:E30
    Book.Sheets[1].Cells[2, 5].Value := 1250.0;
    if Book.SaveAsODS(OutFile) <> 1 then
      raise Exception.CreateFmt('Cannot save %s', [OutFile]);
  finally
    Book.Free;
  end;
end;
En el content.xml guardado, la colección de pivots vive dentro de <office:spreadsheet> justo después de <table:named-expressions> que el writer genera y antes de <table:database-ranges>. Un workbook que trae tanto un AutoFilter, que HotXLS escribe como database range, como un pivot pone los dos elementos uno junto al otro, y si su pipeline corre un validador de esquema ODF estricto, ese par es el primer lugar donde mirar
La edición del ejemplo cambia un valor fuente y deja las celdas de resultado del pivot como estaban. Una definición capturada se reproduce tal como fue escrita: HotXLS no la recalcula, y la aplicación de hojas de cálculo que abre el archivo recalcula el pivot en su próximo refresh. Lo mismo aplica a sus direcciones. Renombre Sheet1 o mueva el bloque fuente, y la definición guardada seguirá apuntando a Sheet1.A2:E30, lo que la aplicación consumidora reporta como rango roto al refrescar. Mantenga estables los nombres de hoja y el bloque fuente en cualquier workbook cuyos pivots viajen así
¿Qué ruta tomó un pivot dado?
La comprobación más rápida es la lista PivotTables de la hoja: una definición traducida aparece ahí como un TXLSPivotTable, y una capturada no. El reporte de conversión responde la otra mitad de la pregunta, qué pasaría con el pivot en un formato de salida distinto. GetConversionReport inspecciona el workbook sin guardarlo ni recalcularlo, y quien llama es dueño del reporte devuelto:
uses
  System.SysUtils, lxHandleX, lxDiagnostics;

function DescribeOdsPivots(Book: TXLSXWorkbook): string;
var
  I, Modeled: Integer;
  Report: TXLSConversionReport;
begin
  Modeled := 0;
  for I := 1 to Book.Sheets.Count do          // Sheets es 1-based
    Inc(Modeled, Book.Sheets[I].PivotTables.Count);

  Report := Book.GetConversionReport(xlsConversionOpenXmlWorkbook);
  try
    for I := 0 to Report.Count - 1 do
      if (Report[I].Feature = 'OpenDocumentPivotTables') and
         (Report[I].Fidelity = xlsConversionDropped) then
        Exit('Captured ODF pivot XML: keep this workbook on .ods');
  finally
    Report.Free;
  end;

  if Modeled > 0 then
    Result := Format('%d pivot table(s) in the pivot model', [Modeled])
  else
    Result := 'No pivot definitions';
end;
La ruta de salida importa porque el XML capturado es vocabulario ODF y solo el writer ODS lo emite. Guardado como .xlsx, la colección capturada no tiene contraparte en SpreadsheetML, y el reporte la lista bajo OpenDocumentPivotTables con xlsConversionDropped. El writer binario .xlsb rechaza un workbook que todavía la trae. Un pivot traducido es un objeto ordinario del modelo y sigue las reglas del formato de destino. Las diferencias entre las rutas de importación y exportación ODS aplican aquí como en todas partes, y para archivos con pivots la ruta segura es .ods adentro, .ods afuera
Una regla más se sigue del fallback todo o nada. Un workbook reproduce una colección capturada o escribe sus pivots desde el modelo; nunca mezcla ambos en un mismo content.xml. Agregar un pivot con AddPivotTable a un workbook que ya trae XML de pivot capturado hace que el guardado ODS se detenga con un error en lugar de empalmar XML generado junto a XML reproducido
Comprobar la parte guardada con un segundo parser
Un conteo de elementos no prueba nada sobre namespaces. Una expresión regular que encuentra etiquetas de apertura data-pilot-table en el content.xml guardado ve texto, y la copia recortada de la segunda sección pasa esa prueba. Un parser consciente de namespaces que no tenga nada que ver con la biblioteca que escribió el archivo es un juez mucho más estricto, y Delphi ya trae uno. La función de abajo es una comprobación para que la agregue a su propio banco de pruebas; TZipFile y TXMLDocument vienen de la RTL de Delphi, no de HotXLS:
uses
  System.SysUtils, System.Classes, System.Zip,
  Xml.xmldom, Xml.XMLIntf, Xml.XMLDoc;

// Helper de pruebas propio: True cuando el content.xml de un paquete .ods
// carga en un parser DOM consciente de namespaces
function OdsContentParses(const OdsFile: string; out Error: string): Boolean;
var
  Zip: TZipFile;
  Bytes: TBytes;
  Stream: TBytesStream;
  Doc: IXMLDocument;
begin
  Error := '';
  Zip := TZipFile.Create;
  try
    Zip.Open(OdsFile, zmRead);
    Zip.Read('content.xml', Bytes);
  finally
    Zip.Free;
  end;
  Stream := TBytesStream.Create(Bytes);
  try
    Doc := TXMLDocument.Create(nil);
    try
      Doc.LoadFromStream(Stream);     // un prefijo sin enlace falla aquí
      Result := True;
    except
      on E: EDOMParseError do
      begin
        Error := E.Message;
        Result := False;
      end;
    end;
  finally
    Stream.Free;
  end;
end;
Ejecútelo en cada .ods que su código guarde, y luego vaya un paso más allá con los archivos que traen pivots: compare el subárbol del pivot de la entrada y de la salida después de parsear, con etiqueta, atributos ordenados, texto e hijos, recursivamente, con nombres expandidos a URI de namespace más nombre local. Esa comparación deja pasar un prefijo reescrito y atrapa uno sin enlace, que es exactamente la línea entre inofensivo y roto. Aliméntelo con archivos de cada productor que sus usuarios realmente usen. Un documento que enlaza el namespace table a un prefijo distinto, declara un prefijo en el propio elemento pivot o reenlaza uno en <office:spreadsheet> ejercita las reglas de salto y sombreado de una forma en que un solo archivo de LibreOffice no lo hace
El lector y writer ODS, el modelo de pivots para XLSX y ODS, y el reporte de conversión usado arriba son parte del HotXLS Delphi Excel Component; su página de producto cubre el soporte completo de lectura y escritura XLSX, XLS y ODS para Delphi y C++Builder