Excel muestra "We found a problem with some content" sobre un XLSX que LibreOffice y cualquier lector casero abren sin quejarse, porque Excel exige dos cosas que esos lectores ignoran: los atributos que el esquema marca obligatorios y las reglas de unicidad de las Open Packaging Conventions. Tres de esas reglas son fáciles de romper en cualquier writer que combine partes generadas con partes preservadas: un <phoneticPr> necesita su fontId, cada nombre de parte lleva exactamente un Override en [Content_Types].xml, y dos relaciones raíz jamás deben compartir un identificador como rId4. Este artículo recorre cada una y cómo HotXLS, el componente nativo de hojas de cálculo de Excel para Delphi y C++Builder, escribe el paquete para satisfacerla
¿Por qué Excel rechaza un paquete que todos los demás lectores aceptan?
Porque el aviso de reparación es un validador de esquema y de paquete, no un fallo de parseo. Un libro puede hacer round-trip a través de su propia librería, de LibreOffice y de los validadores XML, y ser estructuralmente sano en el sentido OPC que usa el artículo sobre resolución de relaciones OPC de XLSX: cada parte alcanzable, cada target resoluble. Ábralo vía Workbooks.Open en una instancia COM aislada con DisplayAlerts apagado y la llamada igual puede fallar de plano. Interactivamente el mismo archivo produce el conocido diálogo de ofrecer reparar, y el log de reparación, cuando Excel se molesta en escribirlo, nombra la parte pero no la regla. Varias violaciones independientes pueden esconderse detrás de ese único aviso, y Excel no las reporta de a una; rechaza el libro y lo deja a uno buscándolas y analizándolas. Lo que sigue es cada regla, la forma natural de violarla, y cómo escribe el paquete HotXLS en su lugar, porque cada una es una regla con la que cualquier writer de XLSX en Delphi puede tropezar
Regla 1: el fontId de phoneticPr es obligatorio, incluso cuando es cero
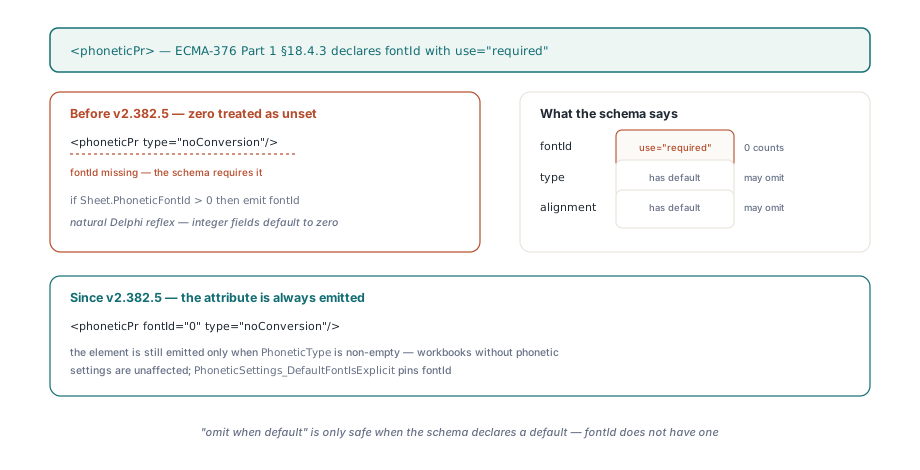
El elemento <phoneticPr> lleva un atributo fontId declarado use="required" en ECMA-376 Part 1 §18.4.3, y un valor de 0 es un índice de fuente legal, no una ausencia. Un writer que trata el cero como "sin definir" y solo emite el atributo cuando Sheet.PhoneticFontId > 0 sigue un reflejo natural de Delphi, dado que los campos enteros arrancan en cero, pero produce <phoneticPr type="noConversion"/> para cualquier libro cuya fuente fonética resulte ser la primera fuente de styles.xml, algo fácil de encontrar porque el índice 0 es simplemente la primera fuente. Excel entonces rechaza, a la vuelta, un valor que él mismo escribió
// El reflejo natural: cero tratado como sin definir, fontId descartado
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, writer de hoja — el atributo es obligatorio, cero incluido
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS sigue emitiendo el elemento solo cuando TXLSXWorksheet.PhoneticType no está vacío, así que los libros que nunca llevaron ajustes fonéticos no se ven afectados. Ponga PhoneticFontId en cero sobre una hoja nueva, guarde, y xl/worksheets/sheet1.xml llevará <phoneticPr fontId="0". La lección más amplia es que "omitir cuando es el default" solo es seguro cuando el esquema declara un default; type y alignment tienen defaults en ese elemento, fontId no
Regla 2: un Override por nombre de parte en [Content_Types].xml
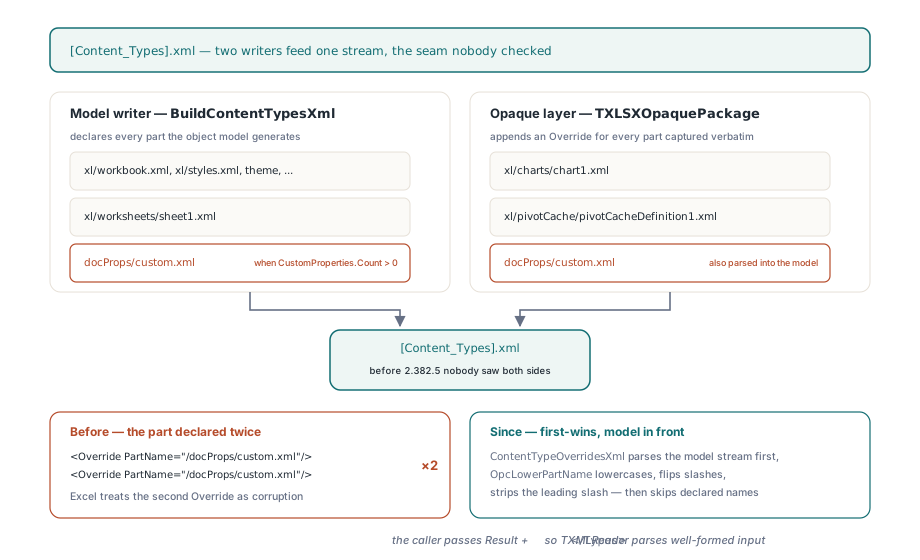
El stream de content types puede declarar cada nombre de parte como máximo una vez, y Excel trata un segundo Override para el mismo PartName como corrupción aunque ambas entradas lleven el mismo ContentType. HotXLS tiene dos writers alimentando ese stream. BuildContentTypesXml declara cada parte que el modelo de objetos genera: workbook, styles, shared strings, theme, worksheets, y, cuando TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Cuando PreserveUnsupportedParts está activado, TXLSXOpaquePackage después agrega un Override por cada parte que capturó textualmente del paquete fuente, para que esos bytes sigan declarados a la salida. La colisión es una parte que vive en ambos lados. Las propiedades personalizadas del documento se parsean al modelo, pero el docProps/custom.xml del paquete fuente también fue capturado de forma opaca, así que un merge ingenuo lo declara dos veces, y las partes de gráficos y de pivot cache pueden caer en el mismo punto cuando el modelo regenera una parte que la capa opaca también retuvo. Un writer opaco sin visibilidad de lo que el modelo ya escribió no puede saberlo, y por eso ContentTypeOverridesXml recibe esa visibilidad
<!-- Lo que produce un merge ingenuo -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS le pasa el XML generado a ContentTypeOverridesXml y deja que el writer opaco lo parsee antes de emitir nada. Dos detalles cargan con la corrección. OpcLowerPartName pasa a minúsculas, voltea backslashes a slashes y quita los slashes iniciales antes de comparar, porque los nombres de parte OPC se comparan sin distinguir mayúsculas y el modelo los escribe con slash inicial mientras la capa opaca guarda los nombres de ítems ZIP sin él. Y el llamador en BuildContentTypesXml pasa Result + '</Types>', cerrando el documento parcialmente construido para que TXMLReader vea entrada bien formada en vez de un stream truncado. La regla que emerge es gana-el-primero con el modelo adelante: lo que el modelo de objetos declara es autoritativo, y el replay opaco solo llena huecos
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Parsea el stream generado por el modelo y colecta cada PartName declarado.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // ya declarado, o una parte rels
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Regla 3: los Id de relación son únicos dentro de una parte de relaciones
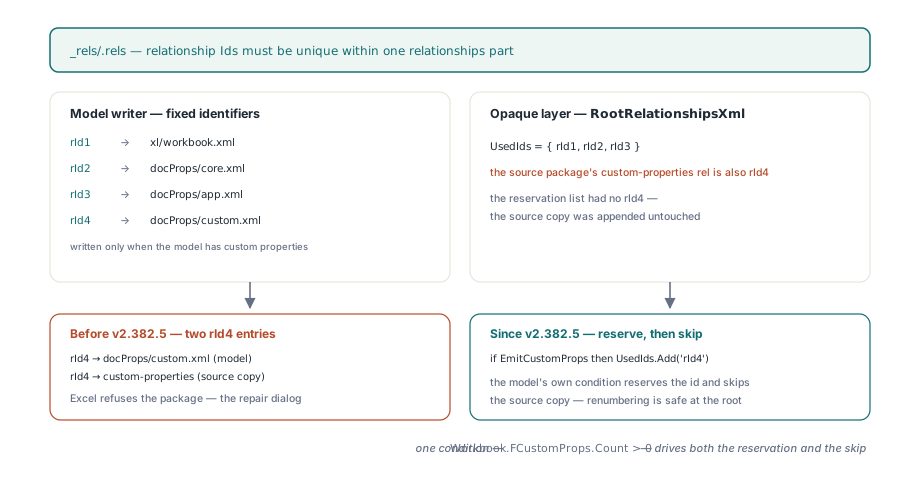
Cada Relationship en una parte .rels necesita un Id único dentro de esa parte, y Excel rechaza el paquete cuando dos comparten uno. HotXLS escribe el _rels/.rels a nivel de paquete con identificadores fijos: rId1 para el workbook, rId2 y rId3 para las propiedades de documento core y extendidas, y rId4 para propiedades personalizadas cuando el modelo tiene. El paquete opaco después agrega las relaciones raíz que retuvo de la fuente, renumerando cualquier identificador que ya esté en una lista UsedIds. Si esa lista solo conoce de rId1 a rId3, y no sabe que el modelo está por emitir su propia relación de propiedades personalizadas, un paquete fuente cuya relación de propiedades personalizadas también es rId4, que es lo que Excel escribe por defecto, sale con dos entradas rId4 apuntando al mismo target. RootRelationshipsXml por eso reserva el rId4 y salta la copia de la fuente siempre que el modelo emite propiedades personalizadas. El llamador, BuildRootRelsXml, pasa Workbook.FCustomProps.Count > 0 como segundo argumento, así que la reserva y el salto se manejan con la misma condición que decide si el modelo emite rId4 o no. Renumerar es seguro en la raíz del paquete porque nada dentro del workbook referencia identificadores de relación raíz por nombre; el mismo truco un nivel abajo estaría mal, donde los atributos r:id de workbook.xml se atan a identificadores de la parte de relaciones del workbook, razón por la cual MergeWorkbookRelationshipsXml mantiene un mapa de identificadores separado
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // reservado por el writer del modelo
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // El modelo es dueño de las propiedades personalizadas; no replique la copia de la fuente.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // el rIdN libre más bajo
  UsedIds.Add(String(Id));
  ...
end;
¿Qué tienen en común las tres reglas?
Las tres resguardan contra un writer con dos fuentes y ningún dueño único de los invariantes del paquete. El modelo de objetos genera las partes que entiende; la capa opaca replica las que no, de modo que un round-trip conserva gráficos, pivot caches, XML personalizado y todo lo demás descrito en las notas sobre el round-trip sin pérdida de theme, extLst y calcChain. Cada lado puede ser consistente por separado. Las restricciones que OPC pone sobre el paquete completo, nombres de parte Override únicos e identificadores de relación únicos por parte, existen solo en la costura donde los dos se concatenan, así que algo tiene que ser dueño de la costura. El bug de fontId tiene la misma forma un nivel abajo: un writer puede saber qué quiere omitir y nunca consultar el esquema que dice que no puede. HotXLS lo resuelve con una precedencia fija en lugar de una heurística de merge. El modelo escribe primero, y la capa opaca ve lo escrito y cede ante cualquier colisión. Los invariantes además son baratos de verificar desde afuera: lea el [Content_Types].xml y cada ítem .rels de un paquete guardado y falle ante cualquier PartName, Extension o Id duplicado. Ese chequeo no necesita Excel y cubre las dos reglas de unicidad; la regla de fontId todavía necesita un validador de esquema
Áreas de impresión que son fórmulas, no rangos
El área de impresión es la otra cosa que Excel compara sobre una copia guardada: una plantilla cuyo _xlnm.Print_Area Excel reporta como $A$1:$J$29 tiene que reportarla idéntica después de un round-trip. Dos trampas se sientan detrás de eso. Al importar, un recorte de prefijo que corta todo hasta el primer ! sin comillas convierte un área de impresión dinámica como OFFSET('Print Data'!$A$1,0,0,2,2) en $A$1,0,0,2,2), y hace que una unión calificada como 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 pierda el prefijo solo en su primer segmento. Al exportar, anteponer el nombre de la hoja una vez al PrintArea almacenado completo le da a una unión simple $A$1:$B$2,$D$1:$E$2 un primer segmento calificado y un segundo desnudo, cosa que Excel no acepta como definición de _xlnm.Print_Area bajo ECMA-376 Part 1 §18.2.5
// Import: quita el prefijo solo cuando lo que queda es un sqref simple
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) se devuelve intacto

// Export: califica cada segmento separado por comas, o ninguno
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // una fórmula: se emite tal cual
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
La regla de emparejamiento es la misma en ambos lados: un área de impresión es un rango desnudo solo si cada segmento parsea como tal, de lo contrario es una fórmula y viaja textual. Con esa regla, la base con nombre, la base calificada con hoja y la unión sobreviven ciclos repetidos de guardar y reabrir. Cómo interactúan las áreas de impresión con el page setup y el resto del modelo de impresión está cubierto en el artículo de protección de hojas, page setup e impresión
¿Cómo encuentra uno la regla a la que Excel se opone?
Parta de la suposición de que su propio validador está mal, porque pasó. El validador del Open XML SDK nombra una violación de esquema como el fontId faltante con la parte y el XPath, y la capa de empaquetado de debajo se niega directamente a abrir un paquete con entradas de content type duplicadas, así que córralo antes que nada. Cuando calla y Excel igualmente repara, haga bisección del paquete: descomprima, borre una parte con su relación y su Override, recomprima y reabra, reduciendo a la mitad el conjunto candidato cada vez hasta que el aviso desaparezca. Las tres violaciones de arriba salen a la luz en ese orden, y ninguna sería visible en el archivo reparado que Excel ofrece guardar, porque la reparación descarta o renumera en silencio las entradas ofensoras. Dos decisiones de diseño del writer de HotXLS valen conocerse. La deduplicación es gana-el-primero con el modelo adelante, así que si el paquete fuente declaraba un content type distinto para una parte que el modelo también genera, gana la declaración del modelo y la de la fuente se descarta, lo que es correcto para las partes que HotXLS regenera y no es un merge general. Y el pase extra de TXMLReader sobre el stream de content types generado corre en cada guardado con PreserveUnsupportedParts activado, un costo pequeño contra un stream que rara vez pasa de unos pocos kilobytes. Con esas reglas en su sitio, una plantilla de préstamos de 4805 fórmulas guardada por los builds Win32 y Win64 abre en Excel sin aviso, recalcula con cero discrepancias, y reporta la misma área de impresión que el original
Si usted mismo escribe XLSX desde Delphi, el checklist es corto: emita cada atributo que el esquema marca obligatorio sin importar su valor, declare cada nombre de parte una sola vez, y mantenga una lista de identificadores usados por parte de relaciones a través de todos los writers que la tocan. Si prefiere que esa lista ya exista y esté probada contra Excel y no solo contra su propio lector, el writer de paquetes descrito acá viaja en el componente de hojas de cálculo Delphi de HotXLS, junto con el round-trip de partes opacas que hizo que la costura valiera la pena custodiar en primer lugar