Un nombre definido que apunta a una columna completa es leído por Excel como una sola celda cuando aparece en posición escalar: =Vertical+1 en la fila 7 significa "la celda de la fila 7 de Vertical", no el área completa. HotXLS Delphi Component aplica esa intersección implícita en v2.382.4 en dos niveles, durante la evaluación y durante la extracción de dependencias, porque una plantilla de préstamos con 4805 fórmulas demostró que acertar con el valor no basta. Cuando el walker de dependencias expande el nombre a su área completa, una fórmula aguas abajo que alimenta cualquier celda de esa área cierra un ciclo que no existe, y TXLSXWorkbook.Recalculate rechaza el libro completo
La plantilla en cuestión es un libro estándar de amortización de préstamos. Con cada valor en caché envenenado a 777 y una corrida completa de Recalculate, las dos arquitecturas del motor devolvían 23, que es lxErrorRef, el código de referencia circular. 3842 de las 4805 fórmulas no coincidían con la expectativa independiente, B18 tenía #VALUE!, E18 seguía en 777, y el conteo de pagos en J7 había leído los placeholders de una columna de saldo sin terminar. Tres defectos separados se escondían detrás de un solo código de retorno, y este artículo recorre cada uno con el código fuente que lo corrigió
¿Por qué una referencia escalar a un nombre de columna crea un ciclo falso?
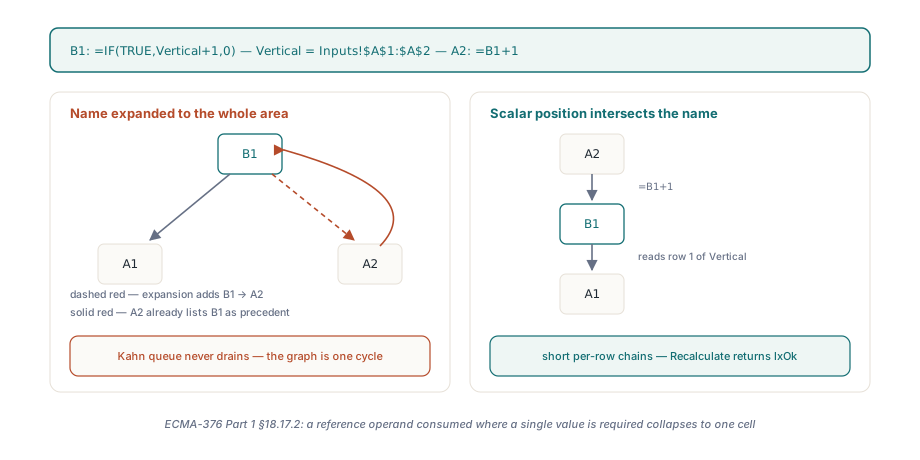
Porque un grafo de dependencias solo conoce aristas, y una arista de una fórmula a un área de 480 filas son 480 aristas, una de las cuales apunta de vuelta por una celda que depende de la fórmula. Considere =IF(TRUE,Vertical+1,0) en B1 con Vertical definido como Inputs!$A$1:$A$2, y =B1+1 en A2. Excel evalúa B1 como A1+1 y A2 como B1+1, una cadena recta. Un walker que registra B1 como dependiente de A1:A2 hace de A2 un precedente de B1, A2 ya lista a B1 como precedente, y la cola de Kahn que impulsa el recálculo incremental en HotXLS nunca ve que ninguno de los dos nodos llegue a grado de entrada cero. Este es el patrón del que están hechas las plantillas de préstamos: cada fila de período referencia columnas con nombre para el saldo, la tasa y el conteo de pagos, cada nombre abarca el cronograma completo, y cada fila además escribe en esas columnas. Expanda los nombres y el grafo es un componente fuertemente conexo gigante. Evalúelos con intersección implícita y el grafo es un conjunto de cadenas cortas, una por fila, que es lo que ECMA-376 Part 1 §18.17.2 describe para un operando de referencia consumido donde se requiere un único valor
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Posición escalar: Vertical colapsa a A1 porque la fórmula está en la fila 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Un nombre cuya definición es otro nombre también se intersecta, así que esto es A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argumento de clase referencia: se suma el área completa, sin intersección
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // La fila 6 está fuera de A1:A2, la intersección es vacía e IFERROR la atrapa
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Antes de v2.382.4 esta rama era inalcanzable: B1 -> A2 -> B1 era un ciclo
    end;
  finally
    Book.Free;
  end;
end;
¿Cómo decide HotXLS que un argumento es escalar?
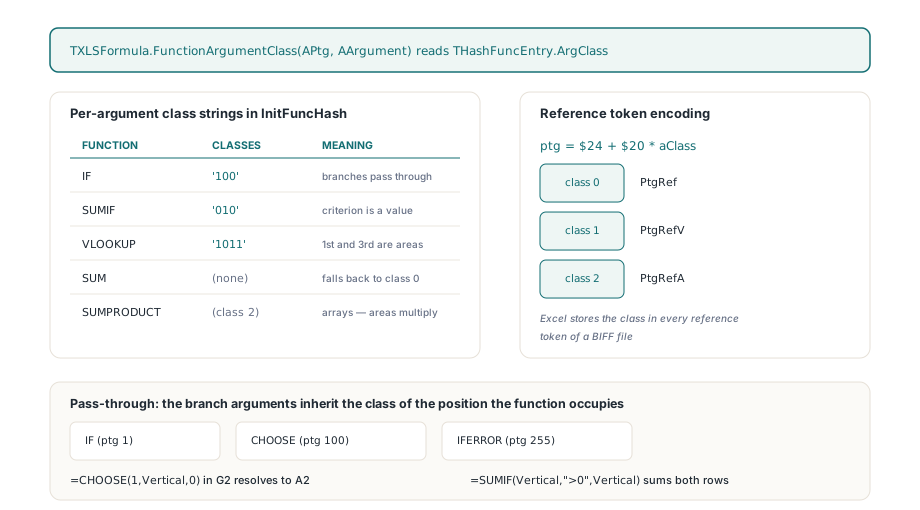
HotXLS lee la respuesta de la tabla de funciones y no de la forma del argumento. Cada entrada de TXLSFormula.InitFuncHash se registra a través de THashFunc.SetValue con una cadena opcional de clases por argumento: 'IF' lleva '100', 'SUMIF' lleva '010', 'VLOOKUP' lleva '1011', y 'SUM' no lleva ninguna, así que todos sus argumentos caen a la clase 0 a nivel de función. El nuevo TXLSFormula.FunctionArgumentClass(APtg, AArgument) expone ese byte vía THashFuncEntry.ArgClass, y un resultado 1 significa clase valor. Estas son las mismas tres clases que [MS-XLS] §2.2.2 asigna a los tokens operando, y el encoder ya dependía de ellas: al escribir una referencia calcula el ptg como $24 + $20 * aClass, lo que produce PtgRef para la clase 0, PtgRefV para la clase 1 y PtgRefA para la clase 2. Un archivo BIFF escrito por Excel guarda esa clase en cada token de referencia, así que un motor cuya tabla coincida con la especificación puede responder "¿este argumento es escalar?" sin mirar los datos. El argumento del medio de SUMIF es el criterio, un valor; el primero y el tercero son áreas, referencias. SUMPRODUCT está registrado con clase 2 a nivel de función, array, y por eso =SUMPRODUCT(Vertical,Vertical) todavía multiplica el área completa
Tres funciones no consultan su propia entrada de tabla para nada más allá del primer argumento. IF (ptg 1), CHOOSE (ptg 100) e IFERROR (ptg 255) dejan pasar lo que seleccionen, así que sus argumentos de rama heredan la clase de la posición que la función misma ocupa. Esa única regla es la que permite que =CHOOSE(1,Vertical,0) en G2 resuelva a A2 mientras =SUMIF(Vertical,">0",Vertical) al lado sigue sumando ambas filas, y es la regla que más ejercita un cronograma de amortización, porque sus celdas de período se apoyan en IF para probar si el préstamo sigue abierto
Llevar la clase a través del recorrido de dependencias
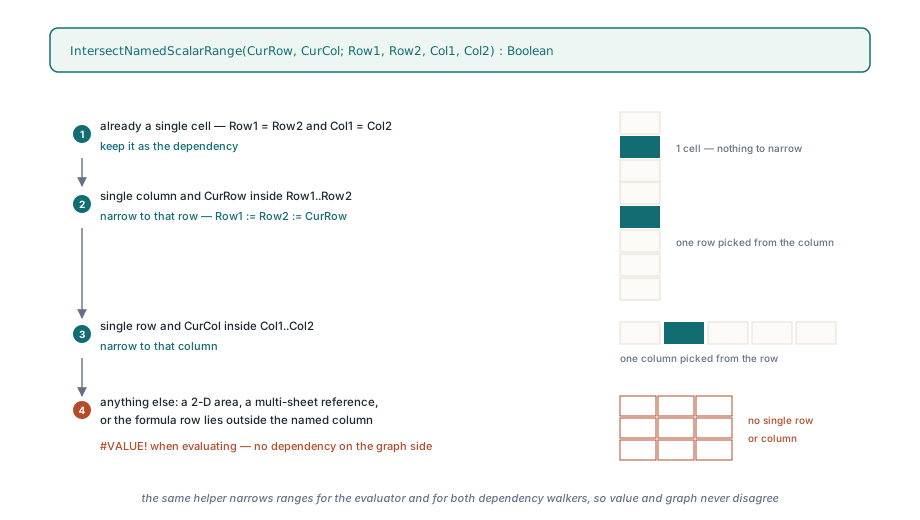
El extractor de dependencias de lxCalc.pas es un Walk recursivo sobre el árbol de sintaxis compilado, y existe dos veces, una en TXLSCalculator.ExtractDependencies para el grafo por libro y otra en ExtractWorkspaceDependencies para el grafo entre libros. v2.382.4 les da a ambos walkers dos parámetros extra. AScalar arranca en True en la raíz de una fórmula, se recalcula para cada hijo función desde FunctionArgumentClass, y se pasa sin cambios para los argumentos de rama de ptg 1, 100 y 255. ANameRoot se vuelve True solo cuando el walker desciende a la definición compilada de un nombre, y sobrevive únicamente a través de nodos SA_GROUP, los paréntesis, así que un nombre definido como =A1:A2+1 no se confunde con un área simple. Cuando ambos flags están en True en un nodo SA_RANGE, AddResolvedRange acota el área con el mismo helper que usa el evaluador antes de registrar la dependencia. El helper es corto como para citarlo completo
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // ya es una celda
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // columna única: toma esta fila
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // fila única: toma esta columna
    Result := True;
  end;
end;
Todo lo que el helper rechace, un área bidimensional, una referencia multi-hoja o una fórmula cuya fila cae fuera de la columna con nombre, produce #VALUE! del lado de la evaluación y ninguna dependencia del lado del grafo, que es lo que Excel hace para una intersección vacía. El lado de la evaluación vive en TXLSCalculator.GetValueItemName: quita los envoltorios SA_GROUP de la definición compilada, y si la raíz es un SA_RANGE llama a GetRangeInfo, intersecta, y busca la única celda vía FGetValue en lugar de evaluar la definición completa. Las referencias externas se quedan en el camino viejo, porque no hay fila local contra la cual intersectar. De dónde salen en primer lugar el almacenamiento y el alcance de un nombre se cubre en el artículo de nombres definidos y fórmulas entre hojas; aquí el punto es solo qué hace el motor una vez que el nombre se resuelve
¿Por qué MATCH sobre una columna a medio calcular leía 777?
Porque el argumento lookup-array de MATCH es una referencia de scan, y las referencias de scan fueron excluidas deliberadamente del orden de evaluación. El artículo del lookup scan presentó TXLSDepRange.LookupScan y cerró con una sección llamada "Lo que se pierde al excluir las aristas de scan del ordenamiento": una fórmula de búsqueda puede correr antes de que cada celda de su rango haya sido recalculada y leer valores viejos. En una sesión interactiva eso converge en el pase siguiente. En un recálculo por lote de una plantilla envenenada no, y PaymentCount, definido como =MATCH(0.01,Balances,-1)+1, leía los placeholders 777 que seguían sentados en la columna de saldo y devolvía un conteo de períodos que no podía estar bien
TXLSDepGraph.TopoOrder ahora trata las aristas de scan como aristas de ordenamiento suaves. Junto al grado de entrada duro mantiene un arreglo ScanInDeg, contando precedentes de scan sucios por nodo y decrementándolo a medida que esos precedentes se emiten, usando las listas ScanPrecedents, ScanDependents y ScanPrecedentCount que el cambio anterior ya almacenaba. En cada iteración la cola de Kahn recorre su ventana de listos buscando el primer nodo cuyo ScanInDeg es cero y lo intercambia a la cabeza; si cada nodo listo sigue esperando un precedente de scan, la cabeza se desapila en su orden estable. Las aristas de scan nunca entran al grado de entrada duro, así que un VLOOKUP autorreferencial sobre su propia columna sigue siendo legal, pero una búsqueda que podía esperar un precedente terminable ahora espera. La regresión que fija esto, LookupScan_WaitsForDirtyFormulaValues, envenena tres celdas de saldo a 777 y espera que PaymentCount vuelva como 3, luego cambia la entrada a cero y espera que =IFERROR(PaymentCount,99) vea el #N/A y devuelva 99
¿De dónde salió el truncado a cuatro decimales?
De la aritmética de Variant de Delphi, y solo en posiciones anidadas. Los operadores binarios de TXLSCalculator.GetValueItem ya copiaban un + o - de nivel superior a dos locales Double, así que =B1-A1 estaba bien. Dentro de =IF(TRUE,B1-A1,0) la misma resta corría como Value := Value - SubValue sobre dos Variant, y cuando un operando era un valor de celda Int64 y el otro un Double, el resultado que observamos era un Currency, un tipo de punto fijo con cuatro decimales, así que 1066.1854641400994 menos 120 volvía truncado a cuatro decimales. A lo largo de un cronograma donde cada pago se capitaliza desde la fila anterior, ese error camina por cientos de períodos antes de llegar a los totales
// TXLSCalculator.GetValueItem, rama de aritmética binaria (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// La aritmética Variant mixta Int64/Double puede promover a Currency.
// La aritmética de hoja de cálculo debe conservar precisión de punto flotante.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
La guarda corre por igual antes de SA_ADD, SA_SUB, SA_MUL y SA_DIV, y la regresión Arithmetic_MixedInt64AndDoubleKeepsPrecision guarda Int64(120) en A1 y 1066.1854641400994 en B1, luego verifica la diferencia y la suma anidadas a 1E-10 y el producto y el cociente a 1E-8 y 1E-12. HotXLS no pretende conocer cada regla de promoción que la RTL aplica a tipos Variant mixtos entre versiones del compilador; pretende que la aritmética de hoja de cálculo es IEEE double, y ahora convierte ambos operandos a double antes de que el operador los vea, lo que elimina la pregunta
Qué garantiza el fix, y qué no
Después de v2.382.4 las dos arquitecturas del motor devuelven lxOk para la plantilla envenenada, los 4805 valores en caché coinciden con la expectativa independiente fila por fila dentro de 1E-7, y las aserciones de que las cachés de verdad estaban envenenadas, de que el hash de la fuente no cambió y de que cada fórmula sigue presente se sostienen todas. No se activó iteración ni se suprimió ningún código de error para llegar ahí. Un ciclo genuino a través de un nombre, =B1 en A1 con B1 todavía leyendo Vertical, sigue devolviendo un error, y el test NamedScalarRanges_IntersectWithoutFalseCycles termina afirmando exactamente eso
Vale la pena enunciar los límites sin rodeos. La intersección implícita aplica solo a un nombre cuya definición compilada, tras quitar paréntesis, es un área de columna única o de fila única en una hoja; un nombre bidimensional en posición escalar es #VALUE!, como en Excel, y una función que la tabla no conoce recibe clase 0 de FunctionArgumentClass, así que sus argumentos de nombre se siguen expandiendo completos. El ordenamiento suave es una preferencia, no una garantía: un ciclo solo de scan sigue evaluando en orden estable y lee lo que haya en caché, que es el comportamiento que el artículo del lookup scan aceptó a propósito. Y el resultado de la plantilla completa se verifica contra un script independiente de expectativas, no contra otro motor de hojas de cálculo, porque la suite de oficina de referencia no terminó de recalcular la plantilla original dentro de un presupuesto de 60 segundos. HotXLS es un componente de hojas de cálculo nativo para Delphi y C++Builder que lee, recalcula y escribe XLS, XLSX, ODS y CSV sin Excel instalado; la intersección de nombres, la tabla de clases de argumento y el ordenamiento de scan suave aplican a todos los formatos porque el motor de cálculo es compartido, y la cobertura actual de funciones está listada en la página del producto HotXLS Delphi spreadsheet component