"value":-.25 es lo que produce un escritor de JSON cuando copia un token de número PDF perfectamente legal tal cual, y un parser estricto de RFC 8259 se rinde justo después del signo menos. Sus vecinos +1.5 y 007.5 del mismo arreglo PDF fallan igual. Convertir números PDF a JSON significa re-deletrear cada token dígito por dígito, escribir null para NaN e Infinity, y mantener fuera de la salida la coma decimal regional
Cuatro grafías que PDF acepta y JSON rechaza
Las dos gramáticas discrepan en cuatro detalles pequeños. ISO 32000-1 §7.3.3 deja que un número empiece con signo más, omita la parte entera (.5), termine en un punto desnudo (4.) y traiga ceros a la izquierda (007.5). RFC 8259 §6 no permite nada de eso. Un número JSON tiene un menos opcional, una parte entera que es 0 o empieza con un dígito del 1 al 9, y al menos un dígito después de cualquier punto decimal. Los productores tienen derecho a las formas PDF, y los generadores que imprimen números con su propio código de formato, junto con archivos que alguien arregló a mano en un editor de texto, las usan
La colisión se agudiza en una biblioteca que respeta el texto fuente. PDF Library for Delphi (PDFlibPas) conserva los caracteres exactos que parseó para cada número real, así que un valor de color calibrado se guarda de vuelta sin cambios en vez de redondearse a los cuatro decimales por omisión; el razonamiento está en preservar la precisión decimal parseada de PDF. El tokenizer ya remienda .5 a 0.5 y 4. a 4.0 mientras lee, y los enteros se reconstruyen desde su valor, así que +3 vuelve como 3. Tres grafías todavía llegan verbatim al escritor: un punto con signo a la izquierda (-.25), un más explícito en un real (+1.5) y ceros a la izquierda (007.5)
Un escritor que pega esos caracteres guardados directo al JSON produce un archivo que se ve bien en un editor. El problema empieza en el camino de vuelta. SetObjectJSON devuelve 0, y LastErrorCode reporta PDFLIB_ERROR_OBJECT_JSON_INVALID, que es 105
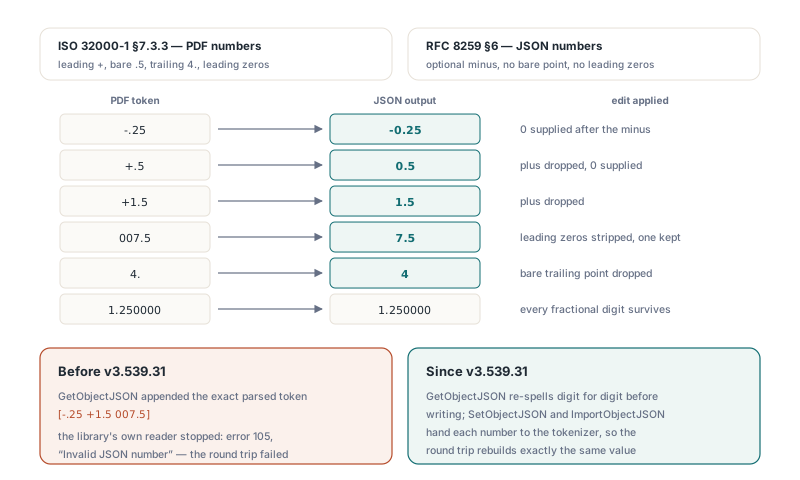
El round trip de abajo es la manera más rápida de ver lo que GetObjectJSON emite realmente. Cada número llega envuelto como {"type":"number","value":...}, y los tres tokens incómodos salen como -0.25, 1.5 y 7.5
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // El objeto 12 es un arreglo escrito como [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    if JSON = '' then
      raise Exception.CreateFmt('export failed, error %d',
        [Lib.LastErrorCode]);
    // Cada elemento se lee {"type":"number","value":-0.25} y así sucesivamente

    // SetObjectJSON devuelve 1 si tiene éxito; pase 0 para Options
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
Re-deletrear el token en vez de recomputarlo
GetObjectJSON edita los caracteres guardados en vez de formatear el Double parseado. Lee un signo opcional, junta los dígitos a ambos lados de un único punto decimal, y luego hace solo los cambios que el JSON insiste: el más se va, los ceros a la izquierda se recortan hasta uno, una parte entera vacía se vuelve 0, un punto final desnudo se descarta, y un menos se vuelve a poner delante. Un token que contiene cualquier otro carácter, o ningún dígito, se formatea desde su valor parseado con diez decimales, y esa ruta escribe null cuando el valor no es finito
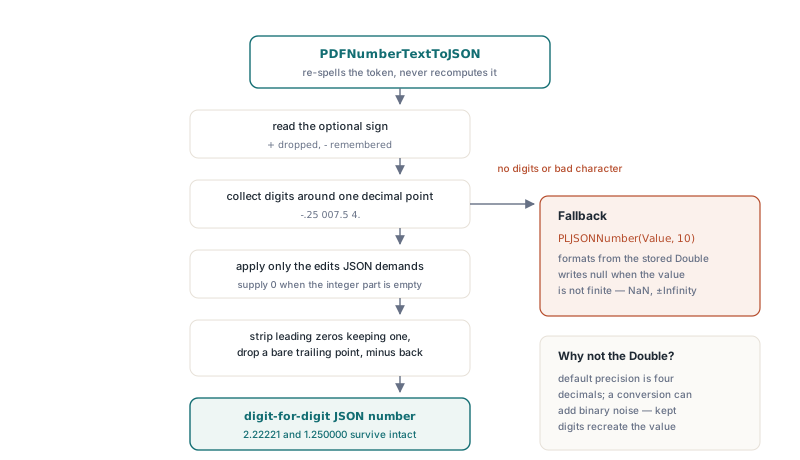
-.25se vuelve-0.25, y+.5se vuelve0.5+1.5se vuelve1.5007.5se vuelve7.5, mientras que0.75se queda como está4.se vuelve4si un token así llega alguna vez al escritor2.22221y1.250000conservan cada dígito fraccionario, ceros finales incluidos
Formatear desde el Double habría sido una sola línea, y habría estado mal de dos maneras. La precisión de salida por omisión del documento es de cuatro decimales, así que 2.22221 perdería un dígito. Subir la precisión tampoco lo rescata: 0.1 no tiene forma binaria exacta, y una conversión de 17 dígitos significativos imprime 0.10000000000000001. Conservar los dígitos originales significa que SetObjectJSON e ImportObjectJSON, que le entregan cada número JSON de vuelta al tokenizer de PDF, reconstruyen exactamente el valor que el archivo declaró
Esa promesa cubre el valor. Los bytes son otro asunto. Después de una reimportación, -.25 se guarda y salva como -0.25; ambas grafías son iguales bajo §7.3.3, pero un diff a nivel de bytes señala el cambio. Sobre un documento cuyos rangos de bytes están cubiertos por una firma, nosotros no pasaríamos objetos por un ciclo de exportación e importación en absoluto salvo que el plan sea firmar otra vez después
¿Qué significa null en la salida de GetDocumentJSON?
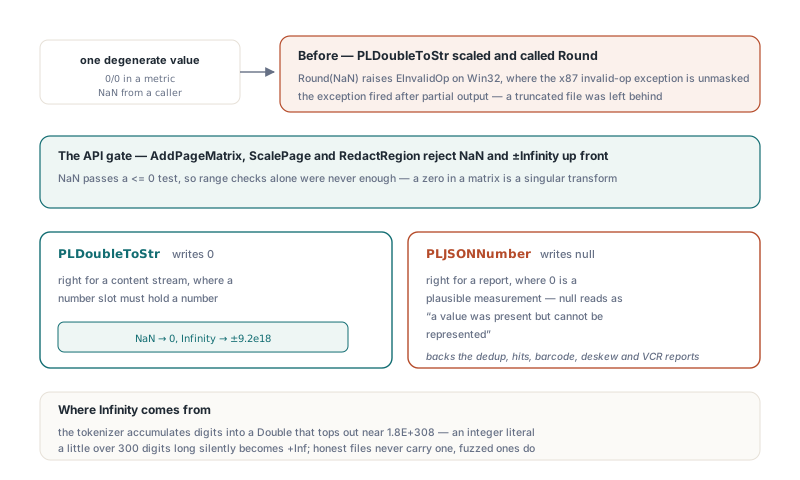
GetDocumentJSON escribe null para cualquier número que sea NaN o infinito, porque RFC 8259 §6 no tiene sintaxis para ninguno de los dos. Infinity es más fácil de producir de lo que suena. El tokenizer de PDF acumula dígitos por multiplicación repetida en un Double, que llega a su tope cerca de 1.8 × 10308, así que un literal entero de un poco más de 300 dígitos se convierte en +Inf durante el parsing. Los productores corrientes nunca escriben tal literal; los archivos fuzzed y hostiles sí, razón por la cual un entero de 400 dígitos pertenece al mismo corpus de pruebas que los casos de endurecer un parser PDF en Pascal contra archivos maliciosos
La comprobación de finitud tiene que ir primero. GetDocumentJSON imprime los valores integrales por debajo de MaxInt como enteros y todo lo demás con el Str(D:0:6) de Pascal, que va bien para 1.25 y es fatal para +Inf, porque Str entonces escribe el texto +Inf y ningún consumidor de JSON parseará eso. El formato de seis decimales también marca para qué es el JSON del documento. Es una vista general del archivo completo. Cuando usted necesita los dígitos exactos de un objeto, pídale GetObjectJSON a ese objeto
El null es deliberadamente con pérdida, y comparte su grafía con otra cosa. Un objeto null de PDF también sale como null en el JSON del documento, así que un consumidor no puede distinguir "el archivo dijo null" de "el archivo dijo un número demasiado grande para un Double" mirando ese valor. GetObjectJSON los mantiene separados: el objeto null de PDF se escribe como {"type":"null"}, y un número conserva su envoltorio "type":"number". El código que lee el JSON del documento debería aceptar null dondequiera que pueda aparecer un número, registrar el número de objeto, y tratar el archivo como sospechoso en vez de sustituir 0
¿Por qué un solo NaN puede abortar una exportación SVG o JSON?
Un formateador de números que escala su entrada y llama a Round golpea Round(NaN), y en Win32, donde Delphi deja la excepción de operación inválida del x87 sin máscara, eso lanza EInvalidOp. La excepción se dispara después de que el escritor ya emitió parte de su salida. Una medición degenerada, un 0/0 dentro de una métrica o un NaN pasado por quien llama, deja un archivo truncado en el disco
PLDoubleToStr en PDFlibExtra, el formateador invariante que la biblioteca usa para content streams, SVG, XML, CSV y la mayor parte de su JSON, devuelve 0 para NaN. Su rama entera acota el valor escalado a ±9.2 × 10¹⁸ igual que la rama fraccionaria, así que Infinity también sale como un literal finito. En un content stream es la llamada correcta. Un slot de operando debe sostener un número, y un visor que se encuentra +Inf en medio de una trayectoria no tiene nada sensato que dibujar
En un reporte, cero es la llamada equivocada, y lo sentimos con firmeza en este: 0 es un ángulo de deskew o un error de pixel perfectamente plausible, así que escribirlo para "sin respuesta" corrompe los datos sin que nadie lo note. Los escritores de reportes usan PLJSONNumber(Value, Decimals) de la misma unidad en su lugar, que escribe null para NaN o Infinity y dígitos invariantes en los demás casos. GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON y los reportes de barcode, deskew, texto estructurado y PDF/VCR pasan todos por ahí, así que un ángulo de deskew no finito llega al consumidor como null
La misma función es pública, así que su propio JSON junto al de la biblioteca puede seguir la misma regla. El bosquejo de abajo construye un pequeño registro de skew; la forma del registro es nuestra, la llamada de formato es de la biblioteca
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

// Su propio escritor de reportes, usando la regla de números de la biblioteca
function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Convierta cada Double a texto primero; PLJSONNumber escribe null
    // para NaN o Infinity y siempre usa punto decimal
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Nunca B.Append(Angle): en Delphi esa sobrecarga sigue el locale del usuario
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
Dónde se cuela el locale del usuario en el JSON
Cualquier formateador que consulte los ajustes regionales puede poner una coma donde el JSON necesita un punto. PLFloatToStr en PDFlibExtra es una envoltura delgada sobre FloatToStr, y es exactamente lo que hace. Escriba un campo como maxAcceptedMeanError con ella en un escritorio alemán o francés y obtiene "maxAcceptedMeanError":1,5. Un parser de JSON lee eso como el valor 1 seguido de un token suelto. Ese campo reporta el peor error de pixel aceptado de la deduplicación de imágenes perceptual, y GetSimilarImageDeduplicationReportJSON lo escribe vía PLJSONNumber(Stats.MaxAcceptedMeanError, 6), así que el separador se queda siendo punto sin importar cómo esté configurada la máquina
La segunda ruta es más silenciosa. En Delphi, PLStringBuilder es un alias simple de System.SysUtils.TStringBuilder, cuya sobrecarga Append(Double) formatea a través del locale del usuario. Los builds de Free Pascal usan en su lugar una pequeña clase de constructor Unicode de PDFlibTypes, porque el TStringBuilder propio del runtime de FPC es solo ANSI. Compile la misma fuente con ambos y el build de Delphi puede discrepar con el build de FPC. Una prueba que corre solo en Free Pascal, o solo en una máquina en-US, no verá la coma
La prueba de abajo reproduce un escritorio con coma dentro del proceso y le entrega el reporte a un parser estricto. Escoja una entrada que realmente contenga imágenes casi duplicadas; sin coincidencias el error medio es 0, y un valor sin parte fraccionaria esconde el problema del separador
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Haga que este proceso se comporte como un escritorio alemán o francés
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('scanned-batch.pdf', '') = 0 then
      raise Exception.Create('load failed');
    // Dry run con umbrales 2, 2, 4: el documento no se modifica
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    // Esta comprobación de nil se la toca agregar a usted, no forma parte de la biblioteca
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
Tres entradas que vale mantener en la suite de pruebas
El manejo de números en JSON es barato de romper y barato de guardar. Una página que traiga -.25, +1.5 y 007.5 cubre la brecha de gramática; verifique que la salida de GetObjectJSON parsea y que SetObjectJSON devuelve 1. Un objeto que sostenga un entero de 400 dígitos cubre el overflow; el JSON del documento debería mostrar null en esa posición. Un reporte producido con DecimalSeparator fijado a coma cubre el locale. Corra cada uno por un parser estricto en vez de leer la salida a ojo, porque 1,5 y 1.5 son fáciles de perder en una línea larga de JSON
El JSON de objetos, el JSON de documentos y los reportes de análisis comparten estas reglas de números en los builds de Delphi, C++Builder y Free Pascal. La página del producto PDF Library for Delphi lista las ediciones y el resto de la API de nivel de objeto y de reportes