Tome un archivo cuyo diccionario de información dice /Title (Annual Maintenance Report) mientras su packet XMP no tiene ningún dc:title. Los visores muestran el título sin queja, y sin embargo un validador PDF/A rechaza el archivo porque las dos copias de metadatos discrepan. Un segundo archivo se ve igual de sano pero no tiene ninguna entrada pdfaid:part en su XMP, y el validador responde con docenas de errores: juzga el archivo como un PDF ordinario y reporta cada regla de la parte reclamada como fallida, todo por una línea faltante
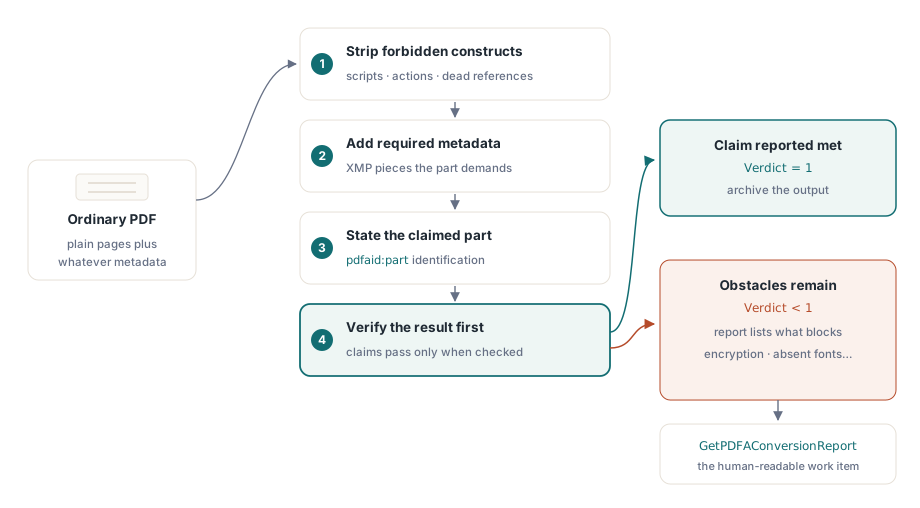
Los dos problemas necesitan cantidades de trabajo muy distintas. Reconciliar metadatos es un arreglo acotado que usted puede correr sobre cualquier archivo. Convertir un PDF arbitrario en uno de archivo significa quitar lo que la parte objetivo prohíbe, agregar lo que exige, declarar la afirmación, y luego validar los bytes que de verdad salieron. Construimos la conversión alrededor de ese último paso a propósito. ConvertToPDFA, que viene con la edición Enterprise (TPDFlibEnterprise) junto con GetPDFAConversionReport, guarda el documento convertido en memoria, corre la verificación PDF/A sobre esos bytes y devuelve 1 solo cuando esa verificación pasa
¿Por qué un PDF que abre bien falla una verificación PDF/A?
Ambos fallos vienen de reglas de metadatos. Un PDF registra su título, autor, productor y fechas en el diccionario de información del documento, y PDF/A también exige los mismos datos en un packet de metadatos XMP; ISO 19005-1 §6.7.3 pide que los dos sean equivalentes, y PDF/A-2 y PDF/A-3 conservan la regla. Entre los archivos que fallan por esta regla, el patrón usual es un productor que llenó el diccionario de información y jamás escribió la mitad XMP, así que el validador encuentra un título en un lugar y nada en el otro
La identificación faltante es más silenciosa. Las entradas pdfaid:part y pdfaid:conformance son lo que marca un archivo como PDF/A, y un archivo puede estar perfectamente bien formado sin ellas. El caso que más vemos es una aplicación que suministra su propio packet XMP, reemplazando el que el escritor de PDF generó; el packet personalizado carga los campos de la aplicación y ninguna entrada pdfaid, así que la lista de errores no apunta ni cerca de la causa real
RepairDocumentMetadata maneja ambos casos y devuelve el número de entradas que cambió. Está disponible en todas las ediciones, igual que SetPDFAMode y SanitizeDocument. La reparación recorre Title, Author, Subject, Keywords, Creator, Producer, CreationDate y ModDate. Donde solo el XMP carga un valor, el diccionario de información se llena a partir de él, así que nada de lo ya registrado se tira. Donde ambos cargan valores y difieren, el diccionario de información gana. Tomamos esa decisión porque el diccionario de información es la mitad que los productores más comúnmente fijan, lo que lo hace el registro más probable de lo que el autor quiso
Si su XMP es la copia autoritativa (digamos que fue curada en un sistema de gestión documental), empuje los valores que quiere al diccionario de información con SetInformation y solo después corra la reparación. Hacerlo al revés sobrescribirá su título XMP curado con lo que sea que el productor original escribió
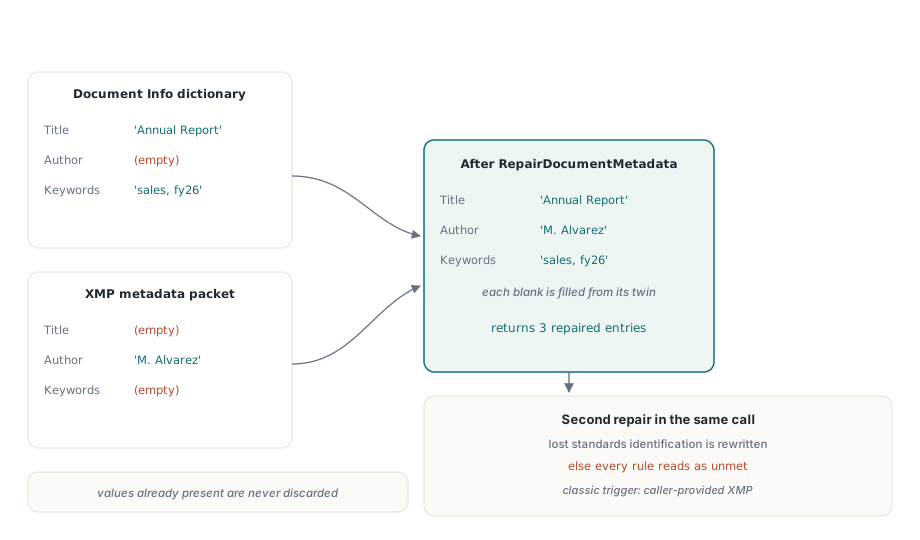
La reparación de identificación necesita una cosa de usted: el documento tiene que saber a qué parte apunta. Un archivo recién cargado no tiene ningún modo PDF/A fijado, así que llame SetPDFAMode antes de la reparación. Con un modo en su lugar, RepairDocumentMetadata escribe las entradas pdfaid correspondientes, agrega pdfaid:rev con el año 2020 para los modos de la parte 4, y fija dc:format a application/pdf, que los validadores también revisan
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // El título curado entra primero al diccionario de información,
    // porque esa copia gana cuando las dos mitades discrepan
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, vea la tabla de abajo
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Elegir la parte objetivo y su número de modo
Escoja la parte según lo que el documento tiene que cargar, y solo después busque el número. SetPDFAMode y ConvertToPDFA comparten un esquema de numeración, y no corre en el orden que los nombres de las partes sugieren
| Modo | Parte y nivel | Notas |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, etiquetado |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, etiquetado |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | Archivos incrustados de cualquier tipo permitidos |
| 8 | PDF/A-2u | PDF 1.7, texto Unicode requerido |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0; 4e agrega 3D y rich media, 4f permite archivos incrustados |
El modo 3 es PDF/A-2b y el modo 4 es PDF/A-2a. Esa inversión atrapa a la gente que cuenta desde 1a hacia arriba y asume que el nivel a siempre va primero. PDF/A-2u aparece en el 8, después de los modos de la parte 3
La elección con consecuencias reales va sobre los adjuntos. Las partes 1 y 2 prohíben archivos incrustados, así que ConvertToPDFA los elimina para los modos 1 a 4 y el modo 8. Convierta una factura Factur-X o ZUGFeRD al modo 3 y el XML estructurado de la factura desaparece de la salida, junto con la razón de existencia del archivo. Para cualquier cosa que cargue un adjunto, apunte al modo 5 (PDF/A-3b), que además es la parte sobre la que se definen esos formatos de factura, o al modo 11 si necesita PDF 2.0. Cada adjunto en un archivo de parte 3 o parte 4 debe declarar cómo se relaciona con el documento a través de /AFRelationship, y PDF Library for Delphi escribe esa entrada para cada archivo incrustado que guarda en esos modos
La parte 4 se identifica de forma distinta. No tiene letra de conformidad para el PDF/A-4 simple, usa E o F para las dos extensiones, y exige pdfaid:rev con el año en que su parte se publicó. ConvertToPDFA sube el archivo a PDF 2.0 para los modos 9 a 11, porque ISO 19005-4 §6.1.2 construye la parte sobre PDF 2.0, y la verificación juzga tales archivos contra PDF 2.0 en lugar de 1.7
Qué cambia ConvertToPDFA en el archivo
ConvertToPDFA hace una secuencia fija de reparaciones, anota cada una en un reporte de texto plano, guarda el resultado en memoria y valida esos bytes. Una verificación fallida devuelve 0, y también lo hace un modo fuera de 1 a 11, que devuelve antes de escribir cualquier reporte. La secuencia vale la pena conocerla, porque cada paso es algo que la salida perderá o ganará:
- Un documento cifrado cuya contraseña se desconoce detiene la conversión de inmediato con una línea
blocked:; nada dentro de él se puede leer, mucho menos reparar - El JavaScript a nivel de documento y la open action que lo corre se eliminan, junto con cada entrada de additional-actions y los tipos de acción que ninguna parte permite, entre ellos Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition y Trans. Los enlaces GoTo y URI se quedan, así que la navegación sigue funcionando
- Los archivos incrustados se eliminan para las partes que los prohíben, como se describió arriba
- Las anotaciones ocultas o puestas para nunca mostrarse se borran. PDF/A exige que las anotaciones sean visibles e imprimibles, y revelarlas cambiaría el aspecto de la página, así que escogimos la eliminación
- Las apariencias de los campos de formulario se regeneran antes de limpiar el flag
/NeedAppearances, así que los valores rellenados siguen visibles - Las fuentes que se usan pero no están incrustadas se incrustan desde las fuentes instaladas en la máquina
- Los objetos a los que ya nada referencia se sueltan, y se agrega un output intent sRGB si el archivo no tiene ninguno
- Finalmente la parte y el nivel se declaran en el XMP, y los bytes se verifican
En un servidor, el paso de fuentes es el más propenso a trabar una conversión. Un documento que usa una fuente que no existe en ninguna parte del host de conversión no puede repararse desde dentro del archivo, y el reporte lo dirá. Instale en la máquina de conversión las fuentes que sus documentos de verdad usan; el recorrido sobre incrustar fuentes faltantes en un PDF existente cubre ese paso por separado
¿Cómo debe un trabajo por lotes manejar una conversión que falla?
Trate el valor de retorno como una compuerta y el reporte como la orden de trabajo. Archive los archivos que devuelven 1, y mande el resto a una persona con el reporte adjunto. No guarde la salida de una conversión fallida en el archivo solo porque se ve más limpia que la entrada. Ese archivo ahora carga una afirmación PDF/A que la verificación se negó a confirmar, que es exactamente la situación que el paso de verificación existe para prevenir
El reporte de GetPDFAConversionReport es una línea por acción, cada una empezando con un verbo: removed:, regenerated:, repaired:, embedded:, added:, stated:, más blocked: si algo detuvo la corrida, y una línea final result:. La verificación detrás del veredicto se detiene en el primer fallo, así que cuando un archivo falla, la conversión corre la verificación otra vez completa y el reporte muestra cada problema de una vez. Enrutar por los prefijos toma unas pocas líneas
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, conserva los adjuntos
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Deje el original intacto; solo el reporte viaja con él
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Una línea blocked: normalmente significa que el arreglo está fuera del PDF: una contraseña, un archivo fuente distinto, o una re-corrida de lo que sea que produjo el documento. Los problemas de validación simples después de una conversión completa suelen ser contenido que carga significado y no puede simplemente borrarse, y esos son los casos donde una persona tiene que decidir
Leer la marca PDF/A que un archivo ya carga
Antes de convertir, revise lo que el documento ya afirma de sí mismo. Los archivos que llegan de escáneres, suites de oficina y otras herramientas de PDF a menudo cargan una marca PDF/A ya, y reconvertir un PDF/A-3 válido a la parte 2 le costaría sus adjuntos para nada
La trampa es que XMP permite escribir la misma propiedad de dos formas. Algunos productores escriben la parte como elemento hijo, <pdfaid:part>2</pdfaid:part>; otros la escriben como atributo sobre rdf:Description, pdfaid:part="2". Ambas son XMP ordinario y válido. Un detector que busca solo una forma decide que los archivos de la otra familia de productores no cargan marca, y un verificador construido así termina juzgando un PDF/A-2 válido contra la parte 1 y reportándolo como sin marca y de versión de PDF demasiado alta, exactamente lo contrario de la verdad. El validador en PDF Library for Delphi lee ambas formas. Si usted huele la marca por su cuenta, haga lo mismo:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // forma elemento
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // forma atributo, comillas dobles
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // forma atributo, comillas simples
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Un resultado vacío significa que no hay marca en ninguna de las dos formas. Un dígito le dice qué parte quiso el productor, y ese número es el que hay que comparar con su objetivo antes de decidir si convertir para nada
Sanitizar scripts antes de que el archivo entre al archivo
La conversión a archivo y la sanitización de seguridad suelen correr juntas, ya que el contenido que una política de seguridad quiere fuera se solapa mucho con lo que PDF/A prohíbe. SanitizeDocument toma una máscara de bits de flags SANITIZE_* y devuelve cuántas eliminaciones aplicó. ConvertToPDFA por su parte lo llama con SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION como su primer paso
Un detalle importa para los validadores. Los scripts a nivel de documento viven en un árbol de nombres /JavaScript bajo el diccionario /Names del catálogo, y cuando se elimina el último script el árbol ahora vacío se elimina con él. Un árbol vacío aun así anuncia que el documento tiene scripts, y algunos verificadores reaccionan a la clave misma sin contar lo que se sienta debajo
Sea cual sea la herramienta que sanitizó, verifique el archivo guardado con una carga fresca en lugar de confiar en el estado en memoria. Reabrirlo es barato:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
Para los pasos vecinos en un pipeline de archivo, vea las guías de preflight PDF/A y PDF/UA, redacción verdadera y eliminación de contenido, y esquemas de extensión XMP de PDF/A-3 para Factur-X, que retoma el lado de los metadatos una vez que un documento archivado también carga datos de factura estructurados
Toda la conversión, reparación de metadatos y validación mostradas aquí corren dentro de su propio proceso de Delphi, C++Builder o Lazarus, sin convertidor externo ni validador de línea de comandos en la cadena. La página de producto de PDF Library for Delphi lista las partes PDF/A, las ediciones y las plataformas objetivo