Una factura china compuesta con Noto Sans SC desde su archivo .otf puede abrirse en mutool con ideogramas que no pintan nada donde debería estar el nombre del cliente, mientras que una fuente TrueType dibuja la misma página sin problemas. El responsable es el charset CFF de la fuente; PDFlibPas lo reescribe a la identidad en la copia incrustada, de modo que los códigos de índice de glifo llegan al glifo buscado
Que una fuente presente el problema depende de cómo fue construida. Un programa TrueType incrustado como fuente CIDFontType2 recibe una CIDToGIDMap en modo Identity, y el código del content stream cae en el glifo correcto. La mayoría de las fuentes OpenType latinas con contornos CFF son name-keyed, y un programa CFF name-keyed usa el CID entrante directamente como índice de glifo. ISO 32000-1 incluso comenta, en la §9.7.4.2, que CID y GID coinciden en muchas fuentes. Pero no en todas. Las grandes familias CJK construidas como fuentes CID-keyed — Noto Sans CJK y sus hermanas Source Han entre ellas — traen su propia numeración de CIDs, y un escritor que manda índices de glifo directo a esa numeración obtiene el glifo que sea que tenga asignado ese CID
Qué hace un programa CFF CID-keyed con un CID
ISO 32000-1 §9.7.4.2 divide los programas CFF incrustados en dos casos según el Top DICT. Si el Top DICT usa los operadores CIDFont — en la práctica, abre con ROS (operador 12 30: registry, ordering, supplement) — el lector toma el CID del content stream, busca el glifo cuya entrada en el charset lleva ese CID y solo entonces trae el contorno desde el CharStrings INDEX. Sin operadores CIDFont, el CID es directamente el índice de glifo y el charset no interviene. Cualquier lector que siga la §9.7.4.2 al pie de la letra dibujará el glifo equivocado para un código de índice de glifo siempre que el charset no sea la identidad, sin importar qué visor use. El charset en sí, definido en el Adobe Technical Note #5176, tiene tres formatos con dos casos especiales:
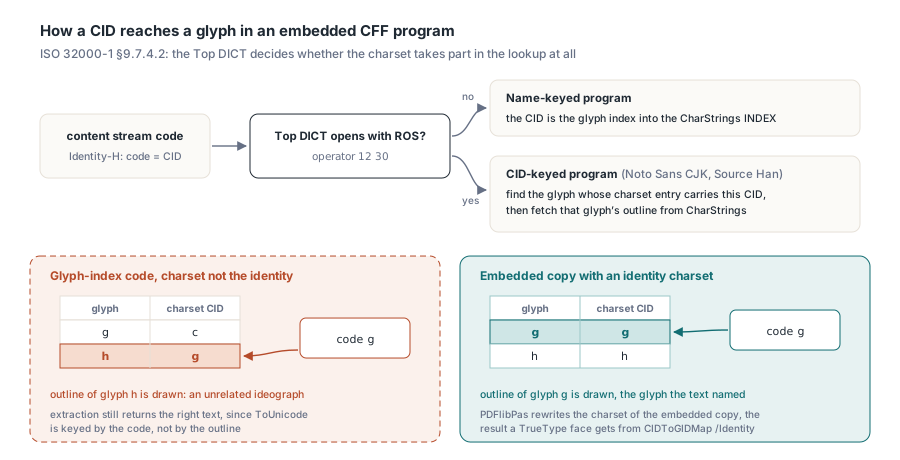
- El formato 0 guarda un SID o CID de 2 bytes por glifo, en orden de glifos
- El formato 1 guarda rangos: un primer CID seguido de un conteo de 1 byte con los glifos que le siguen con CIDs consecutivos
- El formato 2 es el mismo esquema de rangos con un conteo de 2 bytes, ideal para fuentes con secuencias largas sin cortes
- El glifo 0 es
.notdefy no tiene entrada en ningún formato; un offset de charset de 0, 1 o 2 nombra uno de los charsets predefinidos en lugar de apuntar a datos
Lo primero es averiguar qué tipo de fuente tiene entre manos. Identity-H del lado del PDF solo dice que un código de 2 bytes es igual al CID; cómo ese CID llega a un glifo vive por completo dentro del programa de fuente. La función de abajo lee la tabla CFF de un .otf, recorre el Top DICT en busca de ROS y verifica si el charset mapea cada glifo a un CID del mismo número. Solo necesita la RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // un archivo truncado lanza ERangeError en vez de leer mal
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Devuelve el final del INDEX en Pos y delimita su primer objeto
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // los offsets son 1-based desde aquí
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // INDEX de nombres
  SkipIndex(P, Dict, DictEnd);                           // INDEX del Top DICT
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // número real
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // byte reservado
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef sin entrada
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Un reporte con CIDKeyed = True y IdentityCharset = False describe justo la fuente de la que trata este artículo: cualquier escritor que ponga índices de glifo en el content stream sin compensar ese charset dibujará los glifos equivocados con ella. Un resultado name-keyed, o una fuente CID-keyed cuyo charset ya sea la identidad de casualidad, se dibuja bien bajo el mismo escritor. Así se explica que una fuente CJK de un producto funcione y la siguiente no. El ciclo compara solo el primer CID de cada rango, y con eso alcanza: un rango cubre glifos consecutivos con CIDs consecutivos, así que un rango que arranca sobre su propio índice de glifo se mantiene así hasta el final
Los índices de glifo recorren todo el diccionario de la fuente
Un escritor de PDF rara vez tiene CIDs a mano. La tabla cmap y el motor de shaping devuelven índices de glifo, así que el diseño natural escribe esos índices como códigos Identity-H de 2 bytes y indexa todo lo demás con ellos: el arreglo de anchos /W, el bitmap /CIDSet que pide PDF/A y el ToUnicode CMap que permite a la extracción recuperar el texto fuente. TrueType tiene una salida de emergencia: la Tabla 117 ofrece CIDToGIDMap, pero solo para CIDFonts de Tipo 2; un programa CFF vive en una fuente CIDFontType0, que no tiene forma de redirigir un CID desde el lado del PDF. Eso también descarta el truco que algunos escritores usan con TrueType — darle a un glifo reutilizado un segundo CID "alias" más allá del final de la fuente, para que ToUnicode pueda asociar texto distinto a cada uso. En una fuente CFF ese alias no selecciona ningún glifo, y mutool reporta que no puede dibujarlo. Las fuentes que mapean U+4E00 y U+2F00 (KANGXI RADICAL ONE) a un solo contorno son el caso típico. Si su documento necesita que ambos se extraigan distinto, envuelva la ocurrencia en un span de marked-content con /ActualText (ISO 32000-1 §14.9.4), que el lector usa en lugar del mapeo de la fuente
Reescritura del charset en su lugar
Hay dos caminos para reconciliar los códigos de índice de glifo con un programa CID-keyed. Uno traduce cada índice de glifo al CID de la fuente antes de escribirlo, lo que toca los códigos del content stream, las claves de /W, las posiciones de bit en /CIDSet, los códigos fuente del ToUnicode y cada subset del momento de guardar. El otro cambia la única estructura en desacuerdo, el charset, para que la fuente responda a los índices de glifo como lo haría un programa name-keyed. Ese segundo camino es el más seguro: el shaper, la tabla de anchos, el subsetter y el generador del ToUnicode siguen trabajando en espacio de glifos, y el único código que necesita entender CIDs es una rutina corta que corre una sola vez sobre la copia incrustada de la fuente. PDFlibPas toma ese camino
La reescritura conserva el formato del charset y su longitud en bytes. En el formato 0 cada entrada se sobrescribe con su propio índice de glifo. En los formatos 1 y 2 solo cambia el primer CID de cada rango, y los conteos quedan como están: nada crece ni se encoge. Los offsets del Top DICT hacia CharStrings, los Private DICT, FDArray y FDSelect siguen siendo válidos sin recodificar nada, y FDSelect — que asigna diccionarios de hinting por índice de glifo — deja cada glifo en su FD original. Los programas name-keyed, los charsets predefinidos, las tablas CFF2 (que no tienen charset) y los programas que no se pueden parsear quedan intactos. Tres rutas de código ejecutan la reescritura:
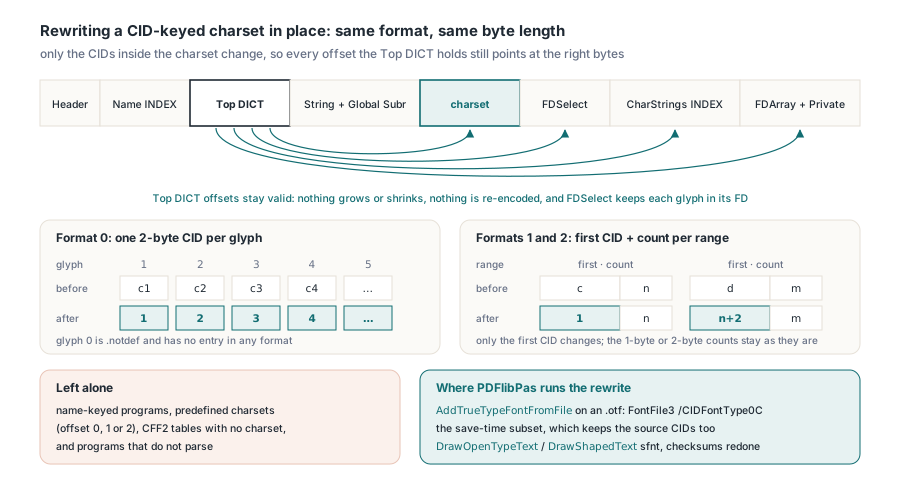
AddTrueTypeFontFromFilesobre un.otfincrusta la tablaCFFdesnuda comoFontFile3con subtipoCIDFontType0C, con el charset ya reescrito- El subset del momento de guardar conserva los índices de glifo originales pero también los CIDs fuente, así que su charset se reescribe una segunda vez
- El compañero de shaping detrás de
DrawOpenTypeTextyDrawShapedTextconserva el sfnt completo; tras la reescritura se recalcula el checksum de la tablaCFF, y elcheckSumAdjustmentde la tablaheadse convierte en0xB1B0AFBAmenos la suma del archivo - Ese ajuste está definido solo para una fuente única, así que una fuente tomada de una colección recibe únicamente el checksum de tabla
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Un .otf con contornos CFF se incrusta como FontFile3 /CIDFontType0C;
    // la copia incrustada recibe un charset identity cuando es CID-keyed
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Verifique la salida renderizándola; la extracción no va a mostrar el problema. pdftotext y todos los demás extractores leen el ToUnicode, que se indexa por el código del content stream y no sabe nada sobre qué contorno elige la fuente para él, así que una página con ideogramas equivocados sigue extrayendo la cadena correcta. mutool draw -r 150 -o page%d.png noto-sc.pdf muestra cómo se ve realmente la página, y para esta ruta de DrawText el pdffonts noto-sc.pdf de poppler debería listar la fuente como CID Type 0C. Lo esperado: ambas líneas se dibujan en Noto Sans SC con los glifos que nombra el texto fuente, y la misma salida aparece en Ghostscript
¿Qué forma de incrustación necesita PDF 1.6?
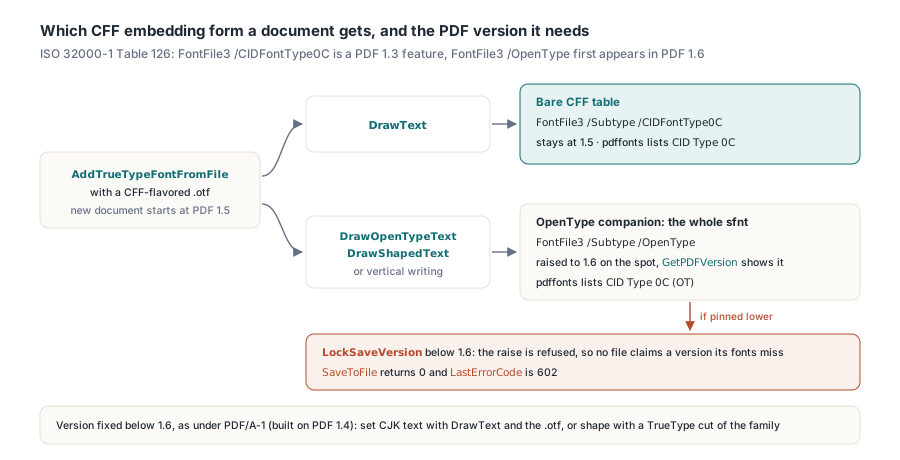
La forma OpenType. La Tabla 126 de ISO 32000-1 lista un stream FontFile3 de subtipo CIDFontType0C como característica de PDF 1.3, mientras que el subtipo OpenType — el sfnt completo con su tabla CFF — aparece por primera vez en PDF 1.6. Los documentos nuevos de PDFlibPas arrancan en la versión 1.5, donde cabe la ruta de DrawText con CFF desnudo. La primera llamada a DrawOpenTypeText, DrawShapedText o escritura vertical con una fuente CFF crea un compañero OpenType y sube el documento a 1.6 en el momento, algo que GetPDFVersion reporta de inmediato. Un bloqueo de versión cambia ese panorama: si LockSaveVersion fijó el documento más abajo, el aumento se rechaza y SaveToFile devuelve 0 con LastErrorCode 602, de modo que ningún archivo reclama una versión que sus fuentes no cumplen. Cuando un perfil de entrega fija la versión por debajo de 1.6 — PDF/A-1 es el caso común, dado que se construye sobre PDF 1.4 — componga el texto CJK con DrawText y el .otf, o use un corte TrueType de la familia para todo lo que necesite shaping
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Esperado: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Esperado: 1.6
    Lib.SaveToFile('shaped.pdf');  // Esperado en pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Esperado: 602
  finally
    Lib.Free;
  end;
end;
Anchos y ToUnicode indexados por los mismos números
Una vez que el charset es la identidad, el CID, el índice de glifo y el código del content stream son un solo número, y los anchos lo siguen. ISO 32000-1 §9.7.4.3 indexa /W por el propio CID, en grupos de un CID inicial seguido de un arreglo de anchos o de un primer CID, un último CID y un ancho compartido, sin offset /FirstChar del tipo que usan las fuentes simples. Cualquier CID que el arreglo omita toma /DW, y la Tabla 117 fija el valor por defecto de /DW en 1000. Cero está mal: un lector que recurre a 0 para los CIDs no listados colapsa una línea de ideogramas sobre sí misma. Para un .otf cargado vía AddTrueTypeFontFromFile, PDFlibPas escribe un arreglo /W que arranca en el CID 0 y lista el avance de cada glifo, junto a un /DW 1000 explícito. Del lado de la lectura, el texto CJK que se extrae como basura suele fallar en la mitad del codespace del mismo pipeline, y una auditoría de fuentes PDF/UA de anchos, CharSet y CIDSet confronta estos arreglos contra el programa incrustado
El ToUnicode tiene una regla de numeración propia. Una entrada bfrange guarda solo la primera cadena destino, y la §9.10.3 exige que su último byte no quede empujado más allá de 255 por la longitud del rango, porque un lector genera los destinos siguientes incrementando únicamente ese último byte. Glifos consecutivos mapeados a U+4EFE, U+4EFF, U+4F00 y U+4F01 parecen un solo rango, pero no lo son: un lector decodificaría el tercero como U+4E00. El escritor de PDFlibPas fusiona pares vecinos de glifo-a-Unicode en un mismo bfrange solo cuando los códigos fuente y los destinos quedan dentro de un mismo bloque de 256, y divide la secuencia en caso contrario. La composición CJK vertical pasa por las mismas fuentes compañeras, así que el texto japonés y chino en vertical hereda el charset identidad y estos rangos ToUnicode sin llamadas extra
Toda fuente que InspectOtfCharset reporte como CID-keyed con un charset que no sea la identidad es un caso donde los códigos de índice de glifo y la fuente discrepan. Incrustada vía PDFlibPas para Delphi, esa fuente conserva sus contornos, offsets y longitud de charset, y lo que cambia son los CIDs de esa única tabla, más los checksums cuando se conserva el sfnt completo