Abra un reporte generado en un screen reader y los fallos de siempre aparecen dentro de un minuto: "Página 3 de 40" se lee en voz alta en cada página, el logo de la empresa se anuncia como "graphic" sin nada después, y una tabla sale como una larga tanda de números sin nombres de columna. PDF Library for Delphi evita los tres con etiquetado automático de estructura: llame a SetAutoTagMode una vez, y las llamadas de dibujo ordinarias producen párrafos, encabezados, figuras, tablas y mobiliario de página saltable a medida que el documento se dibuja
El camino manual sigue existiendo. Puede envolver cada llamada de dibujo en BeginTag y EndTag, y para documentos con estructura inusual esa es la herramienta correcta. Para un reporte, una factura o un estado de cuenta ordinario, en cambio, el etiquetado a mano hace que la accesibilidad dependa de que nadie olvide nunca un par, en cada camino de código que dibuja algo, durante toda la vida del producto. No apostaríamos un requisito de compliance a eso
Qué activa SetAutoTagMode
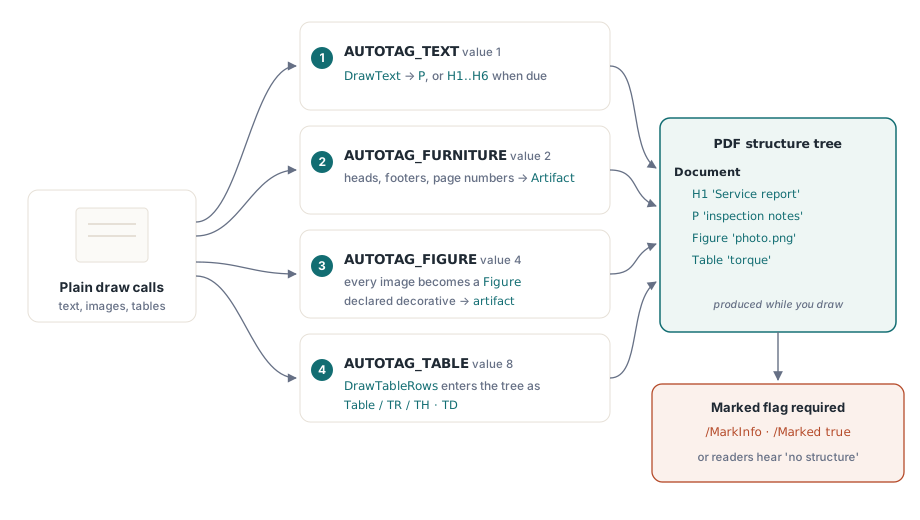
SetAutoTagMode toma una máscara de bits y devuelve el modo que estaba vigente antes de la llamada. Cada bit cubre un tipo de contenido:
AUTOTAG_TEXT(1): el texto se convierte en párrafo, o en encabezado cuando hay uno registradoAUTOTAG_FURNITURE(2): los headers corrientes, footers y números de página se convierten en artifacts que un lector se saltaAUTOTAG_FIGURE(4): una imagen dibujada se convierte en figure, o en artifact cuando usted la declaró decorativaAUTOTAG_TABLE(8): las tablas dibujadas llevan sus filas y celdas al árbol de estructuraAUTOTAG_DEFAULT(15): los cuatro, y el valor que recomendamos para cualquier código de reportes nuevo
Activar el modo también marca el documento como etiquetado, y ese paso importa más de lo que parece. Bajo ISO 32000-1 §14.7.1 un lector trata un archivo como sin etiquetar a menos que el diccionario /MarkInfo del catálogo diga /Marked true. Un archivo puede cargar un árbol de estructura completo y correcto y aun así anunciarse como si no tuviera estructura alguna, porque falta el único flag que le dice a la tecnología asistiva que lo busque. El árbol está ahí. Nada lo lee
El etiquetado de texto funciona por llamada. Cada llamada a DrawText, DrawWrappedText o DrawTextBox se convierte en un elemento, así que un párrafo dibujado línea por línea con cinco llamadas a DrawText le llega al lector como cinco párrafos de una línea. Si su código de layout ya parte las líneas por su cuenta, eso vale la pena cambiarlo: entréguele el párrafo completo a DrawWrappedText y deje que una llamada produzca un párrafo
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetOrigin(1);                          // origen superior izquierda, y crece hacia abajo
    Lib.SetDocumentLanguage('en-US');
    Lib.SetAutoTagMode(AUTOTAG_DEFAULT);       // antes de cualquier llamada a RegisterHeading
    Lib.AddStandardFont(4);

    Lib.SetTextSize(18);
    Lib.RegisterHeading(1, 'Annual service report');
    Lib.DrawText(72, 96, 'Annual service report');        // H1 etiquetado

    Lib.SetTextSize(11);
    Lib.DrawWrappedText(72, 130, 450,
      'Every unit installed before 2024 was inspected. ' +
      'Units that failed the torque check were serviced on site.');  // one P

    // ... páginas restantes ...

    // Recorre todas las páginas existentes, así que llámelo cuando las páginas estén dibujadas
    Lib.AddPageFooter('', 'Page &P of &N', 36, 1.0, 1);  // artifact de paginación
    Lib.SaveToFile('report.pdf');
  finally
    Lib.Free;
  end;
end;
El comentario de la tercera línea está ahí por algo. RegisterHeading solo encola un nivel de encabezado cuando el etiquetado de texto ya está activo, y SetAutoTagMode limpia cualquier nivel en cola cuando corre. Registre el encabezado primero y active el modo después, y el título sale como un párrafo corriente sin ningún error que se lo diga
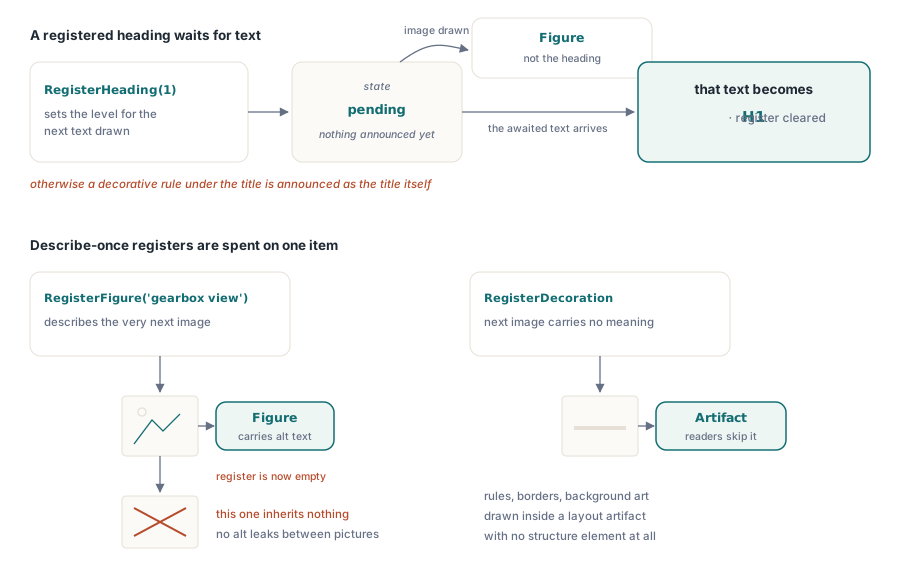
¿Por qué un encabezado espera aunque se dibuje una imagen antes?
RegisterHeading nombra el nivel para el próximo texto, y solo el texto puede consumirlo. Si se dibuja una imagen en el medio, la imagen se convierte en figure y el encabezado sigue en cola para el texto que viene después. La implementación obvia deja que cualquier tag consuma el nivel en cola, y entonces la secuencia común de registrar un encabezado de sección, dibujar una imagen de banner y dibujar el título produce un banner etiquetado como H2 y un título real degradado a párrafo. Un lector que navega por encabezados aterriza en una imagen
Dos cosas más se siguen de cómo funciona la cola. El nivel de encabezado se adjunta al texto que venga después, sea cual sea el string que usted pasó a RegisterHeading: si su layout dibuja un kicker chico de "Sección 3" sobre el título, el kicker se convierte en el encabezado. Y los niveles más profundos que seis se escriben como H6, porque un lector no conoce nada más allá. El argumento Title sigue haciendo su propio trabajo, alimentando el outline que DrawTOC luego convierte en una tabla de contenidos
Las imágenes reciben el mismo tratamiento de "se consume en un item". RegisterFigure provee la descripción que lleva la próxima imagen, y RegisterDecoration declara la próxima imagen como una regla, borde o fondo sin significado, que se escribe como un artifact Layout (ISO 32000-1 §14.8.2.2). Cada declaración la consume exactamente una imagen, así que una imagen posterior nunca hereda una descripción escrita para una anterior. Un alt text adjuntado a la imagen equivocada es peor que ninguno, porque el lector afirma algo falso con toda la confianza
Deliberadamente no intentamos inferir qué imágenes son decorativas. Una imagen es o bien contenido que el lector debería describir o bien contenido que debería saltarse, y solo el código llamador sabe cuál. El caso a evitar es el tercero: una imagen dibujada sin ninguna declaración se convierte en una figure sin descripción, lo que falla la validación PDF/UA y hace que el screen reader se detenga a decir "graphic" y luego nada. Si usted hace grep de su código de reportes por DrawImage, cada aparición debería tener un RegisterFigure o un RegisterDecoration justo arriba
Lib.RegisterHeading(2, 'Gearbox inspection');   // en cola para el próximo texto

Lib.RegisterFigure('Exploded view of the gearbox assembly');
Lib.AddImageFromFile('gearbox.png', 0);       // carga y selecciona la imagen
Lib.DrawImage(72, 160, 360, 270);             // se convierte en Figure etiquetada

Lib.RegisterDecoration;                       // meaningless rule
Lib.AddImageFromFile('divider.png', 0);
Lib.DrawImage(72, 450, 360, 4);               // dibujada dentro de un artifact de layout

Lib.DrawText(72, 480, 'Gearbox inspection');  // recién aquí aparece el H2
La descripción merece más cuidado que cualquier otro string del documento. Un lector no vidente la recibe en lugar de la imagen, y eso es todo lo que recibe. "Chart" no le dice nada; "Ingresos trimestrales por región, con la región este la más alta en el Q3" le dice lo que un lector vidente saca de la imagen en dos segundos
Tablas: las filas de header se declaran, jamás se adivinan
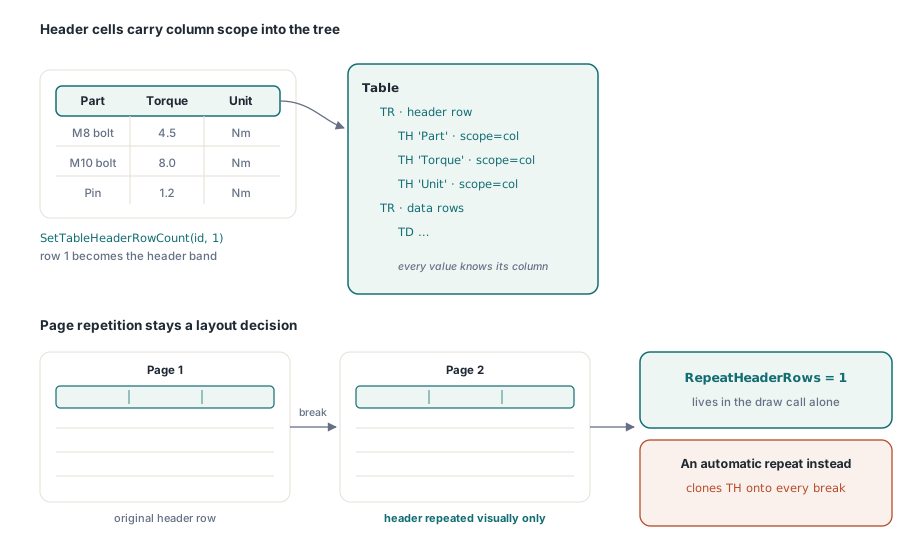
Con el bit de tablas activo, DrawTableRows escribe la tabla, sus filas y sus celdas al árbol de estructura, así que un lector puede decir en qué columna está un valor en vez de leer la cuadrícula como texto suelto. SetTableHeaderRowCount dice cuántas filas iniciales son headers. Esas filas se escriben como celdas TH con scope de columna, que es lo que permite a un lector anunciar "Torque" antes del valor al que el usuario se movió
El conteo de filas de header por defecto es cero, y eso fue una decisión. La primera fila de una tabla normalmente es el header, así que adivinar acertaría la mayoría de las veces. El costo del error está torcido, sin embargo: una fila de datos confundida con un header se lee en voz alta antes de cada valor de su columna, lo que confunde mucho más que una tabla sin headers. Una línea de código suya es más barata que ese modo de fallo
Declarar filas de header y repetirlas en cada página son decisiones separadas. SetTableHeaderRowCount es semántico y no cambia nada en la página. La repetición es layout, y pertenece al argumento RepeatHeaderRows de DrawTaggedTableRows. Si las dos fueran una sola configuración, pedir etiquetas de header correctas también empezaría a dibujar bandas de header repetidas que usted nunca pidió, y un layout que fue revisado página por página se movería. Las filas pasadas como RepeatHeaderRows también se etiquetan como headers, así que no tiene que decir lo mismo dos veces
var
  TableID: Integer;
begin
  TableID := Lib.CreateTable(40, 3);
  Lib.SetTableHeaderRowCount(TableID, 1);       // la fila 1 es la banda de header
  Lib.SetTableCellContent(TableID, 1, 1, 'Part');
  Lib.SetTableCellContent(TableID, 1, 2, 'Torque');
  Lib.SetTableCellContent(TableID, 1, 3, 'Unit');
  // ... llenar las filas de datos ...
  // Dibujar las filas 1..40 en una banda de 600pt, repitiendo una fila de header por página
  Lib.DrawTaggedTableRows(TableID, 72, 150, 600, 1, 40, 1);
end;
Secciones etiquetadas a mano dentro de un documento automático
El etiquetado automático se hace a un lado mientras un tag que usted abrió a mano siga abierto. Eso permite que su código describa una parte del documento por su cuenta y deje el resto a la librería sin que los dos se aniden entre sí, que es el arreglo que la mayoría de los documentos reales quieren. La portada y el bloque de firma tienen estructura que solo usted entiende. Las doscientas páginas de cuerpo entre ellas no
Tres reglas mantienen la salida válida sin importar qué mezcla use. Nada se etiqueta dentro de un artifact, porque la secuencia de marked-content de un artifact no puede además cargar un elemento de estructura, y un archivo que lo intenta falla la validación PDF/UA. El texto vacío no abre ningún elemento, así que un DrawText extraviado con un string vacío no puede dejar atrás un elemento que un lector anuncie como un blanco. Y una llamada de la librería que dibuja a través de otras llamadas de dibujo internamente abre un tag en el nivel exterior, así que sus piezas nunca terminan anidadas dentro de un segundo elemento propio
Después de guardar, lea el árbol de vuelta antes de confiar en él. La API de lectura es base 1, y eso nos agarró: nuestro primer loop de chequeo iba de 0 a StructTreeItemCount - 1, recibía un registro vacío al principio, nunca llegaba al último elemento, y por un tiempo estuvimos convencidos de que un párrafo había desaparecido. No había desaparecido nada. El loop simplemente estaba desfasado en los dos extremos
var
  I: Integer;
begin
  // Una cita destacada etiquetada a mano; el etiquetado automático no interviene
  Lib.BeginTag('BlockQuote', '', '');
  Lib.DrawWrappedText(72, 520, 450,
    'All readings were taken with the unit at operating temperature.');
  Lib.EndTag;
  Lib.SaveToFile('report.pdf');

  // Leer el árbol de vuelta: los índices van de 1 a StructTreeItemCount
  if Lib.LoadFromFile('report.pdf', '') = 1 then
    for I := 1 to Lib.StructTreeItemCount do
      Writeln(Lib.GetStructTreeItemText(I, 2), '  ',    // tipo resuelto
              Lib.GetStructTreeItemText(I, 4));         // /Alt, si lo hay
end;
Un listado así es un chequeo rápido de sanidad, no un veredicto. Lo que usted quiere ver es un H1 antes del primer párrafo, cada figure con su descripción, y ninguna figure con un /Alt vacío
Cuando el orden de dibujo y el orden de lectura se separan
El etiquetado automático registra los elementos en el orden en que el contenido se dibuja. Si su código de layout dibuja la sidebar antes del cuerpo, ese es el orden que guarda el árbol, y ese es el orden en que lee un screen reader. Para documentos donde el orden visual y el orden de lectura genuinamente difieren, o que necesitan otros tipos de estructura o lenguaje por elemento, la API de etiquetado manual es la mejor opción, y el recorrido de PDF etiquetado y estructura de accesibilidad cubre roles, scopes y bindings de headers en detalle
Para páginas que usted no dibujó, como páginas importadas sin marked content, AutoTagPages funciona después de los hechos: toma el tamaño de texto mediano a través de las páginas que recibe como texto de cuerpo, trata las tandas marcadamente más grandes como encabezados, y marca el resto del pintado como artifacts. Es la herramienta correcta para contenido que no puede regenerar. Para cualquier cosa que su propio código dibuje, preferimos etiquetar al momento de dibujar, porque ahí la librería recibe el dato de qué es un encabezado en vez de adivinarlo por el tamaño de la fuente
Cuando el documento esté terminado, páselo por un checker en vez de asumir: las notas sobre preflight PDF/A y PDF/UA muestran cómo obtener un veredicto sobre la estructura que usted produjo, y el artículo sobre exportación de reportes desde datasets muestra dónde se ubican estas llamadas en un motor de reportes que arma su layout desde los datos
Como PDF Library for Delphi está escrita en Pascal nativo para Delphi, C++Builder y Lazarus, sin runtime de PDF externo que distribuir, la salida etiquetada sale del mismo código que dibuja la página. La referencia completa de la API y la lista de plataformas están en la página del producto PDF Library for Delphi