Το PDFium Component ελέγχει την ισοδυναμία metadata Info-προς-XMP του PDF/A με το TPdf.InspectPdfAMetadata και την επιδιορθώνει με το TPdf.NormalizePdfAMetadata. Το ISO 19005-1 (όπως διορθώθηκε από το Cor.1) απαιτεί καθεμία από τις οκτώ αντιστοιχισμένες εγγραφές Info, από Title έως ModDate, να κουβαλάει την ίδια τιμή με την ιδιότητα XMP της, όχι απλώς να υπάρχει· ο έλεγχος διαβάζει το σωστό σχήμα RDF, ταυτίζει namespaces με URI και συγκρίνει ημερομηνίες ως χρονικά σημεία
Η αναφορά ελαττώματος που συνήθως ξεκινά αυτή τη συζήτηση φαίνεται αθώα. Ένα σύστημα διαχείρισης εγγράφων σφραγίζει ένα νέο /ModDate στο λεξικό Info σε κάθε σταδιακή αποθήκευση, αφήνει το πακέτο XMP στην ησυχία του, και έξι μήνες μετά ένας έλεγχος αρχείου σημαδεύει χιλιάδες αρχεία ως μη συμμορφούμενα. Και οι δύο ημερομηνίες είναι εκεί. Απλώς σταμάτησαν να συμφωνούν στην πρώτη επεξεργασία, και ένας έλεγχος παρουσίας δεν το πρόσεξε ποτέ. Επεξεργασίες Title μέσα από API μόνο για Info, και ένα string Author όπως Finance; Controlling που κάποιο εργαλείο έσπασε σε δύο στοιχεία dc:creator, αποτυγχάνουν με τον ίδιο τρόπο
Γιατί το PDF/A απορρίπτει metadata που υπάρχουν και στις δύο θέσεις;
Το PDF/A το απορρίπτει επειδή το ISO 19005-1 §6.7.3 είναι κανόνας τιμής, όχι κανόνας παρουσίας: ο Πίνακας 1 αντιστοιχίζει οκτώ κλειδιά Info σε ιδιότητες XMP, και μόλις ένα κλειδί Info υπάρχει, η αντιστοιχισμένη ιδιότητα XMP πρέπει να κρατάει ισοδύναμη τιμή. Ο σαρωτής επιπέδου bytes που περιγράφεται στο preflight validation PDF/A με PDFium Component επιβεβαιώνει μόνο ότι τα xmp:CreateDate και xmp:ModifyDate υπάρχουν (pvaiMissingXmpDates). Από την v3.72.0, το TPdf.ValidatePdfA εκτελεί επιπλέον την πλήρη σύγκριση τιμών και προσθέτει pvaiInfoXmpValueMismatch στο σύνολο ζητημάτων όταν υπάρχει πακέτο XMP αλλά διαφωνεί με το Info (πακέτο που δεν μπορεί να γίνει parse μετρά ως διαφωνία). Ένα απόν πακέτο εξακολουθεί να αναφέρεται ως pvaiMissingXmpMetadata, ώστε τα δύο ζητήματα να μην μετρούν ποτέ διπλά το ίδιο ελάττωμα
Τι σχήμα RDF χρειάζεται κάθε αντιστοιχισμένη ιδιότητα XMP;
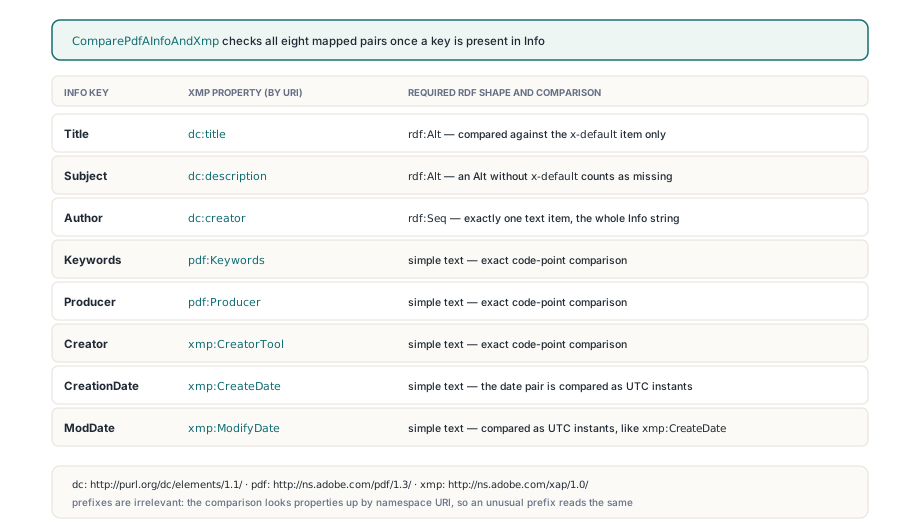
Καθεμία από τις οκτώ αντιστοιχίσεις έχει σταθερό τύπο XMP, και μια σωστή τιμή σε λάθος δοχείο αποτυγχάνει ακόμη. Το ComparePdfAInfoAndXmp στο FPdfPdfa.pas ψάχνει τις ιδιότητες με URI namespace, ώστε ένα πακέτο που δένει το http://purl.org/dc/elements/1.1/ σε ασυνήθιστο πρόθεμα να διαβάζεται ακριβώς όπως ένα που χρησιμοποιεί dc. Τα απαιτούμενα σχήματα είναι:
- Title →
dc:titleκαι Subject →dc:description: μια γλωσσική εναλλακτικήrdf:Alt, συγκρινόμενη μόνο με το στοιχείοx-defaultτης (η γλωσσική ετικέτα ταυτίζεται χωρίς διάκριση πεζών-κεφαλαίων)· ένα Alt χωρίςx-defaultμετρά ως απόν - Author →
dc:creator: έναrdf:Seqμε ακριβώς ένα στοιχείο κειμένου που κρατάει όλο το string Info, ώστε μια λίστα συγγραφέων με ερωτηματικά να μένει μία μόνο εγγραφή - Keywords →
pdf:Keywordsκαι Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/): απλές ιδιότητες κειμένου - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/): απλές ιδιότητες κειμένου
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Οι τιμές κειμένου συγκρίνονται ως ακριβείς ακολουθίες code points Unicode, χωρίς trimming, δίπλωμα πεζών-κεφαλαίων ή κανονικοποίηση. Ένα κενό στο τέλος, ή ένα προσυντεθειμένο é από τη μία πλευρά και ένα διαλυμένο e με συνδυαστικό τόνο από την άλλη, είναι πραγματική αναντιστοιχία. Η πλευρά Info έρχεται πάντα από τη δική της αποκωδικοποίηση PDFDocEncoding και κειμένου UTF-16 του PDFium μέσω FPDF_GetMetaText, που εμποδίζει τη βιβλιοθήκη να ξαναϋλοποιήσει την αποκωδικοποίηση strings και να το πάρει λάθος διακριτικά· η πλευρά XMP είναι τόσο καθαρή όσο τα bytes που την παρήγαγαν, και γι' αυτό οι παγίδες codepage που φθείρουν metadata XMP κάτω από Free Pascal μετράνε και εδώ
Πότε είναι ίσες μια ημερομηνία PDF και μια ημερομηνία XMP;
Μια ημερομηνία PDF και μια ημερομηνία XMP είναι ίσες όταν περιγράφουν το ίδιο χρονικό σημείο ως το δευτερόλεπτο, με την ίδια γνώση ζώνης ώρας και από τις δύο πλευρές. Και οι δύο parsers δέχονται νόμιμη μειωμένη ακρίβεια, οπότε τα D:2026 και 2026 σημαίνουν και τα δύο 1 Ιανουαρίου 2026, 00:00:00. Όταν και οι δύο τιμές κουβαλάνε ζώνη, μετατρέπονται σε UTC πριν τη σύγκριση: το D:20260827093659+08'00' ισούται με 2026-08-27T01:36:59Z. Όταν καμία δεν κουβαλάει ζώνη, τα τοπικά συστατικά συγκρίνονται όπως γράφτηκαν. Όταν μόνο η μία πλευρά έχει ζώνη, το αποτέλεσμα είναι pamsValueMismatch, επειδή το να επινοήσεις μια μετατόπιση είναι μαντεψιά. Ένα μη μηδενικό κλασματικό δευτερόλεπτο όπως .250 στο XMP εξαναγκάζει επίσης αναντιστοιχία, αφού μια ημερομηνία PDF δεν έχει τρόπο να το εκφράσει και μια σιωπηλή στρογγυλοποίησή του θα έκρυβε πραγματική διαφωνία· το .000 γίνεται δεκτό. Οι απροσδιόριστες τιμές αναφέρονται ξεχωριστά ως pamsInvalidInfoDate ή pamsInvalidXmpDate
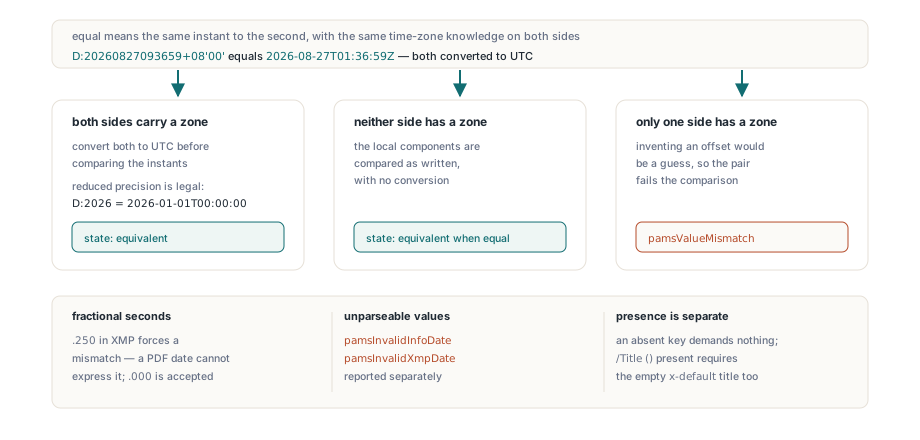
Η παρουσία έχει τον δικό της κανόνα. Το TPdfAMetadataValues.Present είναι ένα σύνολο που γεμίζει περπατώντας το λεξικό /Info του ενεργού trailer, και κρατάει το «απόν κλειδί» ξεχωριστά από το «παρόν κλειδί με κενό string». Ένα απόν κλειδί δίνει pamsNotRequired και δεν απαιτεί τίποτα από το XMP· το /Title () είναι παρόν, οπότε το πακέτο XMP πρέπει να κουβαλάει και εκείνο έναν κενό τίτλο x-default
Πώς επιθεωρείς metadata Info και XMP πριν την αποθήκευση;
Το TPdf.InspectPdfAMetadata επιστρέφει ένα TPdfAMetadataReport με ένα TPdfAMetadataComparison ανά πεδίο, το καθένα με την τιμή Info, την τιμή XMP και μια TPdfAMetadataState, ώστε μια αποτυχία να εξηγείται χωρίς reverse-engineering ενός μοναδικού flag επικύρωσης. Το MismatchFields συνοψίζει το αποτυγχάνον σύνολο, το HasXmpPacket λέει αν βρέθηκε πακέτο, και το XmpParseError κουβαλάει το μήνυμα του parser όταν το πακέτο υπάρχει αλλά δεν διαβάζεται
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
Τι αλλάζει το NormalizePdfAMetadata, και τι αρνείται;
Το TPdf.NormalizePdfAMetadata αντιμετωπίζει το λεξικό Info ως πηγή αλήθειας και ξαναγράφει μόνο τις ιδιότητες XMP των οποίων το πεδίο κατέληξε στο MismatchFields· όλα τα άλλα μέσα στο πακέτο επιβιώνουν. Title και Subject γράφονται στο στοιχείο x-default ενώ οι άλλες γλωσσικές εναλλακτικές μένουν ανέπαφες, το Author γίνεται rdf:Seq ενός στοιχείου, άγνωστα namespaces και άσχετες ιδιότητες διατηρούνται, και οι ιδιότητες XMP για απόντα κλειδιά Info μένουν ανέγγιχτες. Μια ημερομηνία Info με ζώνη γράφεται ως κανονική ημερομηνία XMP UTC με κατάληξη Z· μια χωρίς ζώνη κρατάει τα τοπικά της συστατικά. Η υπερφόρτωση αρχείου αποθηκεύει μέσω προσωρινού αρχείου και ατομικής αντικατάστασης, και η ίδια η ενημέρωση XMP προσαρτάται ως σταδιακή ενημέρωση
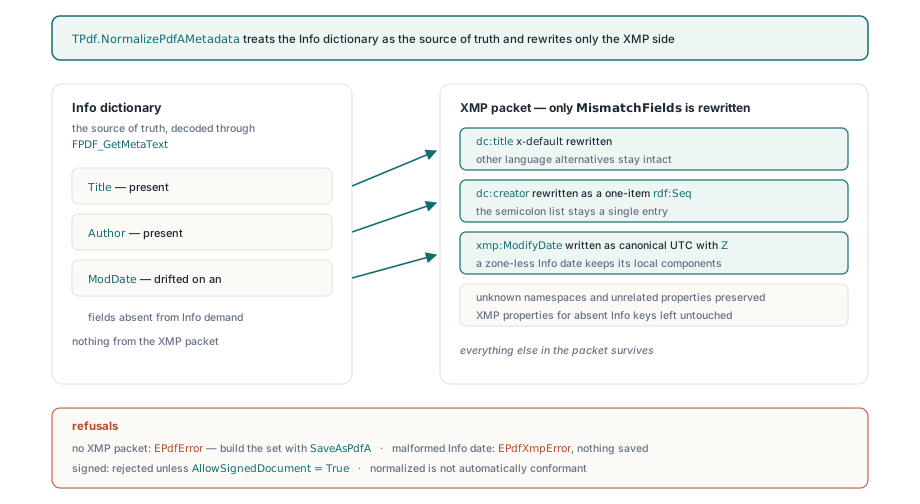
Οι αρνήσεις είναι σκόπιμες. Χωρίς πακέτο XMP η μέθοδος πετάει EPdfError, επειδή το χτίσιμο ενός πλήρους συνόλου ταυτοποίησης και metadata PDF/A είναι δουλειά του SaveAsPdfA, που καλύπτεται στο δημιουργία αρχείων αρχειοθέτησης PDF/A με PDFium Component. Μια κακοσχηματισμένη ημερομηνία Info πετάει EPdfXmpError αντί να γράψει μια πειστική αλλά λάθος τιμή, και τίποτα δεν αποθηκεύεται. Τα υπογεγραμμένα έγγραφα απορρίπτονται εκτός αν ο καλών περάσει AllowSignedDocument = True. Η ισοδυναμία είναι ένας κανόνας του ISO 19005-1 κι αυτός, οπότε ένα κανονικοποιημένο αρχείο δεν είναι αυτόματα συμμορφούμενο
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // ήδη συνεπές, άσε το αρχείο στην ησυχία του
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // κακοσχηματισμένη ημερομηνία Info ή αδιάβαστο πακέτο
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Τρέχοντας τη σύγκριση πάνω στο δικό σας πακέτο XMP
Τα ComparePdfAInfoAndXmp και SynchronizePdfAInfoToXmp είναι σκέτες συναρτήσεις στο FPdfPdfa που δουλεύουν πάνω σε ένα TPdfXmpPacket χωρίς φορτωμένο έγγραφο, που ταιριάζει σε unit tests και σε σωλήνες που συναρμολογούν XMP από πρότυπο. Η μία παγίδα είναι το Present: ένα record αρχικοποιημένο με Default(TPdfAMetadataValues) έχει κενό σύνολο, κάθε πεδίο τότε αναφέρει pamsNotRequired, και η σύγκριση περνά κενά περιεχομένου ό,τι τιμές κι αν έχετε γεμίσει
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Το Present αποφασίζει ποια πεδία είναι υποχρεωτικά· οι σκέτες τιμές αγνοούνται
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // το xmp:ModifyDate είναι τώρα 2026-08-27T01:36:59Z, το dc:creator rdf:Seq ενός στοιχείου
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Αν ο σωλήνας σας αρχειοθετεί έγγραφα που άλλα συστήματα εξακολουθούν να επεξεργάζονται, ζευγαρώστε μια νυχτερινή σάρωση InspectPdfAMetadata με NormalizePdfAMetadata για τα αρχεία που αποκλίνουν, και κρατήστε το ValidatePdfA ως πύλη πριν οτιδήποτε φύγει για μακροχρόνια αποθήκευση. Η τυποποιημένη αναφορά, η διαδρομή επιδιόρθωσης και τα υπόλοιπα εργαλεία PDF/A έρχονται μέσα στο PDFium Component για Delphi και C++Builder