Ανοίξτε ένα PDF που παρήγαγε το Microsoft Word ή το Excel, ξεφυλλίστε το, και τίποτα δεν φαίνεται ασυνήθιστο. Φορτώστε το σε ένα πρόγραμμα Delphi, διαβάστε τον αριθμό σελίδων, και ο αριθμός είναι σωστός. Έπειτα αποθηκεύστε το ξανά με ενεργοποιημένη κρυπτογράφηση και η εργασία αποτυγχάνει με ένα EListError, ή η έξοδος ανοίγει με προειδοποίηση κατεστραμμένης διασταυρούμενης αναφοράς. Το αρχείο δεν ήταν ποτέ κατεστραμμένο. Είναι ένα αρχείο υβριδικής αναφοράς, και ακριβώς η δομή που επιτρέπει σε έναν προβολέα δεκαπέντε ετών να το ανοίξει είναι η δομή που νικά έναν φορτωτή ο οποίος σταματά να διαβάζει πολύ νωρίς
Αυτός είναι ένας από τους πιο συνηθισμένους τρόπους με τους οποίους μια διοχέτευση PDF που πέρασε κάθε εσωτερική δοκιμή συναντά ένα αρχείο που δεν μπορεί να κάνει round-trip. Οι είσοδοι είχαν όλες παραχθεί εσωτερικά, οπότε δεν ήταν ποτέ υβριδικές. Το πρώτο υβριδικό αρχείο φτάνει την ημέρα που ένας πελάτης προωθεί ένα τιμολόγιο εξαγόμενο από ένα υπολογιστικό φύλλο
Τι γράφουν πραγματικά το Word και το Excel
Το ISO 32000-1 περιγράφει τη διάταξη υβριδικής αναφοράς στην §7.5.8.4. Μια εφαρμογή που θέλει χαρακτηριστικά του PDF 1.5, όπως ροές αντικειμένων, ενώ ταυτόχρονα επιτρέπει σε έναν αναγνώστη PDF 1.4 να ανοίξει το αρχείο, γράφει τις πληροφορίες διασταυρούμενης αναφοράς δύο φορές. Υπάρχει ένας κλασικός πίνακας διασταυρούμενης αναφοράς, οι γραμμές ASCII σταθερού πλάτους που τελείωναν κάθε PDF μέχρι την έκδοση 1.4, και υπάρχει μια ροή διασταυρούμενης αναφοράς που ευρετηριάζει τα υπόλοιπα. Το trailer της κλασικής ενότητας φέρει μια καταχώριση /XRefStm της οποίας η τιμή είναι η μετατόπιση σε bytes αυτής της ροής
Ο καταμερισμός εργασίας είναι σκόπιμος. Τα αντικείμενα στα οποία πρέπει να φτάσει ένας παλιός αναγνώστης, ανάμεσά τους ο κατάλογος και το δέντρο σελίδων, είναι προσπελάσιμα από τον κλασικό πίνακα. Τα αντικείμενα που διπλώθηκαν μέσα σε συμπιεσμένες ροές αντικειμένων σημειώνονται ως ελεύθερα στον κλασικό πίνακα, με μια καταχώριση τύπου f, ώστε ένας αναγνώστης 1.4 να τα προσπερνά κατευθείαν και να μη σκοντάφτει ποτέ σε μια δομή που δεν μπορεί να αναλύσει. Οι πραγματικές τους θέσεις ζουν μόνο στη ροή διασταυρούμενης αναφοράς. Η υπογραφή ενός τέτοιου αρχείου είναι η ουρά του: μια σύντομη κλασική ενότητα, συχνά τίποτα περισσότερο από xref ακολουθούμενο από μια κεφαλίδα υποενότητας 0 0, της οποίας το trailer δείχνει στο /XRefStm όπου βρίσκονται τα πραγματικά δεδομένα ανάκτησης
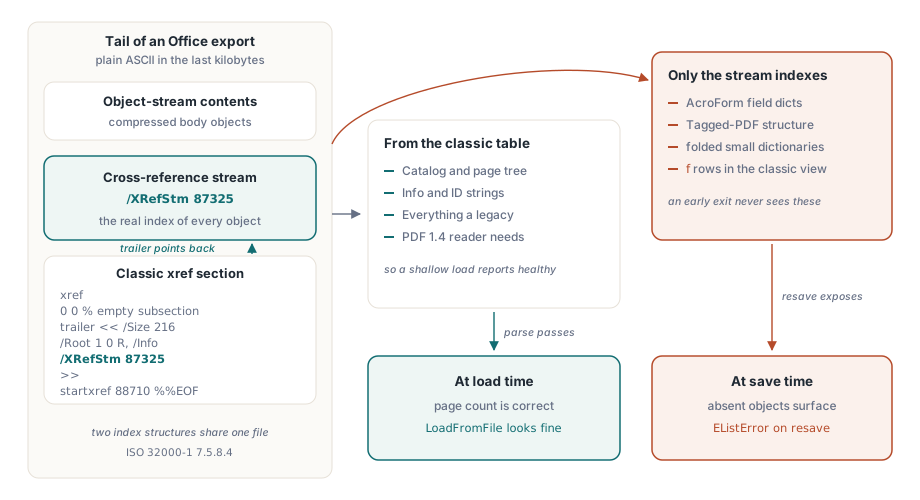
/XRefStm, ενώ η πλευρά της ροής κρατά το πραγματικό ευρετήριο αντικειμένωνΓιατί ένας σωστός αριθμός σελίδων δεν αποδεικνύει τίποτα
Επειδή ο κατάλογος και το δέντρο σελίδων είναι επίτηδες προσπελάσιμα από τον κλασικό πίνακα, ένας φορτωτής που διαβάζει μόνο αυτόν τον πίνακα βρίσκει το /Root, διασχίζει το δέντρο σελίδων και αναφέρει τον σωστό αριθμό σελίδων. Όλα όσα χρειάζεται ένας παλιός αναγνώστης είναι παρόντα, οπότε το αρχείο φαίνεται υγιές. Τα αντικείμενα που χάθηκαν είναι εκείνα που πακεταρίστηκαν σε ροές αντικειμένων: λεξικά πεδίων AcroForm, στοιχεία δομής tagged PDF, η μακριά ουρά μικρών λεξικών που ποτέ δεν χρειάστηκε να είναι ορατά σε έναν παλαιό προβολέα
Δεν αντιλαμβάνεστε το κενό μέχρι κάτι να αγγίξει αυτά τα αντικείμενα, και μια πλήρης επαναποθήκευση τα αγγίζει όλα. Η διάσχιση του εγγράφου για επανακρυπτογράφηση ή επανεγγραφή είναι ακριβώς η λειτουργία που ζητά κάθε αριθμό αντικειμένου με τη σειρά, γι' αυτό και το σύμπτωμα εμφανίζεται τη στιγμή της αποθήκευσης αντί τη στιγμή της φόρτωσης, μακριά από την αιτία του
Η παγίδα είναι ένας ανιχνευτής που βλέπει xref και σταματά
Ο φθηνός τρόπος για να αποφασίσετε πώς ευρετηριάζεται ένα αρχείο είναι να ακολουθήσετε το startxref και να επιθεωρήσετε τα πρώτα bytes στα οποία δείχνει. Η λέξη-κλειδί xref σημαίνει κλασικό πίνακα· ένα αντικείμενο ροής σημαίνει ροή διασταυρούμενης αναφοράς. Αυτός ο έλεγχος είναι σωστός για κάθε αρχείο που δεσμεύεται σε ένα μόνο σχήμα. Είναι λάθος για ένα υβριδικό αρχείο, του οποίου το startxref στοχεύει σε μια κλασική ενότητα με μοναδικό σκοπό να ικανοποιήσει τους παλιούς αναγνώστες, ενώ το /XRefStm στο trailer αυτής της ενότητας είναι εκεί όπου ευρετηριάζεται στην πραγματικότητα το μεγαλύτερο μέρος του εγγράφου. Ένας ανιχνευτής που επιστρέφει «κλασικό» στο πρώτο xref που συναντά δεν διαβάζει ποτέ το /XRefStm, και κάθε αντικείμενο που ζει μόνο στη ροή γίνεται αόρατο
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // ο αριθμός είναι σωστός
    // επιθεωρήστε ή επεξεργαστείτε εδώ το φορτωμένο έγγραφο
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // διασχίζει κάθε αντικείμενο
  finally
    Pdf.Free;
  end;
end;
Με τον ανιχνευτή πρόωρης εξόδου σε λειτουργία, η φόρτωση φαίνεται εντάξει και η επαναποθήκευση είναι εκεί όπου τα απόντα αντικείμενα κάνουν αισθητή την παρουσία τους. Η διόρθωση δεν είναι να διαβάζετε περισσότερα bytes στην αρχή· είναι να αναγνωρίζετε το υβριδικό trailer και να ακολουθείτε το /XRefStm πριν αποφασίσετε ότι το αρχείο έχει τελειώσει
Η σειρά συγχώνευσης δεν είναι διαπραγματεύσιμη
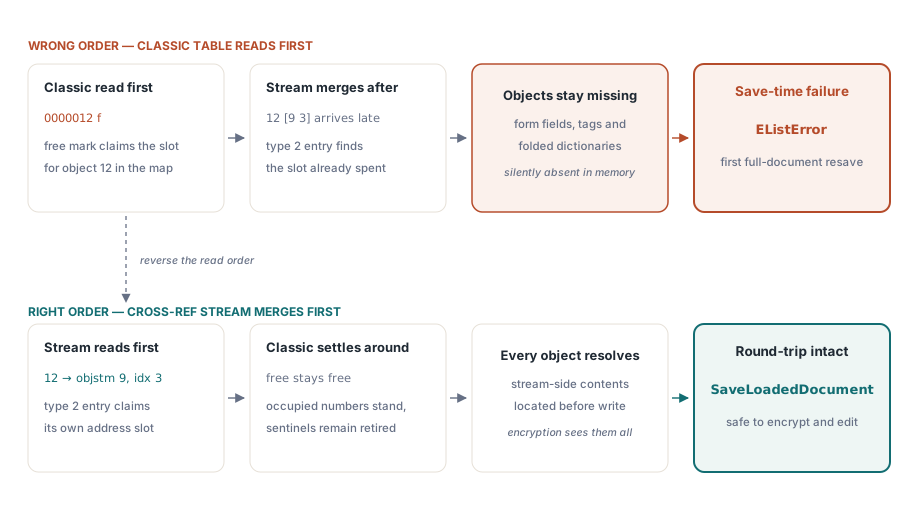
Μόλις διαβαστούν και τα δύο ευρετήρια, μπορούν να συνδυαστούν προς μία μόνο κατεύθυνση. Η ροή διασταυρούμενης αναφοράς πρέπει να συγχωνευτεί πρώτη, με τις κλασικές καταχωρίσεις να συμπληρώνονται γύρω της. Ο λόγος είναι η μικρή απάτη στην καρδιά της μορφής. Ένα υβριδικό αρχείο σημειώνει τα συμπιεσμένα αντικείμενά του ως ελεύθερα στον κλασικό πίνακα ώστε οι παλιοί αναγνώστες να τα αγνοούν. Ένας φορτωτής που τηρεί πολιτική «το πρώτο που εμφανίζεται κερδίζει» και διαβάζει πρώτα τον κλασικό πίνακα θα καταγράψει αυτούς τους αριθμούς αντικειμένων ως ελεύθερους, και έπειτα θα απορρίψει τις καταχωρίσεις ροής που πράγματι τα εντοπίζουν, επειδή οι θέσεις είναι ήδη κατειλημμένες. Αντιστρέψτε τη σειρά και οι καταχωρίσεις τύπου 2 από τη ροή, καθεμία ένας αριθμός ροής αντικειμένων συν ένας δείκτης, κερδίζουν τις θέσεις που τους ανήκουν, και οι κλασικές καταχωρίσεις τακτοποιούνται γύρω τους
Η ίδια πειθαρχία προστατεύει από το να αναστήσει μια παλαιότερη αναθεώρηση ένα διαγραμμένο αντικείμενο. Οι αυξητικές ενημερώσεις αλυσοδένονται προς τα πίσω μέσω του /Prev, και μια ελεύθερη καταχώριση τύπου 0 είναι ένας φρουρός που δηλώνει ότι μια πιο πρόσφατη ενότητα απέσυρε έναν αριθμό αντικειμένου. Μια μεταγενέστερη στην αλυσίδα, αλλά παλαιότερη, ενότητα δεν πρέπει να επιτραπεί να αντικαταστήσει αυτόν τον φρουρό με μια ξεπερασμένη θέση. Αντιμετωπίστε το «πρώτο που εμφανίζεται» ως αυθεντία για τους δείκτες ελεύθερων καταχωρίσεων και το διαγραμμένο αντικείμενο παραμένει διαγραμμένο· αντιμετωπίστε το απρόσεκτα και η ίδια η ιστορία ενός αρχείου επαναφέρει στη ζωή περιεχόμενο που η τελευταία αναθεώρηση αφαίρεσε
Τι σημαίνει αυτό στο HotPDF
Η μηχανή επιλύει τα αρχεία υβριδικής αναφοράς για εσάς, και το κάνει σε κάθε διαδρομή που πρέπει να αναλύσει τα δεδομένα διασταυρούμενης αναφοράς. Φορτώστε ένα έγγραφο με LoadFromFile ή LoadFromStream, κάντε τις αλλαγές σας και καλέστε τη SaveLoadedDocument· ή εκτελέστε μια λειτουργία μίας κίνησης όπως η EncryptFile που διαβάζει μια είσοδο και γράφει μια έξοδο. Σε κάθε περίπτωση η ανάκτηση διαβάζει το /XRefStm, συγχωνεύει την ενότητα ροής πριν από τις κλασικές καταχωρίσεις, και επιλύει τα αντικείμενα που ζουν σε ροές πριν η εγγραφή τα απαριθμήσει. Η διαδρομή κρυπτογράφησης AES-256 είναι εκεί όπου το πρόβλημα πρωτοεμφανίστηκε, επειδή η κρυπτογράφηση ενός εγγράφου ξαναγράφει κάθε αντικείμενο και άρα απαιτεί κάθε αντικείμενο να έχει ήδη εντοπιστεί
// Μία κίνηση: διαβάζει την υβριδική είσοδο, γράφει ένα κρυπτογραφημένο με AES-256 αντίγραφο
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Η λεπτομέρεια που αξίζει να κρατήσετε βρίσκεται ανάντη του API. Τα αρχεία που φτάνουν από Word, Excel, PowerPoint και μια μακριά λίστα διοχετεύσεων «Αποθήκευση ως PDF» είναι συστηματικά υβριδικά, οπότε ένας φορτωτής που δοκιμάζετε μόνο έναντι της εξόδου της δικής σας γεννήτριας μπορεί να μη συναντήσει ποτέ ένα τέτοιο στις δοκιμές. Εμπλουτίστε τα δοκιμαστικά σας δεδομένα με έγγραφα εξαγόμενα από πραγματικές εφαρμογές Office, όχι μόνο με αρχεία που παρήγαγε ο δικός σας κώδικας
Έλεγχος ενός αρχείου που υποψιάζεστε
Δύο επιθεωρήσεις ξεκαθαρίζουν γρήγορα το ερώτημα. Ανοίξτε το αρχείο σε μια δεκαεξαδική προβολή και διαβάστε τα bytes μετά το τελευταίο startxref· ένα υβριδικό αρχείο δείχνει μια σύντομη κλασική ενότητα της οποίας το λεξικό trailer περιέχει /XRefStm. Ή συγκρίνετε τον αριθμό αντικειμένων που αναφέρει μια πλήρης ανάλυση με τον υψηλότερο αριθμό αντικειμένου που δηλώνει το /Size στο trailer. Ένα μεγάλο χάσμα σημαίνει ότι αντικείμενα κρύβονται σε ροές που ο φορτωτής δεν έχει ανοίξει, που είναι το ίδιο έλλειμμα που μετατρέπεται αργότερα σε αποτυχία κατά την αποθήκευση
Η ουρά μιας τυπικής εξαγωγής Excel κάνει τον πρώτο έλεγχο απτό. Όλα όσα ακολουθούν την τελευταία λέξη-κλειδί xref είναι απλό ASCII, οπότε η υπογραφή διαβάζεται απευθείας από μια δεκαεξαδική προβολή (οι μετατοπίσεις είναι ενδεικτικές, οι σημειώσεις προστέθηκαν)
xref
0 0                          % κενή κλασική υποενότητα: καμία απολύτως γραμμή
trailer
<< /Size 216                 % ένα παραπάνω από τον υψηλότερο αριθμό αντικειμένου σε χρήση
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % μετατόπιση σε bytes της ροής διασταυρούμενης αναφοράς
>>
startxref
88710                        % δείχνει στην κλασική ενότητα παραπάνω
%%EOF
Η υποενότητα 0 0 είναι το σημάδι: ένας κλασικός πίνακας με μηδέν καταχωρίσεις υπάρχει μόνο για να μεταφέρει το trailer, και το trailer υπάρχει κυρίως για να πει /XRefStm 87325. Ένας ανιχνευτής που σταματά στη λέξη-κλειδί xref έχει, σε αυτό το σημείο, δει ένα ευρετήριο του τίποτα. Όταν προτιμάτε να γράψετε τον έλεγχο σε σενάριο αντί να τον ελέγχετε με το μάτι, ο δείκτης βρίσκεται πάντα μέσα στα τελευταία λίγα kilobytes του αρχείου, οπότε μια οριοθετημένη ανάγνωση προς τα πίσω αρκεί
// Επιστρέφει τη μετατόπιση /XRefStm από την ουρά του αρχείου, ή -1 αν ο
// δείκτης απουσιάζει (το αρχείο δεν είναι υβριδικό, ή δεν είναι καν PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // το trailer ζει στην ουρά
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // οριοθετημένη ανάγνωση προς τα πίσω: 2 KB μέγιστο
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/XRefStm'), Tail);
  if P = 0 then
    Exit;                               // κανένας υβριδικός δείκτης στην ουρά
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // παράλειψη κενών μετά το κλειδί
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Χρήση: ένα μη αρνητικό αποτέλεσμα ονομάζει το byte όπου ξεκινά η ροή
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Αντιμετωπίστε τον ανιχνευτή ως διαλογή, όχι ως αναλυτή: σας λέει ποια αρχεία σε μια παρτίδα αξίζουν προσοχή πριν τρέξει μια εργασία επαναποθήκευσης, και τίποτα περισσότερο. Τι πρέπει να κάνει έπειτα ένας φορτωτής με τη μετατόπιση που βρίσκει, ακολουθώντας την αλυσίδα ενοτήτων, συγχωνεύοντας τις καταχωρίσεις ροής πριν από τις κλασικές, σεβόμενος τους φρουρούς ελεύθερων καταχωρίσεων, περιγράφεται βήμα προς βήμα στο συνοδευτικό άρθρο μας για τον χειρισμό PDF υβριδικής αναφοράς από εφαρμογές Office
Η πλευρά της εγγραφής αυτής της ιστορίας, δηλαδή πώς παράγονται εξαρχής οι ροές αντικειμένων και οι συμπιεσμένες διασταυρούμενες αναφορές, καλύπτεται στο άρθρο μας για τις ροές αντικειμένων και τις αυξητικές ενημερώσεις. Όταν το εν λόγω υβριδικό αρχείο είναι επιπλέον πολύ μεγάλο, οι τεχνικές φόρτωσης στην αναλυτική παρουσίαση του Direct File API για ροές εργασίας μεγάλων PDF σας επιτρέπουν να το επιθεωρήσετε χωρίς να το διαβάσετε ολόκληρο στη μνήμη. Και τα δύο ταιριάζουν φυσικά με την ανάκτηση που περιγράφεται εδώ, η οποία διατίθεται ως μέρος του HotPDF Delphi Component για Delphi και C++Builder μαζί με τα API φόρτωσης, επεξεργασίας, κρυπτογράφησης και υπογραφής που καλύπτονται αλλού σε αυτό το blog