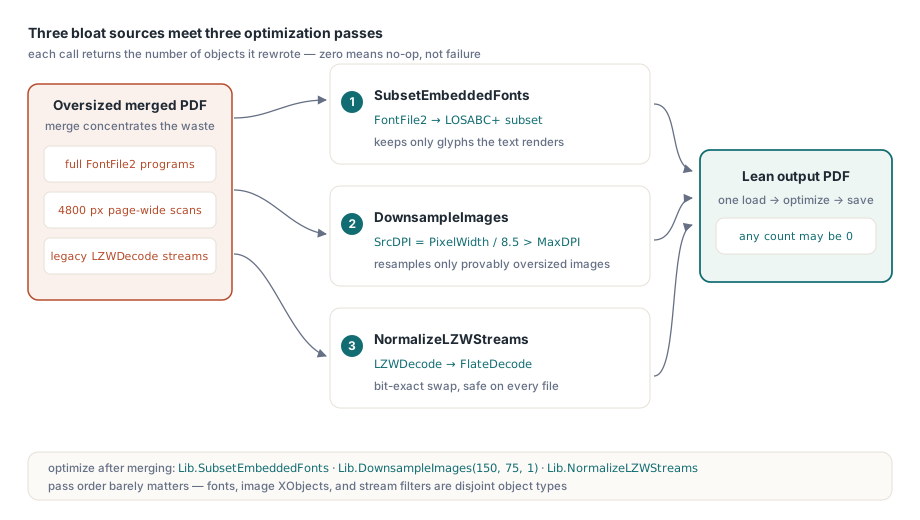
Για να μειώσετε το μέγεθος ενός αρχείου PDF στη Delphi, η losLab PDF Library παρέχει τρία API που αντιμετωπίζουν τις τρεις μεγαλύτερες πηγές διόγκωσης: η SubsetEmbeddedFonts ξαναγράφει κάθε ενσωματωμένο πρόγραμμα γραμματοσειράς TrueType περιορίζοντάς το στις γλυφές που πράγματι αποδίδει το έγγραφο, η DownsampleImages επαναδειγματοληπτεί τις εικόνες raster που υπερβαίνουν ένα DPI-στόχο, και η NormalizeLZWStreams αντικαθιστά τη συμπίεση LZWDecode παλαιού τύπου με FlateDecode. Καθεμία επιστρέφει τον αριθμό των αντικειμένων που άλλαξε, οπότε ένα μηδέν σάς λέει ότι το πέρασμα δεν είχε τίποτα να κάνει, και όχι ότι απέτυχε σιωπηλά
Γιατί το συγχωνευμένο PDF μου είναι μεγαλύτερο από τα αρχεία προέλευσής του;
Ένα συγχωνευμένο ή προγραμματιστικά παραγόμενο PDF είναι συνήθως υπερμέγεθες για έναν από τρεις λόγους: πλήρως ενσωματωμένες γραμματοσειρές, εικόνες δειγματοληπτημένες πολύ πάνω από την ανάλυση εμφάνισής τους, και ροές που παραμένουν συμπιεσμένες με το παλαιό φίλτρο LZW. Το ISO 32000-1 §9.9 επιτρέπει σε έναν παραγωγό να ενσωματώσει ολόκληρο το πρόγραμμα γραμματοσειράς, και οι περισσότεροι παραγωγοί κάνουν ακριβώς αυτό επειδή είναι η ασφαλής προεπιλογή. Ένα πλήρες FontFile2 της Arial φτάνει εκατοντάδες kilobyte· ενσωματώστε το σε μια ντουζίνα αρχεία προέλευσης, συγχωνεύστε τα, και κουβαλάτε μια ντουζίνα αντίγραφα περιγραμμάτων γλυφών για χαρακτήρες που κανείς δεν πληκτρολόγησε. Η ίδια η συγχώνευση δεν δημιουργεί τη σπατάλη, απλώς τη συγκεντρώνει σε ένα μόνο αρχείο όπου το σύνολο γίνεται επιτέλους ορατό
Οι εικόνες είναι ο δεύτερος ένοχος. Μια σάρωση πλάτους 4800 pixel τοποθετημένη σε πλαίσιο ενός τετάρτου σελίδας μεταφέρει περίπου 40 φορές περισσότερα δεδομένα pixel απ' όσα μπορεί να αξιοποιήσει μια διαδικασία εκτύπωσης 300 DPI. Ο τρίτος είναι πιο αθόρυβος: ροές φιλτραρισμένες με LZWDecode. Το ISO 32000-1 §7.4.4 προδιαγράφει τόσο το LZWDecode όσο και το FlateDecode, και σημειώνει ότι το Flate συνήθως συμπιέζει τουλάχιστον εξίσου καλά· στην πράξη η έξοδος Flate είναι σταθερά μικρότερη στα ίδια δεδομένα, και το LZW επιβιώνει κυρίως σε αρχεία που πέρασαν κάποια στιγμή της ιστορίας τους από εργαλεία της δεκαετίας του 1990. Το υπόλοιπο άρθρο παρουσιάζει τα τρία περάσματα της losLab PDF Library που διορθώνουν κάθε πρόβλημα, και έπειτα τα συνδυάζει σε μία ενιαία διαδικασία
Υποσυνολοποίηση γραμματοσειρών με τη SubsetEmbeddedFonts
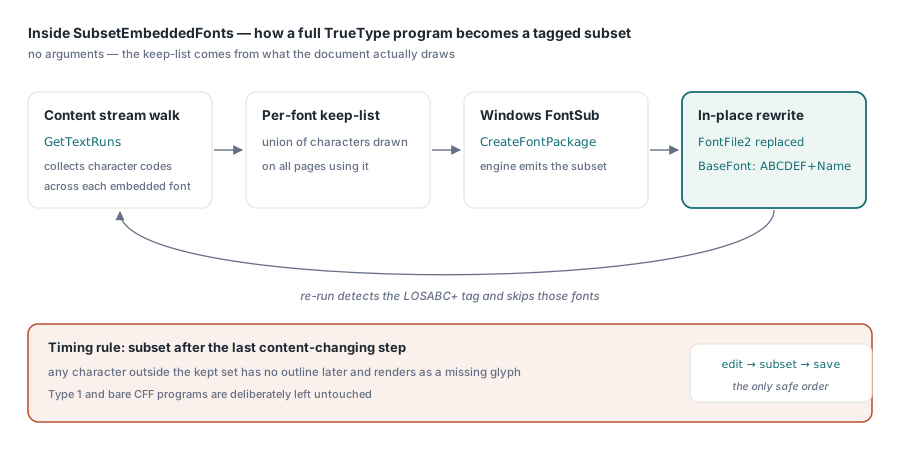
Η SubsetEmbeddedFonts συρρικνώνει κάθε ενσωματωμένη γραμματοσειρά TrueType ενός φορτωμένου εγγράφου στους χαρακτήρες που πράγματι χρησιμοποιεί το έγγραφο, και δεν χρειάζεται ορίσματα επειδή παράγει τη λίστα διατήρησης από τις ίδιες τις ροές περιεχομένου. Εσωτερικά το πέρασμα διατρέχει τη ροή περιεχομένου κάθε σελίδας με την GetTextRuns, συλλέγει τους κωδικούς χαρακτήρων που αναφέρονται κάτω από κάθε πόρο γραμματοσειράς, χτίζει μια λίστα διατήρησης, και παραδίδει το αρχικό πρόγραμμα γραμματοσειράς στη μηχανή FontSub των Windows (CreateFontPackage) για να παραχθεί ένα υποσύνολο. Το ξαναγραμμένο πρόγραμμα αντικαθιστά επιτόπου τη ροή FontFile2, και το όνομα BaseFont αποκτά μια ετικέτα LOSABC+, τη σύμβαση των έξι κεφαλαίων γραμμάτων και του συν που ορίζει το ISO 32000-1 §9.6.4 για τις γραμματοσειρές υποσυνόλου. Αυτό το πρόθεμα είναι επίσης ό,τι καθιστά την κλήση ιδιοδύναμη (idempotent): εκτελέστε το πέρασμα δύο φορές και οι ήδη υποσυνολοποιημένες γραμματοσειρές αναγνωρίζονται και παρακάμπτονται, οπότε η ενσωμάτωσή του σε μια εργασία παρτίδας που μπορεί να ξαναεπισκεφθεί αρχεία είναι ασφαλής
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = αριθμός προγραμμάτων FontFile2 που ξαναγράφτηκαν·
      // 0 σημαίνει τίποτα ενσωματωμένο, ή όλα ήδη υποσυνολοποιημένα
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Δύο λεπτομέρειες υλοποίησης αξίζει να γνωρίζετε επειδή εξηγούν τα όρια του API. Πρώτον, το πέρασμα στοχεύει το FontFile2, οπότε καλύπτει τα ενσωματωμένα προγράμματα TrueType· γραμματοσειρές ενσωματωμένες ως Type 1 ή ως σκέτο CFF μένουν ανέγγιχτες αντί να διακινδυνευθούν. Δεύτερον, βασίζεται στο FontSub, κάτι που καθιστά τη SubsetEmbeddedFonts διαθέσιμη μόνο σε Windows. Ένα πιο λεπτό σημείο από την υλοποίηση: το αν μια γραμματοσειρά πληροί τις προϋποθέσεις αποφασίζεται με πραγματική επίλυση της αλυσίδας αναφορών FontDescriptor → FontFile2, όχι με εμπιστοσύνη σε μια ευρετική σημαία ενσωμάτωσης, επειδή οι γραμματοσειρές ενός φορτωμένου εγγράφου δεν πέρασαν ποτέ από τη λογιστική της πλευράς δημιουργίας που θέτει τέτοιες σημαίες. Αν η επιλυμένη ροή υπάρχει, η γραμματοσειρά είναι υποψήφια· αν όχι, παρακάμπτεται χωρίς σφάλμα
Το ειλικρινές αντάλλαγμα: μια γραμματοσειρά υποσυνόλου περιέχει μόνο τις γλυφές που υπήρχαν τη στιγμή της υποσυνολοποίησης. Αν ένα μεταγενέστερο εργαλείο, ή ο δικός σας κώδικας, προσθέσει αργότερα κείμενο στην ίδια γραμματοσειρά, κάθε χαρακτήρας εκτός του υποσυνόλου δεν έχει περίγραμμα και θα αποδοθεί ως γλυφή που λείπει. Κάντε την υποσυνολοποίηση ως τελευταίο βήμα που αλλάζει περιεχόμενο, ποτέ πριν από ένα στάδιο επεξεργασίας. Η ίδια προσοχή ισχύει αν σκοπεύετε να εξαγάγετε αργότερα τη γραμματοσειρά για επαναχρησιμοποίηση· το άρθρο για την εξαγωγή κειμένου, εικόνων και γραμματοσειρών με την PDF Library for Delphi καλύπτει τι μπορεί και τι δεν μπορεί να σας δώσει ένα εξαγόμενο πρόγραμμα υποσυνόλου
Πώς αποφασίζει η DownsampleImages ποιες εικόνες θα συρρικνώσει;
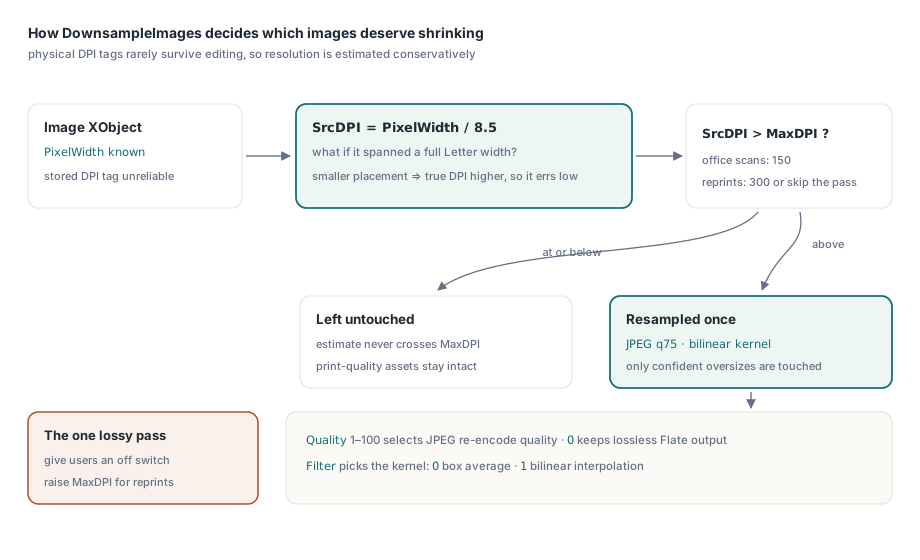
Η DownsampleImages(MaxDPI, Quality, Filter) επαναδειγματοληπτεί μόνο τις εικόνες που μπορεί με βεβαιότητα να χαρακτηρίσει υπερδειγματοληπτημένες, χρησιμοποιώντας μια σκόπιμα συντηρητική εκτίμηση DPI. Ένα XObject εικόνας PDF αποθηκεύει διαστάσεις σε pixel αλλά καμία αξιόπιστη φυσική ανάλυση, και όποια ετικέτα DPI από την εικόνα προέλευσης σπάνια επιβιώνει σε έναν κύκλο φόρτωσης-επεξεργασίας-αποθήκευσης. Έτσι το πέρασμα εκτιμά SrcDPI = PixelWidth / 8.5, ρωτώντας ουσιαστικά: αν αυτή η εικόνα κάλυπτε όλο το πλάτος μιας σελίδας Letter, ποια θα ήταν η ανάλυσή της; Μόνο οι εικόνες των οποίων η εκτίμηση υπερβαίνει το MaxDPI αγγίζονται. Η μεροληψία είναι σκόπιμη: μια εικόνα τοποθετημένη μικρή στη σελίδα έχει πραγματικό DPI υψηλότερο από την εκτίμηση, οπότε το πέρασμα ενεργοποιείται λιγότερο συχνά αντί να υποβαθμίσει ένα στοιχείο ποιότητας εκτύπωσης που δεν μπορεί να μετρήσει
Το Quality από 1 έως 100 επιλέγει την ποιότητα επανακωδικοποίησης JPEG, ενώ το 0 διατηρεί την έξοδο ως μη απωλεστικό Flate τύπου PNG· το Filter επιλέγει τον πυρήνα επαναδειγματοληψίας, 0 για μέσο όρο πλαισίου (box) και 1 για διγραμμικό. Για σαρωμένα έγγραφα γραφείου, το DownsampleImages(150, 75, 1) είναι ένα λογικό σημείο εκκίνησης· για οτιδήποτε μπορεί να ξανατυπωθεί, ανεβάστε το MaxDPI στα 300 ή παραλείψτε εντελώς το πέρασμα. Το downsampling είναι το μόνο απωλεστικό βήμα από τα τρία, οπότε ανήκει πίσω από μια ρύθμιση που οι χρήστες σας μπορούν να απενεργοποιήσουν
Μετατροπή παλαιών ροών LZW με τη NormalizeLZWStreams
Η NormalizeLZWStreams είναι το δωρεάν κέρδος: αποσυμπιέζει χωρίς απώλειες κάθε ροή LZWDecode και την επανασυμπιέζει με FlateDecode, επιτόπου, επιστρέφοντας τον αριθμό των ροών που μετατράπηκαν. Χειρίζεται τόσο μια μεμονωμένη καταχώριση /Filter /LZWDecode όσο και LZW που εμφανίζεται μέσα σε πίνακα αλυσίδας φίλτρων, όπου αντικαθίσταται μόνο ο κρίκος LZW και το υπόλοιπο της αλυσίδας διατηρείται. Οι παράμετροι predictor (Predictor, Columns, Colors, BitsPerComponent) διαβάζονται από το DecodeParms της ροής και περνούν στον αποσυμπιεστή, οπότε τα δεδομένα εικόνας με κωδικοποίηση predictor κάνουν σωστά τον κύκλο μετ' επιστροφής. Επειδή και τα δύο φίλτρα είναι codec ακριβείας bit, τα αποκωδικοποιημένα bytes είναι πανομοιότυπα πριν και μετά· αλλάζει μόνο η συμπίεση του περιέκτη, γι' αυτό και το πέρασμα αυτό είναι ασφαλές να εκτελείται ανεπιφύλακτα σε κάθε αρχείο
Σε ένα έγγραφο χωρίς ροές LZW η κλήση απλώς επιστρέφει 0 και δεν αγγίζει τίποτα, κάτι που η σουίτα παλινδρόμησης της βιβλιοθήκης ελέγχει ρητά: ένα φρεσκοδημιουργημένο αρχείο μόνο με Flate πρέπει να αναφέρει μηδέν μετατροπές. Αυτή η εγγύηση μη-λειτουργίας έχει σημασία όταν το πέρασμα βρίσκεται σε μια διαδικασία που επεξεργάζεται χιλιάδες ετερογενή αρχεία, άλλα από το 2024 και άλλα από το 1998
Η πλήρης διαδικασία βελτιστοποίησης μεγέθους στη Delphi
Τα τρία περάσματα συνδυάζονται σε μία συνάρτηση φόρτωσης-βελτιστοποίησης-αποθήκευσης, και η σειρά έχει μικρότερη σημασία απ' όση ίσως περιμένετε, επειδή λειτουργούν σε ξένους μεταξύ τους τύπους αντικειμένων: γραμματοσειρές, XObject εικόνων και φίλτρα ροών. Η εκτέλεση της υποσυνολοποίησης πρώτα παραμένει η τακτοποιημένη επιλογή, αφού είναι το πέρασμα με περιορισμό σειράς επεξεργασίας
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> υποσύνολο
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, διγραμμικό
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Καταγράψτε Fonts/Images/Streams: τρία μηδενικά σημαίνουν ότι το αρχείο ήταν ήδη λιτό
  finally
    Lib.Free;
  end;
end;
Επαληθεύστε τη διαδικασία όπως επαληθεύει τον εαυτό της η βιβλιοθήκη: με κύκλο μετ' επιστροφής. Οι δοκιμές παλινδρόμησης της v3.130 δημιουργούν ένα έγγραφο, το αποθηκεύουν, το ξαναφορτώνουν, εκτελούν τη βελτιστοποίηση, αποθηκεύουν ξανά, και έπειτα επιβεβαιώνουν τρία πράγματα: η έξοδος είναι μικρότερη, οι επιστρεφόμενοι αριθμοί ταιριάζουν με τις προσδοκίες, και μια επαναφόρτωση του βελτιστοποιημένου αρχείου εξακολουθεί να αναλύεται και να αποδίδεται. Η αναπαραγωγή αυτού του βρόχου δημιουργίας-βελτιστοποίησης-επαναφόρτωσης σε ένα δείγμα των δικών σας αρχείων παραγωγής, και η σύγκριση του εξαγόμενου κειμένου πριν και μετά, είναι μια επένδυση μίας ώρας που εντοπίζει λάθη ενσωμάτωσης πολύ πριν ένας πελάτης ανοίξει ένα χαλασμένο τιμολόγιο
// Έλεγχος κύκλου μετ' επιστροφής: το βελτιστοποιημένο αρχείο πρέπει να φορτώνει ακόμη καθαρά
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Πού ταιριάζει η διαδικασία σε μια ροή εργασίας συγχώνευσης; Μετά τη συγχώνευση, όχι κατά τη διάρκειά της. Το να συγχωνεύσετε πρώτα και να βελτιστοποιήσετε το ενιαίο αποτέλεσμα σημαίνει ότι κάθε ενσωματωμένη γραμματοσειρά υποσυνολοποιείται μία φορά έναντι της ένωσης όλων των χρησιμοποιούμενων χαρακτήρων, αντί ανά αρχείο προέλευσης. Αν η απόδοση της συγχώνευσης είναι το σημείο συμφόρησης, η PDF Library for Delphi προσφέρει μια γρήγορη διαδρομή σε επίπεδο byte που αποφεύγει την πλήρη ανάλυση αντικειμένων, η οποία περιγράφεται στο άρθρο για τη γρήγορη συγχώνευση PDF με μετατόπιση αναφορών byte· και για εισόδους πολύ μεγάλες για να χωρέσουν ολόκληρες στη μνήμη, το συγχώνευση και διαχωρισμός μεγάλων PDF με άμεση πρόσβαση καλύπτει τη διαδρομή ροής. Και τα δύο συνδυάζονται φυσικά με ένα τελικό πέρασμα βελτιστοποίησης στη συγχωνευμένη έξοδο
Τι δεν θα κάνουν τα τρία περάσματα
Η τριάδα βελτιστοποίησης της losLab PDF Library αποκλείει σκόπιμα οτιδήποτε αλλάζει τη σημασιολογία του εγγράφου. Η SubsetEmbeddedFonts δεν ενοποιεί διπλότυπες γραμματοσειρές από συγχωνευμένες πηγές σε ένα πρόγραμμα, συρρικνώνει καθεμία ανεξάρτητα· η αποδιπλοτύπηση είναι διαφορετικός, πιο ριψοκίνδυνος μετασχηματισμός. Η DownsampleImages θα προσπεράσει μια εικόνα της οποίας η συντηρητική εκτίμηση DPI μένει κάτω από το κατώφλι, ακόμη κι όταν ένας άνθρωπος θα έβλεπε ότι είναι υπερμεγέθης για το πλαίσιό της. Και κανένα από τα περάσματα δεν αγγίζει τη δομή του εγγράφου, οπότε ένα αρχείο διογκωμένο από χιλιάδες ορφανά αντικείμενα χρειάζεται μια αποθήκευση τύπου επανεγγραφής και όχι αυτά τα περάσματα επιπέδου ροής. Μέσα σε αυτά τα όρια, ο συνδυασμός υποσυνολοποίησης γραμματοσειρών, downsampling εικόνων και κανονικοποίησης LZW-σε-Flate αφαιρεί τις τρεις κλασικές πηγές διόγκωσης PDF με μία προβλέψιμη κλήση API η καθεμία. Οι τρεις συναρτήσεις διατίθενται ως μέρος της losLab PDF Library για Delphi, C# και VB.NET, μαζί με τα API συγχώνευσης, εξαγωγής και απόδοσης που συζητήθηκαν παραπάνω