Eine Suche nach "two-x" in einem frisch erzeugten PDF kann null Treffer liefern, während die Seite diese fünf Zeichen offensichtlich zeigt. Den extrahierten String als Codepunkte ausgeben, und der Grund liegt offen da: Der Bindestrich kam als U+00AD SOFT HYPHEN zurück, und das Leerzeichen danach als U+00A0 NO-BREAK SPACE. Beide sehen auf dem Bildschirm identisch aus. Der Unterschied lebt in der ToUnicode-CMap, der Tabelle, die ein Reader konsultiert, um Zeichencodes zurück in Unicode zu übersetzen, und er rührt daher, dass eine Font-Glyphe von zwei Codepunkten geteilt wird
String-Werkzeuge aus der Schublade machen die Diskrepanz schlimmer. Ein CSV-Export bricht die Zeile anders um, ein Diff-Tool markiert zwei Zeilen, die in jedem Viewer gleich lesen, und eine Rechtschreibprüfung hält "two-x" mit Soft Hyphen für ein unbekanntes Wort. Unicode-Normalisierung rettet nur zur Hälfte: NFKC faltet U+00A0 in ein gewöhnliches Leerzeichen, weil NBSP eine Kompatibilitätsdekomposition trägt, aber U+00AD hat gar keine Dekomposition, der Soft Hyphen überlebt also jede Normalisierungsform
Warum werden extrahierte Leerzeichen zu U+00A0?
Extrahierte Leerzeichen werden zu U+00A0, wenn die ToUnicode-CMap über Glyphen keyt und eine Glyphe von zwei Codepunkten erreichbar ist. In Arial dient Glyphe 3 sowohl U+0020 als auch U+00A0, und die Bindestrich-Glyphe dient sowohl U+002D als auch U+00AD. Eine CMap, die von der Glyphen-Seite gebaut wird, muss etwas über CID 0003 sagen, und PDFiums Generator in FPDFText_LoadFont sagt am Ende zwei Dinge: einen bfchar-Eintrag, der ihn auf U+0020 mappt, und einen Array-Form-bfrange, der denselben CID auf U+00A0 mappt
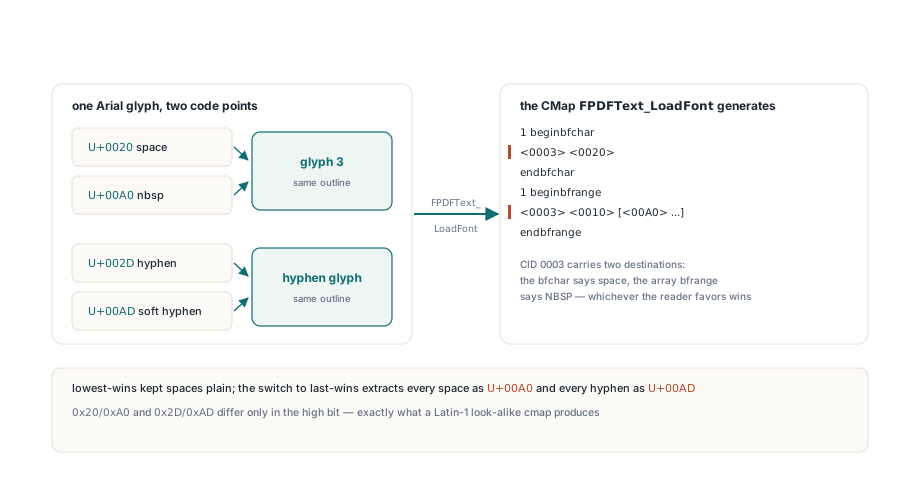
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 beschreibt, wie bfchar und bfrange Codes auf Unicode mappen, sagt aber nicht, welcher Eintrag gewinnt, wenn zwei denselben CID beanspruchen. Reader wählen eine Präzedenz-Regel ihrer Wahl. Ein Reader, der die niedrigste oder erste Zuordnung behält, extrahiert ein schlichtes Leerzeichen; PDFiums Reader behält den letzten, und da der Array-Bereich auf den bfchar-Block folgt, extrahiert jedes durch eine glyphen-gekeyte CMap geschriebene Leerzeichen als NBSP und jeder Bindestrich als Soft Hyphen. Derselbe Text kann daher in zwei Viewern derselben Datei unterschiedlich extrahieren
Die Paare folgen einem Muster. 0x20/0xA0 und 0x2D/0xAD unterscheiden sich nur im High-Bit, was ein Font dann produziert, wenn seine cmap Latin-1-Zwillinge auf die Outline mappt, die bereits für das ASCII-Zeichen benutzt wird. Griechisches großes Omega (U+03A9) und das Ohm-Zeichen (U+2126) teilen sich in Arial ebenfalls eine Glyphe. Wenn Extraktionscode, der bisher durchlief, plötzlich an unsichtbaren Zeichen scheitert, geben Sie die Codepunkte aus statt dem String-View des Debuggers zu vertrauen; die Grundlagen des Textlesens aus einer Seite stehen in Text aus PDF-Dokumenten mit PDFium in Delphi extrahieren
Wie PDFium Component Systemfonts über Codepunkte keyt
PDFium Component bittet die Engine nie darum, jene CMap für Systemfonts zu erzeugen, die eine Unicode-cmap tragen. Wenn TPdf.AddText einen Font braucht, liest die Komponente die sfnt-cmap-Tabelle des Fonts, bevorzugt eine Format-12-Subtable und fällt auf Format 4 zurück. Die Codepunkte kommen sortiert und dedupliziert zurück, und CID k+1 wird dem k-ten Codepunkt zugewiesen, CID 0 bleibt .notdef. Eine explizite CIDToGIDMap leitet jeden CID an seine Glyphe weiter. U+0020 und U+00A0 bekommen also zwei verschiedene CIDs, die dieselbe Outline zeichnen, und die ToUnicode-CMap, die die Komponente schreibt, mappt jeden CID auf genau einen Codepunkt
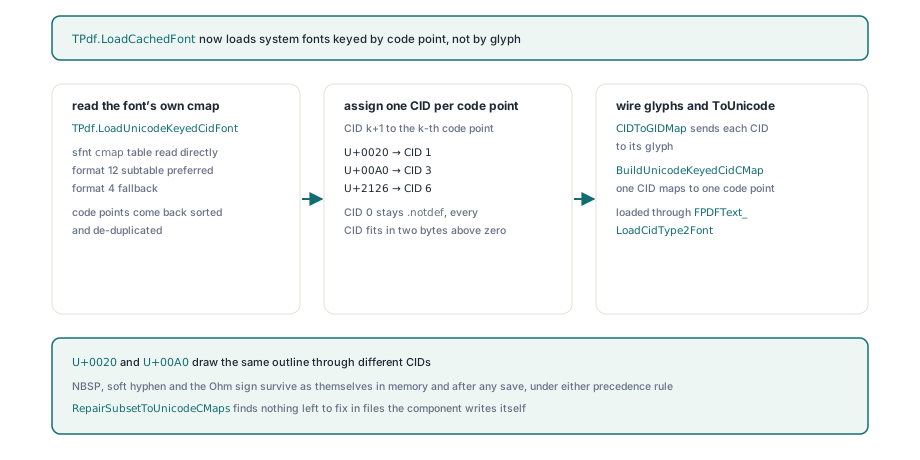
Der Font wird über FPDFText_LoadCidType2Font geladen, denselben Einstiegspunkt, der hinter dem Glyphen-Level-Schreiben in CID-Type-2-Font-Einbettung mit expliziten CID-zu-GID-Maps steckt. Wenn FPDFText_SetText später einen String schreibt, landet die Rückwärtssuche auf genau einem CID pro Zeichen. Nichts daran hängt an der Präzedenz-Regel des Readers, denn es gibt keine zweite Zuordnung, zwischen der die Regel wählen könnte. Die gespeicherte Datei trägt zudem den eigenen ToUnicode-Stream der Komponente, also sieht die Extraktion nach dem Reload dieselbe Eins-zu-Eins-Tabelle, die das Live-Dokument benutzt hat
Der Preis ist eine größere CIDToGIDMap: zwei Bytes pro Codepunkt, den der Font abdeckt. Angenommen, ein Font mappt rund 3.000 Codepunkte. Die Map kommt dann auf etwa 6 KB, übergeben an die Engine mit jedem Font. Dieser Trade ist es jedes Mal wert. Ein paar Kilobytes kaufen eine Extraktion, die in PDFium gleich liest, in Viewern, die die erste Zuordnung behalten, und in welchem Indexer auch immer Ihr Kunde nächstes Jahr läuft
Der Round-Trip unten schreibt einen String, der jedes der Problem-Paare enthält, extrahiert ihn aus dem ungespeicherten Dokument, speichert, lädt neu und extrahiert erneut. Beide Strings sollten exakt der Eingabe entsprechen; der CodePoints-Helper existiert nur, damit eine Abweichung lesbar wird:
uses
  SysUtils, PDFium;

const
  // Leerzeichen/U+00A0 und Bindestrich/U+00AD teilen eine Arial-Glyphe,
  // ebenso Griechisch Omega (U+03A9) und das Ohm-Zeichen (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // live, ungespeichertes Dokument
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // nach vollem Speichern und Reload
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Behalten Sie NBSP und Soft Hyphen im Sample-String, selbst wenn Ihre Dokumente sie selten enthalten. Ein Test, der nur ASCII schreibt, besteht auch gegen eine glyphen-gekeyte CMap, denn nichts darin bittet den Reader je, zwischen zwei Zuordnungen zu wählen
Warum kann ein einzelner bfrange-Eintrag einen ganzen Block auslöschen?
Ein einzelnes bfrange, dessen CID-Run eine xxFF-Grenze überschreitet, bringt PDFium dazu, den gesamten Block zu verwerfen, in dem es sitzt. ISO 32000-1 §9.10.3 erlaubt nur dem letzten Byte des Ziels, innerhalb eines Bereichs zu variieren, und auf der CID-Seite lauert in PDFiums Parser die passende Falle: Er leitet den hohen CID als (low and $FFFFFF00) or (high and $FF) her. Ein Run von CID 00FE bis 0101 wird als 00FE bis 0001 gelesen, low größer als high, und der ganze Block wird als ungültig markiert. SetText gelingt, die Seite rendert korrekt, und die Extraktion liefert U+0000 für jedes Zeichen in diesem Block
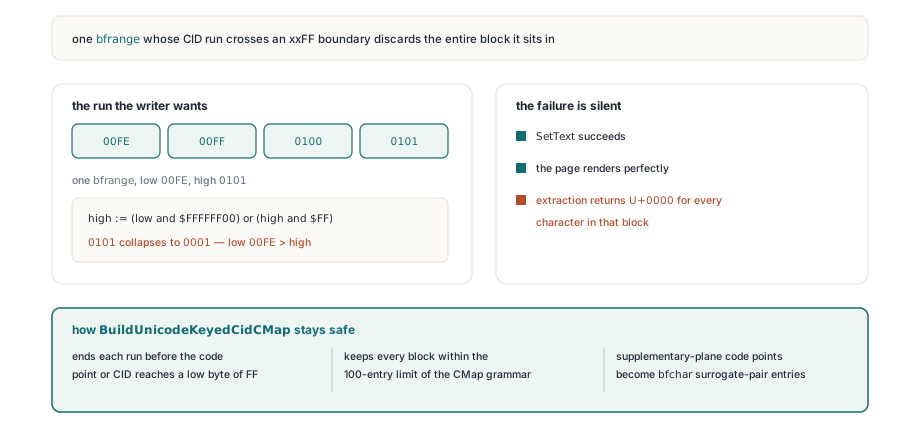
Ein codepunkt-gekeyter Font ist genau der Ort, an dem das beißt. CIDs sind dicht und sequenziell, also erzeugt jeder Font mit mehr als 255 Codepunkten CID-Runs, die 00FF, 01FF und so weiter überschreiten würden, würde der Writer einfach aufeinanderfolgende Einträge mergen. Die CMap, die PDFium Component schreibt, beendet einen Run, bevor Codepunkt oder CID ein Low-Byte von FF erreichen, und sie teilt die Einträge in Blöcke von höchstens 100, das Limit, das die CMap-Grammatik jeder beginbfrange- und beginbfchar-Sektion setzt
Codepunkte über U+FFFF bekommen einzelne bfchar-Einträge, deren Ziele UTF-16-Surrogatpaare sind, denn das Inkrementieren eines Surrogatpaars innerhalb eines Bereichs hat keine definierte Bedeutung. Die Surrogat-Seite der Geschichte steht in Emoji-, CJK- und Surrogatpaar-Behandlung in Delphi. Eine reine bfchar-CMap würde das Grenzproblem komplett umgehen, bei mehrfacher Größe, deshalb bleiben Ranges die Hauptform und die Split-Regeln tragen die Last
ToUnicode-Konflikte in Dateien aus anderen Tools reparieren
RepairSubsetToUnicodeCMaps in der Unit FPdfCompress fixt den glyphen-gekeyten Konflikt in Dateien, die die Komponente nicht selbst geschrieben hat. TPdf.SaveAs führt sie bei jedem vollen, nicht-inkrementellen Speichern aus, und Sie können sie direkt auf jeden Stream aufrufen. Für jeden CID mit zwei Zielen gewinnt der bfchar-Eintrag. Ohne bfchar für den CID löst sich ein Paar, das sich nur im High-Bit unterscheidet, auf den kleineren Basis-Latin-Codepunkt auf. Jeder andere Konflikt behält seine erste Zuordnung
Die Reparatur editiert die konfligierenden Hex-Werte an Ort und Stelle, mit gleich langen Ersetzungen. Block-Layout, CID-Abdeckung und jedes andere Byte des Streams bleiben, wie sie waren, die CMap bleibt also in der Form, die PDFiums Reader bereits akzeptiert hat. Eine sauber neu gebaute CMap sähe im Hex-Report ordentlicher aus. Sie würde auch die Struktur eines Streams ändern, den ein strenger Reader bereits akzeptiert hat, und das ist ein Risiko ohne Aufwärtspotenzial, wenn nur eine Handvoll Zielwerte falsch ist
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Nur gleichlange Edits; Dateien ohne reparierbaren Konflikt,
      // und Cross-Reference-Stream- oder Object-Stream-Dateien werden 1:1 kopiert
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
Die Routine baut eine klassische Cross-Reference-Tabelle neu, also laufen Dokumente mit Cross-Reference-Streams, hybriden Referenzen oder Object-Streams Byte für Byte durch. Inkrementelle Saves (saIncremental) überspringen die Reparatur by Design, denn eine inkrementelle Revision muss append-only bleiben. Für Text, den die Komponente selbst schreibt, spielt beides keine Rolle: Ihre codepunkt-gekeyten Fonts erzeugen nie einen Konflikt, den die Reparatur finden könnte
Wann der codepunkt-gekeyte Weg greift
Der codepunkt-gekeyte Weg deckt jeden Font ab, der eine Unicode-cmap-Subtable exponiert, und PDFiums glyphen-gekeytes Laden erledigt den Rest. Details, die man kennen sollte, bevor man sich darauf verlässt:
- Symbolfonts, die nur eine (3,0)-cmap tragen, und jeder Font, den der CID-Pfad nicht laden kann, laufen über
FPDFText_LoadFont, wo eine Glyphe, die zwei Codepunkten dient, der Präzedenz-Regel des Readers unterliegt - Mit nur einer Format-4-Subtable deckt die Map die Basic Multilingual Plane ab; eine Format-12-Subtable auf Plattform (3,10) oder der Unicode-Plattform ergänzt Supplementary-Plane-Codepunkte
- Glyphe 0 und Surrogat-Codepunkte bleiben aus, und die Eintragsanzahl ist auf 65535 gedeckelt, sodass jeder CID in zwei Bytes über Null passt
- TrueType Collections brauchen besondere Sorgfalt: GDI-
GetFontDataliefert das ganze .ttc, undFPDFText_LoadCidType2Fonthat keinen Face-Index-Parameter, also würde das Durchreichen der Collection Face 0 einbetten, SimSun, obwohl Sie NSimSun aus simsun.ttc angefragt haben. Die Komponente gleicht den Familiennamen mit der Name-Tabelle des Fonts ab (nameID 1 und 16) und übergibt die angefragte Face als eigenständiges sfnt; eine Collection, die sie nicht parsen kann, wird komplett durchgereicht und nutzt Face 0 - Lässt sich kein Systemfont des angefragten Namens lesen, reicht
AddTextden Fontnamen anFPDFPageObj_NewTextObjweiter, der ihn unter PDFiums Standardfonts nachschlägt
Unsichtbare Zeichen im Index falten, im Text behalten
Sobald die Extraktion die echten Codepunkte liefert, kommt eine andere Frage auf: Was soll ein Suchindex mit einem echten NBSP oder Soft Hyphen anfangen, den der Autor bewusst getippt hat? Falten Sie sie in der Indexierungs-Schicht und lassen Sie TPdf.Text in Ruhe. Der extrahierte String ist das Protokoll dessen, was das Dokument sagt; ein Index ist eine verlustbehaftete Sicht, gebaut zum Matchen, und die Faltregeln gehören zu ihm
Der Helper unten ist eine Funktion, die Sie zu Ihrem eigenen Code hinzufügen. Er mappt NBSP auf ein Leerzeichen und wirft den Soft Hyphen weg, der laut Unicode Standard nur eine Stelle markiert, an der eine Zeile umbrechen darf. U+2126 lässt er bewusst unangetastet. NFC-Normalisierung würde das Ohm-Zeichen in Omega verwandeln, denn U+2126 hat eine kanonische Singleton-Dekomposition auf U+03A9, und ob eine Datasheet-Suche die beiden matchen sollte, ist eine Produktentscheidung, keine Extraktionsfrage:
uses
  SysUtils, Classes, PDFium;

// Ihr eigener Helper für einen Suchindex; kein Teil von PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // der exakte Text bleibt in Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Lassen Sie IndexDocument über die codepoints.pdf-Datei aus dem ersten Beispiel laufen, und die indexierte Zeile sollte "two-x yz ΩΩ" lesen, elf Zeichen mit einem Ohm-Zeichen als letztem, während Pdf.Text weiterhin alle zwölf Original-Zeichen liefert, NBSP und Soft Hyphen inklusive
Codepunkt-gekeyte Fonts, die CMap-Reparatur und Textextraktion sitzen alle auf demselben Seiten-Modell in Delphi, C++Builder und Lazarus; die Font- und Text-API ist auf der Produktseite PDFium Component for Delphi vollständig dokumentiert