veraPDF kassiert einen getaggten Quartalsreport wegen ISO 14289-1 §7.21.8, weil ein einziger Tj-Operator die Bytes <0000> zeigt, was unter Identity-H CID 0 heißt, die .notdef-Glyph. Diese Klausel und ihre Nachbarin §7.21.6, die die Glyph-Namen begrenzt, die ein TrueType-/Differences-Array benutzen darf, tauchen in Delphi als separate Flags im Ergebnis von PDFium Components TPdf.ValidatePdfUa auf
Welche Textoperatoren referenzieren die .notdef-Glyph?
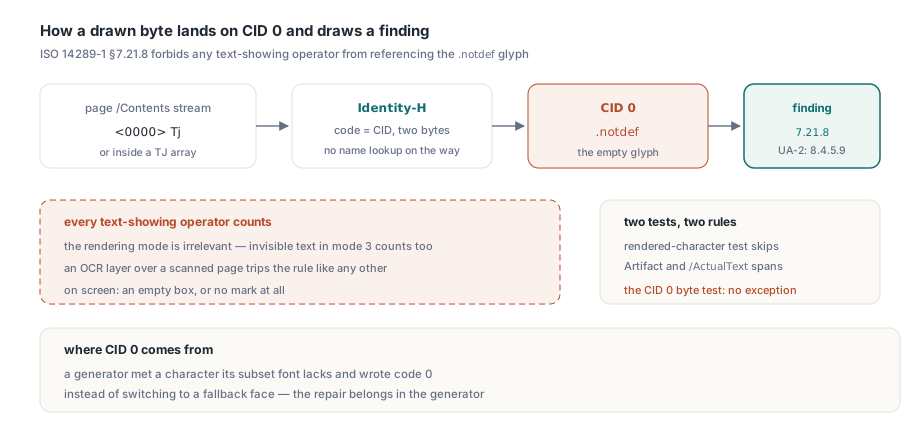
Jeder Text-Show-Operator, dessen Operand auf Glyph 0 mappt, tut es. In einem Simple Font ist .notdef ein Glyph-Name. In einem CID-keyed Font fällt dieselbe Rolle CID 0 zu, und ISO 32000-2 §9.7.4.2 verlangt von jedem CIDFont eine Glyph-Beschreibung für CID 0 "analogous to the .notdef character name in simple fonts". Bei der üblichen Identity-H-Encodierung sind Zeichencode und CID dieselben zwei Bytes, also zeichnet ein Content Stream, der <0000> mit Tj oder innerhalb eines TJ-Arrays zeigt, CID 0. ISO 14289-1 §7.21.8 verbietet jedem Text-Show-Operator genau das, und PDF/UA-2 stellt dieselbe Anforderung in §8.4.5.9. Der Text-Rendering-Mode ist egal. Unsichtbarer Text in Mode 3, etwa die OCR-Ebene über einer gescannten Seite, zählt mit. Auf dem Bildschirm ist das Ergebnis meist eine leere Box von ein paar Punkten Breite oder gar keine Marke, und beides sagt einem sehenden Korrektor nicht, dass ein Zeichen verschwunden ist
Die übliche Quelle ist ein Generator, der auf ein Zeichen traf, das seinem Subset-Font fehlte, und Code 0 schrieb, wo er auf eine Fallback-Schrift hätte umschalten sollen. Das macht die Byte-Prüfung erfreulich präzise. Dekodieren Sie nur die Streams, die das /Contents jeder Seite referenziert, suchen Sie nach <0000>, das an Tj oder TJ verfüttert wird, in einem Dokument, das Type-0-Fonts benutzt, und lassen Sie Bilder, ICC-Profile und CMaps komprimiert. Ein Parsing-Detail entscheidet, ob Sie die Seiten überhaupt finden. ISO 32000-1 §7.3.5 beendet ein Name-Token am nächsten Delimiter, also ist /Type/Page ohne Leerzeichen ein gültiges Page-Dictionary, und eine Suche nach der Form mit Leerzeichen, /Type /Page, überspringt es. /.notdef in einem Differences-Array zu nennen stolpert nicht von sich aus über diese Regel; erst das Zeigen eines Codes, der auf diesen Slot landet, tut es
Welche /Differences-Glyph-Namen gelten als Unicode-konform?
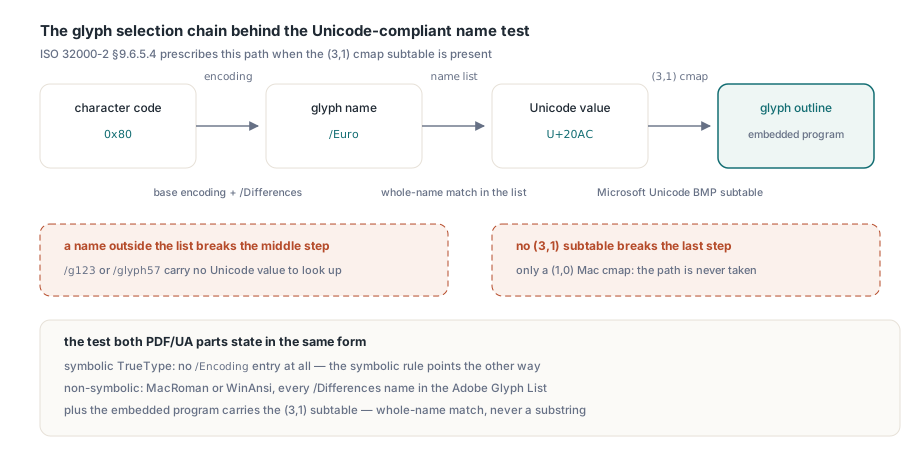
Namen, die in der Adobe Glyph List stehen, sofern das eingebettete Font-Programm zusätzlich eine (3,1)-cmap-Subtable enthält. Der Hintergrund ist ISO 32000-2 §9.6.5.4, das einem nicht-symbolischen TrueType-Font MacRomanEncoding oder WinAnsiEncoding ohne Differences-Array empfiehlt; PDF/UA macht aus diesem Rat eine Anforderung mit einem einzigen Escape-Hatch. Beide PDF/UA-Teile formulieren den Test in derselben Form, die veraPDF anwendet: Der Font ist symbolisch, oder seine Encodierung ist MacRoman oder WinAnsi und hat entweder kein /Differences-Array oder jeder Name in diesem Array ist Unicode-konform. Die (3,1)-Bedingung folgt aus der Glyph-Auswahlreihenfolge, die §9.6.5.4 vorschreibt, wenn diese Subtable (Microsoft-Plattform, Unicode-BMP) vorliegt. Der Zeichencode geht über die Encodierung zum Glyph-Namen, der Glyph-Name über die Adobe Glyph List zu Unicode, und Unicode über die (3,1)-Subtable zur Glyph. Ein Name außerhalb der Liste bricht den mittleren Schritt, und ein Font ohne die Subtable nimmt diesen Pfad nie. Die Symbolic-Font-Regel zeigt in die andere Richtung: Ein symbolischer TrueType-Font darf gar keinen /Encoding-Eintrag tragen
| Font-Dictionary | Ergebnis |
|---|---|
Nicht-symbolisch, /Encoding /WinAnsiEncoding, ohne Differences | Besteht |
Nicht-symbolisch, WinAnsi-Basis, Differences mit /Euro /bullet /.notdef, Font hat eine (3,1)-cmap | Besteht |
Nicht-symbolisch, Differences mit /g123 oder /glyph57 | Scheitert: Namen nicht in der Glyph-Liste |
| Nicht-symbolisch, gültige Differences, eingebetteter Font hat nur eine (1,0)-Mac-cmap | Scheitert: keine (3,1)-Subtable |
Nicht-symbolisch, WinAnsi-Basis mit Differences, kein FontFile2 eingebettet | Von dieser Regel nicht entschieden; die Embedding-Regel (§7.21.4) kassiert sie |
Nicht-symbolisch, kein /Encoding-Eintrag | Scheitert |
Symbolisch, ein /Encoding-Eintrag | Scheitert an der Symbolic-Regel |
An der zweiten Zeile scheitern selbstgebaute Glyph-Listen. Die Liste, die veraPDF mit seinem Font-Code ausliefert, font/AdobeGlyphList.txt, hat 4.282 Einträge, und ihre erste Zeile ist .notdef 0000. Von Hand zusammengestellte oder aus anderen Quellen genommene Tabellen missen diesen Eintrag oft, weil .notdef für kein echtes Zeichen steht. Ein Prüfer auf so einer Tabelle meldet jeden Font, dessen Differences-Array /.notdef erwähnt — einen Namen, der in Subset-Fonts regelmäßig auftaucht, die ungenutzte Slots damit füllen. Gematcht wird auf den ganzen Namen. Eine Teilstring-Suche würde /grav akzeptieren, nur weil /grave in der Liste steht. Füllen Sie ungenutzte Differences-Slots getrost mit .notdef; ein Prüfer, der veraPDF folgt, akzeptiert das
Font-Regeln richten sich nach den Bytes, die der Producer schrieb
Ein naheliegender Shortcut ist, eine normalisierte Kopie des Dokuments zu speichern und diese zu scannen, weil eine neu geschriebene Datei leichter zu parsen ist. Bei Font-Regeln scheitert das. Jedes Tool, das ein PDF neu serialisiert, darf Font-Dictionarys neu bauen: ein Differences-Array in eine frische Encodierung falten, Glyphen umbenennen, Objekte neu nummerieren. Eine Encodierungsregel muss also gegen die Bytes geprüft werden, die der Producer schrieb. TPdf.ValidatePdfUa fährt seine Font-Tests auf der Datei oder dem Speicherpuffer, die es geladen hat, und dekodiert FontFile2-Streams direkt, um zum TrueType-Table-Directory zu gelangen. Der Test auf Zeichenebene (mappt ein gezeichnetes Zeichen auf Unicode 0?) benutzt den Text, den die Seite rendert, und überspringt als Artifact markierte Inhalte oder solche unter /ActualText; der CID-0-Byte-Test macht keine solche Ausnahme. Die Befunde kommen als separate Werte im Issue-Set an, also kann ein Report sagen, welche Regel zugeschlagen hat:
uses
  SysUtils, PDFium, FPdfPdfua;

procedure ReportFontFindings(const FileName: string);
const
  FontIssues: TPdfUaValidationIssues = [pvuaiPdfiumNotDefGlyph,
    pvuaiTrueTypeEncodingInvalid, pvuaiSymbolicTrueTypeEncoding,
    pvuaiFontNotEmbedded, pvuaiFontMissingToUnicode];
var
  Pdf: TPdf;
  Report: TPdfUaValidationResult;
  Found: TPdfUaValidationIssues;
  Coverage: TPdfUaUnicodeCoverageReport;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);
    Report := Pdf.ValidatePdfUa;
    Found := Report.Issues * FontIssues;
    if pvuaiPdfiumNotDefGlyph in Found then
    begin
      Writeln('Text references .notdef / CID 0 (7.21.8, 8.4.5.9)');
      // Gerenderte Zeichen lokalisieren, die auf keinen Unicode-Wert mappen
      Coverage := Pdf.InspectPdfUaUnicodeCoverage;
      for I := 0 to High(Coverage.Objects) do
        if Coverage.Objects[I].MissingUnicodeCharacterCount > 0 then
          Writeln(Format('  page %d, object %d: %d character(s)',
            [Coverage.Objects[I].PageNumber,
             Coverage.Objects[I].PageObjectIndex,
             Coverage.Objects[I].MissingUnicodeCharacterCount]));
    end;
    if pvuaiTrueTypeEncodingInvalid in Found then
      Writeln('Non-symbolic TrueType encoding or Differences (7.21.6, 8.4.5.7)');
    if pvuaiSymbolicTrueTypeEncoding in Found then
      Writeln('Symbolic TrueType font carries an /Encoding entry');
    if pvuaiFontNotEmbedded in Found then
      Writeln('A font program is not embedded (7.21.4)');
    if pvuaiFontMissingToUnicode in Found then
      Writeln('A font has no usable Unicode mapping (7.21.7)');
    if Found = [] then
      Writeln('No font findings');
    // Erwartet für eine Datei, deren einziger Fehler /g123 in einem Differences-Array ist:
    // die eine 7.21.6-Zeile
  finally
    Pdf.Free;
  end;
end;
Reparaturen gehören in das Programm, das die Datei schrieb
Keiner der beiden Befunde lässt sich hinterher sicher durch Bearbeiten eines Dictionarys reparieren. Eine CID-0-Referenz heißt, ein Zeichen hatte in der benutzten Schrift keine Glyph, also braucht der Generator eine Fallback-Schrift für dieses Zeichen. <0000> in einen anderen Code umzuschreiben würde eine beliebige Glyph zeichnen und ihr den falschen Unicode-Wert anhängen. Ein Differences-Array mit Namen wie /g123 stammt meist vom Subsetten eines Fonts, dessen Glyphen keine Standardnamen tragen. Die saubere Reparatur ist, diese Schrift als CID-keyed TrueType-Font einzubetten, das Setup aus CID Type 2 Font Embedding, mit Identity-H und einer /ToUnicode-CMap. Das nimmt die Simple-Font-Encodierungsregel aus dem Spiel
Das Symbolic-Flag zu setzen, um §7.21.6 loszuwerden, ist der falsche Zug. Ein symbolischer TrueType-Font darf gar kein /Encoding tragen. Die Differences-Namen, die einem Screen Reader sagten, welches Zeichen jeder Code darstellt, verschwinden mit ihm, und jeder Viewer wählt dann Glyphen nach rohem Code über die (3,0)- oder (1,0)-Subtable. Das Flag ist weg. Die Bedeutung des Texts geht mit
Hat das eingebettete Font-Programm eine (3,1)-cmap?
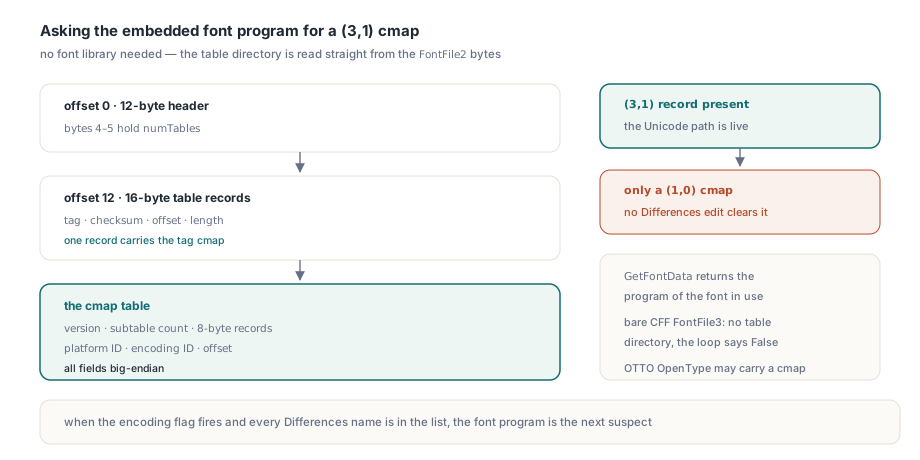
Fragen Sie das Font-Programm direkt, denn das Encodierungs-Flag deckt beide Hälften des Tests ab und kann nicht sagen, welche gescheitert ist. Wenn es zuschlägt und jeder Differences-Name in der Liste steht, ist das Programm der nächste Verdächtige. Eine TrueType-Datei beginnt mit einem 12-Byte-Header, dessen Bytes 4–5 die Tabellenzahl halten, gefolgt von 16-Byte-Table-Records (Tag, Checksumme, Offset, Länge). Die cmap-Tabelle beginnt mit einer Version und einer Subtable-Zahl, gefolgt von 8-Byte-Records aus Plattform-ID, Encodierungs-ID und Offset, alles Big-Endian. Keine Font-Bibliothek nötig. TPdf.GetFontData gibt das eingebettete Programm des Fonts zurück, den ein Seitenobjekt benutzt, also kann der Helper über jedes Textobjekt einer Seite laufen:
function BE16(const B: TBytes; P: Integer): Integer;
begin
  Result := (B[P] shl 8) or B[P + 1];
end;

function BE32(const B: TBytes; P: Integer): Cardinal;
begin
  Result := (Cardinal(B[P]) shl 24) or (Cardinal(B[P + 1]) shl 16) or
    (Cardinal(B[P + 2]) shl 8) or B[P + 3];
end;

// True, wenn ein TrueType-Programm eine cmap-Subtable für (Platform, Encoding) hat
function HasCmapSubtable(const Font: TBytes; Platform, Encoding: Integer): Boolean;
var
  Tables, I, Rec, CmapOfs, Count: Integer;
begin
  Result := False;
  if Length(Font) < 12 then
    Exit;
  Tables := BE16(Font, 4);
  CmapOfs := -1;
  for I := 0 to Tables - 1 do
  begin
    Rec := 12 + I * 16;
    if Rec + 16 > Length(Font) then
      Exit;
    if (Font[Rec] = Ord('c')) and (Font[Rec + 1] = Ord('m')) and
       (Font[Rec + 2] = Ord('a')) and (Font[Rec + 3] = Ord('p')) then
      CmapOfs := Integer(BE32(Font, Rec + 8));
  end;
  if (CmapOfs < 0) or (CmapOfs + 4 > Length(Font)) then
    Exit;
  Count := BE16(Font, CmapOfs + 2);
  for I := 0 to Count - 1 do
  begin
    Rec := CmapOfs + 4 + I * 8;
    if Rec + 8 > Length(Font) then
      Exit;
    if (BE16(Font, Rec) = Platform) and (BE16(Font, Rec + 2) = Encoding) then
      Exit(True);
  end;
end;

// Eine Schrift mit nur einer Mac-Roman-(1,0)-cmap druckt cmap(3,1)=False
procedure ListTextFonts(Pdf: TPdf; PageNo: Integer);
var
  I: Integer;
begin
  Pdf.PageNumber := PageNo;
  for I := 0 to Pdf.ObjectCount - 1 do
    if Pdf.ObjectType[I] = otText then
      Writeln(Format('%-32s embedded=%-5s cmap(3,1)=%s', [
        string(Pdf.GetFontBaseName(I)),
        BoolToStr(Pdf.GetFontIsEmbedded(I), True),
        BoolToStr(HasCmapSubtable(Pdf.GetFontData(I), 3, 1), True)]));
end;
Textobjekte, die sich einen Font teilen, drucken dieselbe Zeile mehrfach. Das ist hier harmlos. Ein nacktes CFF-Programm (FontFile3 mit /Type1C oder /CIDFontType0C) hat kein Table-Directory, also antwortet der Helper darauf mit False, und weil die Regel TrueType-Fonts betrifft, entscheidet diese Antwort hier nie etwas. OpenType-Fonts mit CFF-Outlines sind anders: Sie tragen ein sfnt-Directory unter dem OTTO-Tag und können eine cmap enthalten, die dieselbe Schleife findet. Solange das Programm im Speicher ist, lohnt es sich auch, seine hmtx-Vorlaufbreiten mit den /Widths des Font-Dictionarys zu vergleichen, denn PDF/UA hat eine separate Breitenkonsistenzregel, und das Auditing von Glyphenbreiten, CharSet und CIDSet wendet sie von der PDFlibPas-Seite an
Gibt HasCmapSubtable für die Schrift hinter einem §7.21.6-Flag False zurück, räumt keine Bearbeitung ihres Differences-Arrays den Befund weg, und der Generator muss diese Schrift als Type-0-Font mit ToUnicode-CMap einbetten. Fahren Sie die Validierung der PDFium Component für Delphi auf der regenerierten Datei erneut und erwarten Sie, dass pvuaiTrueTypeEncodingInvalid aus Report.Issues verschwunden ist