Ein Scan-Batch kann aus nichts als einem JPEG pro Seite bestehen, ohne Fonts, ohne Annotationen und ohne Lesezeichen, und trotzdem als PDF/raster scheitern. ISO 23504-1 verlangt mehr von der Datei als reine Rasterseiten: Sie muss sich mit einem %PDF-raster-1.0-Kommentar im Trailer-Bereich identifizieren, XMP-Metadaten und ein Trailer-/ID tragen und ihren Katalog sowie das Info-Dictionary auf kurze erlaubte Listen beschränken. Das Prüfen eines Capture-Batches braucht also zwei verschiedene Lesevorgänge, einen über die rohen Bytes und einen über das, was jede Seite wirklich zeichnet
Zwei Lesevorgänge derselben Datei
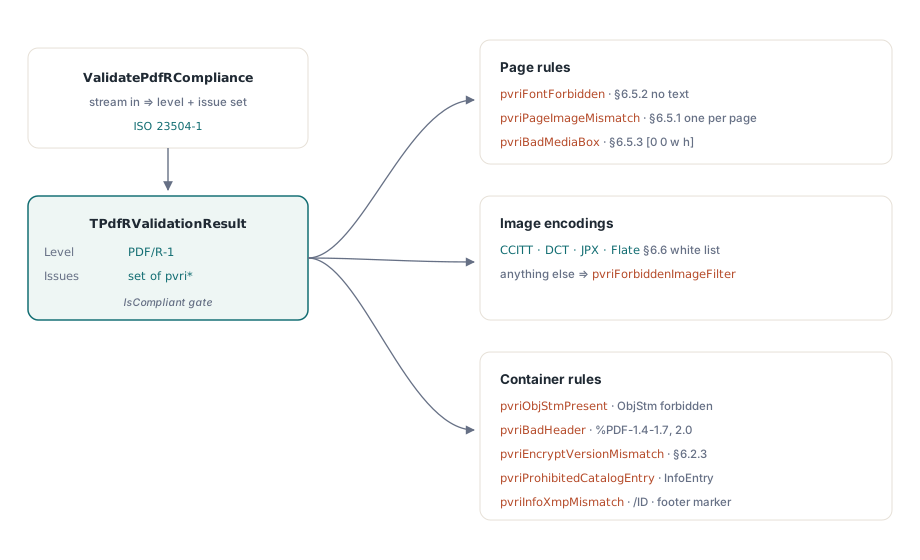
PDF/R-Validierung und SaveAsPdfR kommen mit den Small-Business- und Enterprise-Editionen von PDFium Component, die die Validierung entlang dieser Linie aufteilt. ValidatePdfRCompliance in der Unit FPdfPdfr liest einen Stream und prüft die Byte-Level-Regeln: Header-Version, den Raster-Marker, Object-Streams, Katalog- und Info-Einträge, XMP, Trailer-/ID, MediaBox-Ursprünge, Font-Ressourcen, verbotene Filternamen und ob die Anzahl der Bildobjekte der Seitenzahl entspricht. ValidatePdfRPageFacts prüft jeweils eine Seite aus einem TPdfRPageFacts-Record: wie viele Text-, Pfad-, Form- und Shading-Objekte die Seite zeichnet, wo das einzelne Streifenbild sitzt, seine Pixelgröße, Bittiefe, sein Farbraum und seine Filterkette
Beide Lesevorgänge melden über eine Aufzählung, TPdfRValidationIssue, und die kombinierten Einstiegspunkte verschmelzen sie zu einem einzelnen TPdfRValidationResult. Sein Conformance-Feld wird nur dann prc1, wenn der Raster-Marker gefunden wird, und IsCompliant liefert True nur, wenn das Level prc1 ist und die Issue-Menge leer. Eine Datei, die in jeder anderen Hinsicht perfekt ist, aber den Marker vermissen lässt, meldet prcNone, was Leute beim ersten Durchlauf eines sauberen Scans überrascht
Die Frage ist, woher die Seiten-Fakten kommen. TPdf.ValidatePdfR sammelt sie aus dem geladenen Dokument, serialisiert dieses Dokument aber zuerst in einen temporären Speicher und läuft die Byte-Prüfungen auf der neu gespeicherten Kopie, die Marker- und Katalog-Befunde beschreiben also einen frischen Save, der von der Datei auf der Platte abweichen kann. ValidatePdfRasterSource in FPdfBusinessWorkflows nimmt einen Schnappschuss des Eingabe-Streams und läuft beide Lesevorgänge dagegen. Für eine Datei, die gleich in ein Archiv geht, ist das der Aufruf: Der Befund bezieht sich dann auf die Bytes, die archiviert werden
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // Default-Budget ist 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // unser Capture-Vertrag
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues hält die Byte-Level-Issues plus jede Seiten-Issue
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues sagt, welche Seiten neu zu scannen sind
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Das maschinenlesbare Urteil neben der archivierten Datei ablegen
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Zwei Defaults in TPdfRasterSourceValidationOptions zählen für Scan-Batches. MaxInputBytes ist 64 MiB und MaxPages ist 1000; ein langer Batch aus Farbscans kann das Byte-Budget übersteigen, und der Check endet dann mit Status prssBudgetExceeded und Complete False. MemoryLimitBytes ist 8 MiB, darüber verschüttet der Schnappschuss in TemporaryDirectory und der Report setzt SnapshotSpilled. Report.IsCompliant verlangt außerdem Complete, ein Check, der auf halbem Weg stoppte, liest sich also nie als bestanden
Warum scheitert eine OCR-Textschicht an PDF/R?
Weil eine Rasterseite das gescannte Bild zeichnet und nichts sonst. Eine unsichtbare OCR-Schicht ist ein gewöhnlicher Zusatz in einem PDF/A-Workflow, und sie bringt zwei Dinge in die Datei, die PDF/R ausnimmt: eine Font-Ressource, gemeldet vom Byte-Lesevorgang als pvriFontForbidden, und Textobjekte auf der Seite, gemeldet vom Seiten-Lesevorgang als pvriNonRasterPageContent. Dieselbe Seiten-Issue feuert für Vektorpfade, Shadings und Form-XObjects, eine gestempelte Seitennummer oder eine gezeichnete Rahmenlinie scheitert also auf dieselbe Weise wie versteckter Text
Die Seite-zu-Bild-Beziehung ist ebenfalls streng. Jede Seite muss genau ein Streifenbild tragen; pvriPageImageMismatch feuert auf einer Seite ohne Bild wie auf einer Seite, deren Scan als zwei nebeneinanderliegende Bilder geschrieben wurde. Auf der Byte-Seite wird die Zahl über jedes Objekt genommen, dessen /Subtype /Image ist, also drückt jedes zusätzliche Bildobjekt, eine an den Streifen geheftete Soft-Mask zum Beispiel, die Gesamtzahl über die Seitenzahl hinaus
Die Geometrie bekommt zwei Prüfungen. pvriBadMediaBox meldet eine MediaBox, die nicht bei [0 0 ...] beginnt; der Byte-Lesevorgang inspiziert inline numerische Arrays. Der Seiten-Lesevorgang vergleicht dann die gezeichneten Grenzen des Streifens mit der MediaBox und meldet pvriStripGeometryInvalid, wenn irgendeine Kante um mehr als GeometryTolerancePoints, standardmäßig 0.5 Punkt, danebenliegt. Ein Scanner-Treiber, der durch Skalieren des Bilds auf 98 Prozent der Seite einen weißen Rand lässt, scheitert hier, obwohl die Seite auf dem Bildschirm gut aussieht. RequireFullPageStrip auf False zu setzen schaltet den Abdeckungstest ab für interne Dateien, bei denen ein Rand akzeptabel ist
Welche Bildkodierungen durchkommen
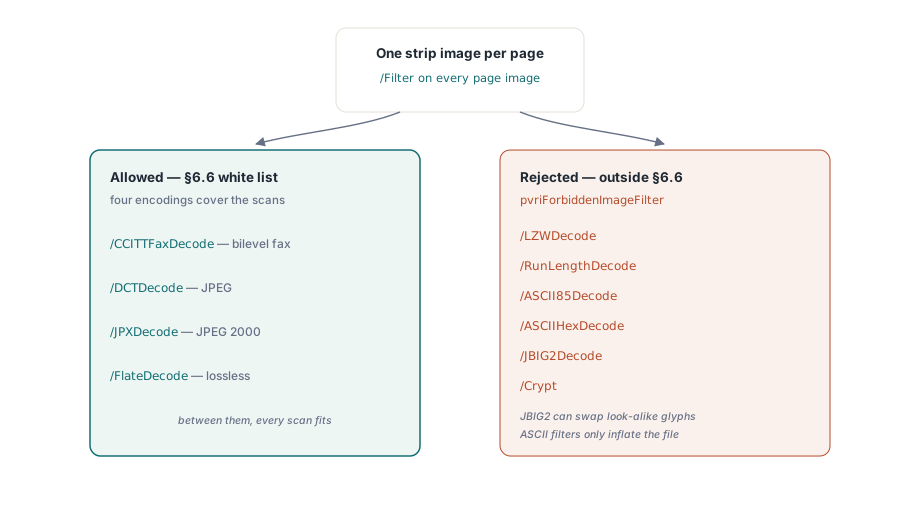
Der Validator akzeptiert vier Streifenfilter: /CCITTFaxDecode, /DCTDecode, /JPXDecode und /FlateDecode. Der Byte-Lesevorgang flaggt die anderen Standardfilter beim Namen als pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode und /Crypt
JBIG2 ist die Zurückweisung, die Capture-Teams zuerst treffen. Sie ist in PDF/A erlaubt und komprimiert Binärseiten sehr gut, ein für PDF/A gebautes Capture-Profil kann sie also bereits emittieren. Ihr verlustbehafteter Pattern-Matching-Modus ist zudem dafür bekannt, eine gescannte Glyphe durch eine ähnlich aussehende zu ersetzen, ein dokumentiertes Problem mit Ziffern auf gescannten Formularen, und ein Raster-Archiv existiert gerade deshalb, damit das, was auf dem Papier war, in der Datei ist. Diese Seiten als CCITT Group 4 neu zu kodieren hält sie binär und verlustfrei
Der Seiten-Lesevorgang geht einen Schritt weiter und schaut sich die Filterkette zusammen mit Bittiefe und Farbraum des Bilds an, Diskrepanzen werden als pvriImageCompressionParametersInvalid gemeldet:
- Eine Kette von mehr als einem Filter wird zurückgewiesen, ein ASCII85-verpacktes Flate-Bild scheitert also doppelt, einmal auf der Byte-Seite und einmal hier
/CCITTFaxDecodemuss auf einem 1-Bit-DeviceGray-Streifen sitzen/DCTDecodemuss auf einem 8-Bit- oder 24-Bit-Streifen in DeviceGray oder DeviceRGB sitzen/FlateDecodewird auf 1-Bit-Streifen akzeptiert; eine 24-Bit-Flate-Seite scheitert an dieser Prüfung/JPXDecodewird bei 1, 8 oder 24 Bits pro Pixel akzeptiert
Unabhängig vom Filter bekommt ein Streifen, dessen Farbraum weder DeviceGray noch DeviceRGB ist, pvriImageColorInvalid. Ein ICC-basierter oder CMYK-Scan muss also konvertiert werden, bevor er verpackt wird, und der billigste Ort dafür ist das Scanner-Profil, bevor irgendein PDF geschrieben wird
Wie die Streifenauflösung ermittelt wird
Trägt das Bild seine eigene Auflösung, benutzt der Seiten-Lesevorgang sie. Tut es das nicht, wird die effektive Auflösung aus Pixeln und Seitengröße abgeleitet: Pixelbreite mal 72 geteilt durch MediaBox-Breite in Punkten, und dasselbe für die Höhe. Angenommen, ein Scanner schreibt einen 2550-mal-3300-Pixel-Streifen auf eine US-Letter-Seite von 612 mal 792 Punkten. Das ergibt exakt 300 dpi in beide Richtungen. Dieselbe Seite mit 600 mal 776 Pixeln kommt auf etwa 70.6 dpi horizontal, unter dem Default-Minimum von 72, die Seite bekommt also pvriImageResolutionInvalid
Der Default-Bereich in TPdfRValidationOptions ist 72 bis 2400 dpi. Diese Grenzen fangen nur offensichtlich kaputte Seiten. Ein Capture-Vertrag verspricht meist ein bestimmtes Minimum, oft 200 oder 300 dpi, und dieser Wert gehört in MinimumResolutionDpi: Eine 150-dpi-Seite besteht den Default-Bereich, und sie ist genau die Seite, gegen die der Vertrag geschrieben wurde. Eine der Grenzen auf 0 zu setzen schaltet die jeweilige Seite der Prüfung ab
ValidatePdfRPageFacts ist öffentlich, dieselben Regeln können also laufen, bevor irgendein PDF existiert, direkt aus dem, was der Scanner über jedes Bild meldet:
uses
  FPdfPdfr;

// Baut Seiten-Fakten aus Scanner-Ausgabe; dieser Helper ist Ihrer, kein Teil der Bibliothek
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // der Streifen deckt die ganze Seite ab
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi auf 0 gelassen: abgeleitet
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // 300-dpi-Farb-JPEG auf Letter: leere Menge
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // Dieselbe Seite mit Flate bei 24 Bits komprimiert:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Katalog, Info-Dictionary und XMP
Neben dem erforderlichen /Type und /Pages erlaubt ISO 23504-1 im Katalog nur Version, ViewerPreferences, PageLayout, PageMode, AcroForm und Metadata. Der Validator prüft den Katalog gegen die 21 Standardschlüssel außerhalb dieser Menge und wirft pvriProhibitedCatalogEntry, wenn einer davon auftaucht, darunter Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties und OutputIntents. Der letzte zählt in der Praxis: Eine PDF/A-Datei trägt immer einen Output-Intent, eine einzige Datei kann also nicht beide Profile erfüllen
Das Info-Dictionary darf Creator, Producer, CreationDate und ModDate halten; Title, Author, Subject, Keywords und Trapped werfen pvriProhibitedInfoEntry. Ein Katalog ohne /Metadata-Stream bekommt pvriMissingXmpMetadata. Ist der Stream da, aber sein XMP vermisst eines von xmp:CreateDate, xmp:ModifyDate und xmp:MetadataDate, lautet der Befund stattdessen pvriMetadataInvalid. pvriInfoXmpMismatch vergleicht Producer mit pdf:Producer und Creator mit xmp:CreatorTool. Datumswerte bleiben aus dem Vergleich draußen, weil die beiden Kodierungen legitim differieren, und als Hex-Strings gespeicherte Info-Werte werden übersprungen. Ein typischer Auslöser ist ein späteres Tool, das den Info-Producer umschreibt, ohne das XMP anzufassen
Die übrigen Container-Regeln sind kurz. Der Header muss %PDF-1.4 bis %PDF-1.7 oder %PDF-2.0 sein (pvriBadHeader), jeder /Type /ObjStm-Stream wirft pvriObjStmPresent, und eine verschlüsselte Datei muss einen %PDF-2.0-Header benutzen (pvriEncryptVersionMismatch). Mit eingeschaltetem RequireEncryptedPdf20Profile muss das Verschlüsselungs-Dictionary zudem /V 5 oder 6 mit /R 5 oder später deklarieren, sonst bekommt die Datei pvriEncryptedPdf20ProfileInvalid
Die Marker schreiben
TPdfRSaveOptions trägt Creator, Producer, CreationDate, ModDate, DocumentId und InstanceId und hat kein Feld für Title, Author, Subject oder Keywords, weil das Profil sie verbietet. StripInfoOptionalEntries und StripCatalogOptionalEntries defaulten beide auf True und entfernen die ausgeschlossenen Einträge aus der Quelle; eines davon auf False zu setzen lässt die Einträge bleiben, auf Kosten der Konformität. TPdf.SaveAsPdfR füllt leere Optionsfelder aus den eigenen Metadaten und Datei-Identifikatoren des geladenen Dokuments, entfernt die Sicherung und schreibt dann den Marker, die getrimmten Dictionaries, das XMP-Paket und die Trailer-/ID
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, Datumswerte und IDs kommen aus der Quelle
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Die geschriebenen Bytes prüfen, nicht das In-Memory-Dokument
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
Verpacken ändert nur Metadaten und Identifikation. Eine Quellseite, die Vektortext zeichnet oder kein Streifenbild trägt, kommt aus SaveAsPdfR mit demselben Seiteninhalt heraus und scheitert an denselben Seitenprüfungen. Der Seiteninhalt bleibt absichtlich unangetastet, denn einen Scan still neu zu rendern würde genau die Pixel verändern, die das Archiv bewahren soll. CheckDeliveredScan aus dem ersten Listing auf OutFile laufen zu lassen liefert das volle Urteil, Seiten-Lesevorgänge inklusive
Wo PDF/R in eine Capture-Pipeline passt
PDF/R eignet sich für Ablieferungen, bei denen der Scan selbst die Aufzeichnung ist und Treue der ganze Vertrag: Beweisbildgebung, Scheck- und Zahlungseingangs-Capture, Zeichnungsarchive vom Großformat-Scanner. Braucht ein Dokument einmal durchsuchbaren Text, Tagging, Attachments oder Lesezeichen, gehört es in PDF/A, denn jedes dieser Features landet auf den ausgeschlossenen Listen oben
Viele Teams halten beide. Ein PDF/R-Original wird einmal geschrieben und ändert sich nie, und ein PDF/A-Derivat mit OCR-Schicht dient der Wiederauffindung. Die Validatoren sind unabhängig, ein Batch-Job kann also jede Datei gegen das Profil prüfen, zu dem sie sich bekennt. Die Archiv-Seite behandeln PDF/A-Archiv-Konformität und PDF/A-Preflight-Validierung, Druckausgaben druckfertige PDF/X-Dokumente validieren
Die hier gezeigten PDF/R-Prüfungen sind Teil der Small-Business- und Enterprise-Editionen von PDFium Component für Delphi, C++Builder und Lazarus, neben Validatoren für PDF/A, PDF/X, PDF/E und PDF/UA; Editionen und unterstützte IDE-Versionen stehen auf der Produktseite PDFium Component