Importieren Sie ein FDF in ein Formular, und die Feldwerte kommen subtil falsch zurück: Ein Aufzählungspunkt kommt als Dolch an, Auslassungspunkte als Gedankenstrich. PDFium Component hat diese ganze Symptomfamilie auf eine einzige Zeile in seiner PDFDocEncoding-Tabelle zurückgeführt — der Sonderzeichen-Block in ISO 32000-1 Annex D.2 beginnt bei $80, nicht bei $7F
Warum liefert ein FDF-Import das Nachbarzeichen?
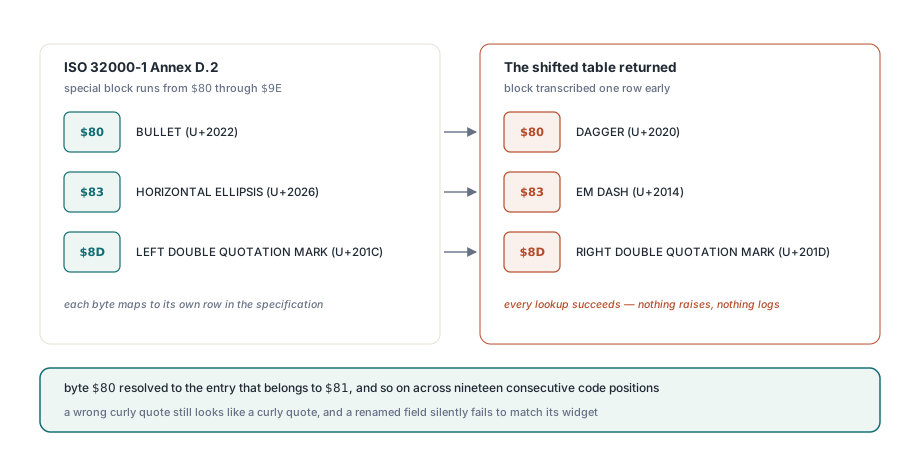
Weil eine um eine Position verschobene Encoding-Tabelle immer noch eine perfekt valide aussehende Tabelle ist, in der jeder Lookup gelingt. Der Block, den Annex D.2 auf $80 bis $9E legt, war eine Zeile zu früh transkribiert worden, also löste Byte $80 den Eintrag auf, der zu $81 gehört, Byte $81 den Eintrag für $82, und so weiter über neunzehn aufeinanderfolgende Codepositionen. Nichts hat geworfen, nichts geloggt, kein Feld wurde je abgelehnt — TPdf.ImportFDF meldete dieselbe Feldanzahl wie immer
Der Schaden war gleichmäßig und lautlos. Ein Byte mit $80, das Annex D.2 als BULLET (U+2022) definiert, kam als DAGGER (U+2020) zurück. Byte $83, HORIZONTAL ELLIPSIS (U+2026), kam als EM DASH (U+2014) zurück. Byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), kam als RIGHT DOUBLE QUOTATION MARK (U+201D) zurück — der Fall, den niemand bemerkt, weil ein falsches typografisches Anführungszeichen in einem Formularfeld immer noch wie ein Anführungszeichen aussieht. Feldnamen erlitten dasselbe Schicksal wie Feldwerte, und das ist schlimmer: Ein Name, der nicht mehr zum Widget im Dokument passt, schlägt stillschweigend fehl
PDF-Text-Strings tragen zwei verschiedene Encodings
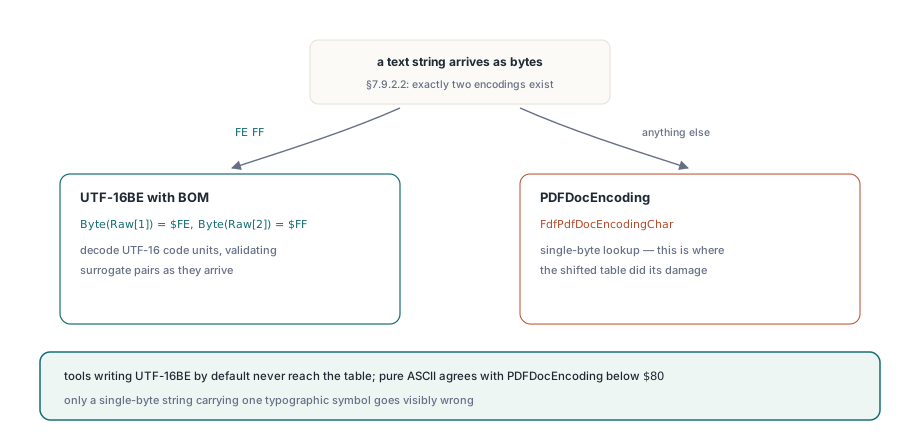
ISO 32000-1 §7.9.2.2 definiert den Text-String-Typ als genau eine von zwei Encodings, gewählt durch Inspektion der ersten zwei Bytes statt durch irgendeinen Dictionary-Eintrag. Ein String, der mit dem Byte-Order-Mark FE FF beginnt, ist UTF-16BE; alles andere ist PDFDocEncoding. Genau dieser eine Branch entscheidet, welcher von zwei völlig verschiedenen Decodern läuft, und PDFium Component wendet ihn im FDF-Parser an, bevor auch nur ein einziges Zeichen angefasst wird
// FDF-Text-String: UTF-16, wenn das BOM vorhanden ist, sonst PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... UTF-16-Code-Units dekodieren, Surrogate-Paare validieren
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Genau deshalb hat sich der Bug im normalen Testbetrieb so lange versteckt. Jedes FDF, das ein Tool erzeugt, das per Default UTF-16BE schreibt, erreicht FdfPdfDocEncodingChar überhaupt nicht, die verschobene Tabelle bleibt also schlafend. Nur Single-Byte-Strings — und genau die emittieren viele FDF-Generatoren für schlichte lateinische Feldnamen, weil sie kürzer sind — laufen in den Branch, in dem die Tabelle zählt. Reine ASCII-Feldnamen dekodieren dann ohnehin korrekt, denn unterhalb von $80 stimmen PDFDocEncoding und ASCII überein. Sie brauchen einen Single-Byte-String mit genau einem typografischen Symbol, bevor irgendetwas sichtbar schiefgeht
Die korrigierte Tabelle und die zwei Anker, die sie fixieren
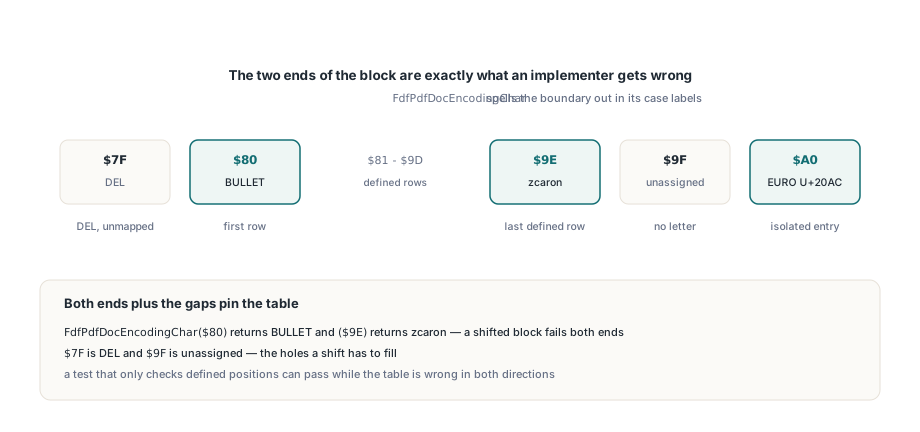
PDFium Component schreibt die Grenze jetzt direkt in FdfPdfDocEncodingChar aus, weil die beiden Enden des Blocks genau das sind, was ein Implementierer falsch macht. $7F ist DEL und hat überhaupt keine PDFDocEncoding-Bedeutung; der Block öffnet bei $80 mit BULLET und läuft bis $9E mit zcaron; $9F ist nicht zugewiesen; und das Euro-Zeichen sitzt allein bei $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Der Block läuft ab $80, nicht $7F: $7F ist DEL und
    // hat keine PDFDocEncoding-Bedeutung, und der Euro sitzt bei $A0, was der
    // Default-Branch sonst als geschütztes Leerzeichen zurückgeben würde
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, erste Zeile des Blocks
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 bis $9D
    $9E: Result := WideChar($017E);   // zcaron, letzte definierte Zeile
    $9F: Result := WideChar($FFFD);   // in Annex D.2 nicht zugewiesen
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Sehen Sie sich an, was die Verschiebung mit diesen beiden Enden gemacht hat, denn genau dort hört ein Off-by-One auf, kosmetisch zu sein. zcaron saß in der Spezifikation bei $9E, in der verschobenen Tabelle aber bei $9D, ein Dokument-Byte von $9E fiel also hinter die letzte transkribierte Zeile und rutschte direkt in den Identity-Fallback, wo es statt eines Buchstabens ein C1-Steuerzeichen zurückgab. Und $A0, der Euro, wurde von vornherein nie in die Tabelle geschrieben — der Identity-Branch gab ihn als U+00A0 NO-BREAK SPACE zurück, ein Zeichen, das jede spätere Validierung überlebt, als nichts gedruckt wird und nie dem Feldnamen entspricht, den Sie suchen
Wie testet man eine transkribierte Encoding-Tabelle?
Testen Sie die erste Zeile, die letzte Zeile und die Lücken — kein Stichprobenwert aus der Mitte. Das ist der Teil des Fixes, den Sie auf jede andere Tabelle übertragen sollten, die Sie aus einer Spezifikation kopieren, denn eine Stichprobe aus der Blockmitte ist genau der Test, den eine Ganzblock-Verschiebung überlebt. Zu verifizieren, dass $8D ein linkes doppeltes Anführungszeichen liefert, beweist nichts, wenn $8C auch etwas Plausibles liefert; zu verifizieren, dass $80 BULLET und $9E zcaron liefert, fixiert beide Enden, und ein verschobener Block kann nicht beides gleichzeitig erfüllen
procedure CheckPdfDocEncodingAnchors;
begin
  // Beide Enden des Annex-D.2-Sonderblocks: Eine Ganzblock-Verschiebung bricht diese
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Codepositionen, die die Spezifikation undefiniert lässt, dürfen nicht zu einem Buchstaben dekodieren
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Der isolierte Eintrag über dem Block, leicht komplett zu vergessen
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Die undefinierten Positionen verdienen eigene Assertions, statt als uninteressant übersprungen zu werden. Ein Off-by-One muss irgendwo etwas hinstellen, und wohin er es stellt, ist fast immer eine Codeposition, die die Spezifikation leer gelassen hat — $7F vorn, $9F hinten. Ein Test, der nur definierte Positionen prüft, kann bestehen, während die Tabelle in beide Richtungen falsch ist; ein Test, der die Löcher fixiert, fängt die Verschiebung beim ersten Lauf
Was das in einem Round-Trip-Formular-Workflow kostet
Ein FDF-Import, der pro Symbol still ein Zeichen umschreibt, ist schlimmer als einer, der scheitert, denn der Fehler taucht erst downstream auf und sieht aus wie etwas anderes. Feldnamen sind hier die scharfe Kante. TPdf.ImportFDF matcht eingehende Namen gegen die Widgets im geöffneten Dokument, und ein Name, der ein Zeichen falsch dekodiert wurde, matcht schlicht nicht — das Feld bleibt leer, der Rückgabewert zählt das Feld trotzdem als geparst, und der Report, der aus der Pipeline kommt, ist einen Wert zu kurz, ohne dass irgendetwas im Log erklärt, warum. Wer eine Export-und-Reimport-Schleife der Art baut, die im Artikel über das Exportieren und Importieren von XFDF-Formulardaten und Annotationen mit PDFium Component beschrieben ist, sollte einen Feldnamen mit typografischem Symbol im Round-Trip testen, nicht nur reines ASCII, bevor er der Schleife vertraut
Es lohnt sich auch, ehrlich über die Grenzen des Fixes zu sein. Die Tabelle stimmt jetzt für alle 256 Byte-Werte mit Annex D.2 überein, Single-Byte-FDF-Strings dekodieren also korrekt, aber PDFDocEncoding selbst deckt ein lateinisches Repertoire ab und sonst nichts — alles außerhalb muss als UTF-16BE mit BOM ankommen, genau das beabsichtigt §7.9.2.2. Und ein UTF-16-String hat auf der Delphi-Seite weiterhin seine eigenen Gefahren, denn ein Codepoint jenseits von U+FFFF braucht ein Surrogate-Paar statt eines einzelnen WideChar — das Problem aus dem Artikel warum Emoji und CJK-Zeichen WideChar in Delphi brechen. Der allgemeinere Punkt verallgemeinert sich über Encoding-Tabellen hinaus: Ein PDF-Parser kann etwas ablehnen, das er akzeptieren sollte — das finden Sie sofort —, oder etwas akzeptieren und es still falsch machen — das finden Sie in Produktion. Die Name-Token-Fallen aus dem Artikel zum sicheren Parsen von PDF-Dictionaries sitzen in der zweiten Kategorie, und eine um eine Zeile verschobene Tabelle auch — der Codepfad gelingt, der Rückgabewert sieht vernünftig aus, und nur ein Test, der gegen die Spezifikation statt gegen die Implementierung geschrieben ist, sagt das Gegenteil
ImportFDF, ExportFDF und ImportXFDF auf TPdf gehören zusammen mit den FDF- und XFDF-Parsern dahinter zur Standard-PDFium Component für Delphi und C++Builder