PDFium Component prüft die PDF/A-Info-zu-XMP-Metadaten-Äquivalenz mit TPdf.InspectPdfAMetadata und repariert sie mit TPdf.NormalizePdfAMetadata. ISO 19005-1 (in der Fassung von Cor.1) verlangt von jedem der acht gemappten Info-Einträgen, Title bis ModDate, denselben Wert wie seine XMP-Property – nicht bloß, dass er existiert; die Prüfung liest die korrekte RDF-Form, matcht Namespaces über URIs und vergleicht Daten als Zeitpunkte
Der Bug-Report, der dieses Gespräch üblicherweise eröffnet, wirkt harmlos. Ein Dokumentenmanagementsystem stempelt bei jedem inkrementellen Save ein neues /ModDate ins Info-Dictionary, lässt das XMP-Paket in Ruhe, und sechs Monate später flaggt ein Archiv-Audit tausende Dateien als nicht konform. Beide Daten sind da. Sie haben nur bei der ersten Änderung aufgehört, sich zu einigen, und eine Presence-Prüfung hat es nie gemerkt. Title-Änderungen über eine Info-only-API und ein Author-String wie Finance; Controlling, den irgendein Tool in zwei dc:creator-Items aufgespalten hat, failen auf dieselbe Art
Warum weist PDF/A Metadaten zurück, die an beiden Stellen existieren?
PDF/A weist sie zurück, weil ISO 19005-1 §6.7.3 eine Wertregel ist, keine Presence-Regel: Tabelle 1 mappt acht Info-Keys auf XMP-Properties, und sobald ein Info-Key vorhanden ist, muss die gemappte XMP-Property einen äquivalenten Wert halten. Der Byte-Level-Scanner aus PDF/A-Preflight-Validierung mit PDFium Component bestätigt nur, dass xmp:CreateDate und xmp:ModifyDate existieren (pvaiMissingXmpDates). Seit v3.72.0 fährt TPdf.ValidatePdfA zusätzlich den vollständigen Wertvergleich und nimmt pvaiInfoXmpValueMismatch ins Issue-Set auf, wenn ein XMP-Paket existiert, aber dem Info widerspricht (ein nicht parsebares Paket zählt als Widerspruch). Ein fehlendes Paket bleibt als pvaiMissingXmpMetadata gemeldet, sodass die beiden Issues denselben Defekt nie doppelt zählen
Welche RDF-Form braucht jede gemappte XMP-Property?
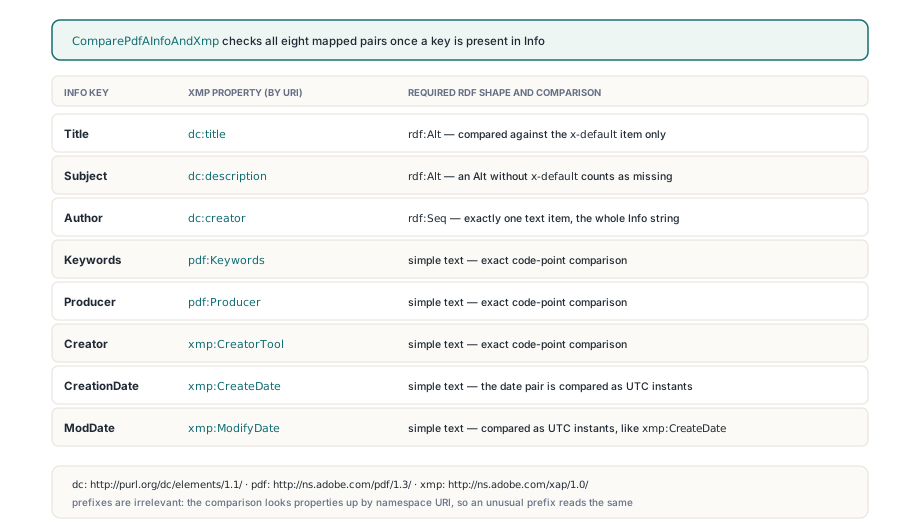
Jede der acht Mappings hat einen festen XMP-Typ, und ein korrekter Wert im falschen Container failt trotzdem. ComparePdfAInfoAndXmp in FPdfPdfa.pas schlägt Properties über den Namespace-URI nach, sodass ein Paket, das http://purl.org/dc/elements/1.1/ an ein ungewöhnliches Präfix bindet, exakt so gelesen wird wie eines mit dc. Die geforderten Formen sind:
- Title →
dc:titleund Subject →dc:description: einerdf:Alt-Sprachalternative, verglichen nur gegen ihrx-default-Item (der Sprachtag wird case-insensitive gematcht); ein Alt ohnex-defaultzählt als fehlend - Author →
dc:creator: einrdf:Seqmit exakt einem Text-Item, das den ganzen Info-String hält, sodass eine semikolongetrennte Autorenliste ein einzelner Eintrag bleibt - Keywords →
pdf:Keywordsund Producer →pdf:Producer(Namespacehttp://ns.adobe.com/pdf/1.3/): schlichte Text-Properties - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(Namespacehttp://ns.adobe.com/xap/1.0/): schlichte Text-Properties
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Textwerte werden als exakte Unicode-Codepunkt-Sequenzen verglichen, ohne Trimming, Case-Folding oder Normalisierung. Ein angehängtes Leerzeichen, oder ein vorkomponiertes é auf der einen Seite und ein zerlegtes e plus kombinierender Akzent auf der anderen, ist ein echter Mismatch. Die Info-Seite stammt immer aus PDFiums eigener Dekodierung von PDFDocEncoding- und UTF-16-Text über FPDF_GetMetaText, was die Bibliothek davon abhält, String-Dekodierung neu zu implementieren und sie subtil falsch zu machen; die XMP-Seite ist nur so sauber wie die Bytes, die sie hervorgebracht haben – deshalb spielen auch die Codepage-Fallen, die XMP-Metadaten unter Free Pascal korrumpieren, hier eine Rolle
Wann sind ein PDF-Datum und ein XMP-Datum gleich?
Ein PDF-Datum und ein XMP-Datum sind gleich, wenn sie denselben Zeitpunkt auf die Sekunde beschreiben, mit derselben Zeitzonen-Information auf beiden Seiten. Beide Parser akzeptieren legale reduzierte Präzision, D:2026 und 2026 bedeuten also beide den 1. Januar 2026, 00:00:00. Tragen beide Werte eine Zone, werden sie vor dem Vergleich nach UTC konvertiert: D:20260827093659+08'00' entspricht 2026-08-27T01:36:59Z. Trägt keiner eine Zone, werden die lokalen Komponenten verglichen, wie sie dastehen. Hat nur eine Seite eine Zone, ist das Ergebnis pamsValueMismatch, denn einen Offset zu erfinden wäre geraten. Eine von null verschiedene Sekundenbruchteil wie .250 in XMP erzwingt ebenfalls einen Mismatch, denn ein PDF-Datum hat keine Möglichkeit, sie auszudrücken, und sie stillschweigend wegzurunden würde einen echten Widerspruch verstecken; .000 wird akzeptiert. Nicht parsebare Werte werden separat als pamsInvalidInfoDate oder pamsInvalidXmpDate gemeldet
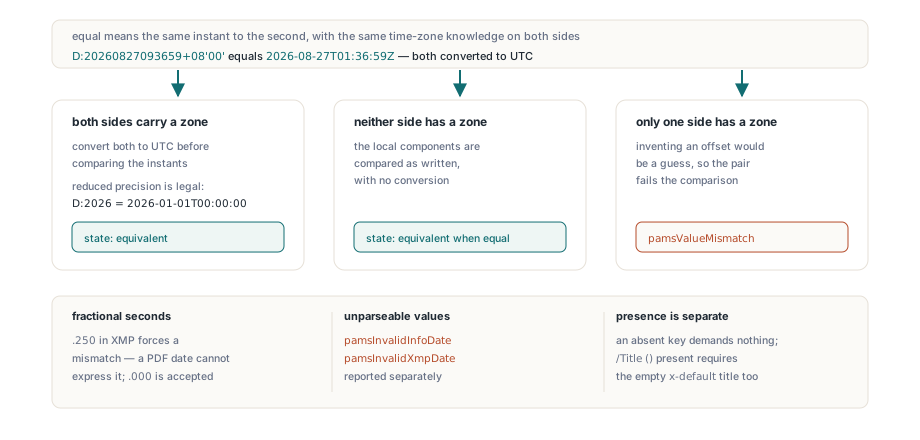
Presence hat ihre eigene Regel. TPdfAMetadataValues.Present ist ein Set, gefüllt beim Durchlaufen des /Info-Dictionarys des aktiven Trailers, und es hält „Key fehlt“ von „Key vorhanden mit leerem String“ getrennt. Ein fehlender Key ergibt pamsNotRequired und verlangt nichts vom XMP; /Title () ist vorhanden, das XMP-Paket muss also ebenfalls einen leeren x-default-Titel tragen
Wie prüft man Info- und XMP-Metadaten vor dem Speichern?
TPdf.InspectPdfAMetadata liefert einen TPdfAMetadataReport mit je einem TPdfAMetadataComparison pro Feld, jedes mit dem Info-Wert, dem XMP-Wert und einem TPdfAMetadataState, sodass sich ein Fehlschlag erklären lässt, ohne ein einzelnes Validation-Flag rückzuentwickeln. MismatchFields fasst die failende Menge zusammen, HasXmpPacket verrät, ob ein Paket gefunden wurde, und XmpParseError trägt die Parser-Meldung, wenn das Paket existiert, aber nicht lesbar ist
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
Was ändert NormalizePdfAMetadata, und was verweigert es?
TPdf.NormalizePdfAMetadata behandelt das Info-Dictionary als die Quelle der Wahrheit und schreibt nur die XMP-Properties neu, deren Feld in MismatchFields gelandet ist; alles andere im Paket überlebt. Title und Subject werden ins x-default-Item geschrieben, während andere Sprachalternativen intakt bleiben, Author wird zu einem ein-elementigen rdf:Seq, unbekannte Namespaces und unrelated Properties bleiben erhalten, und XMP-Properties für fehlende Info-Keys werden unangetastet gelassen. Ein Info-Datum mit Zone wird als kanonisches UTC-XMP-Datum mit Z-Suffix geschrieben; eines ohne Zone behält seine lokalen Komponenten. Der Datei-Overload speichert über eine temporäre Datei und ein atomares Ersetzen, und das XMP-Update selbst wird als inkrementelles Update angehängt
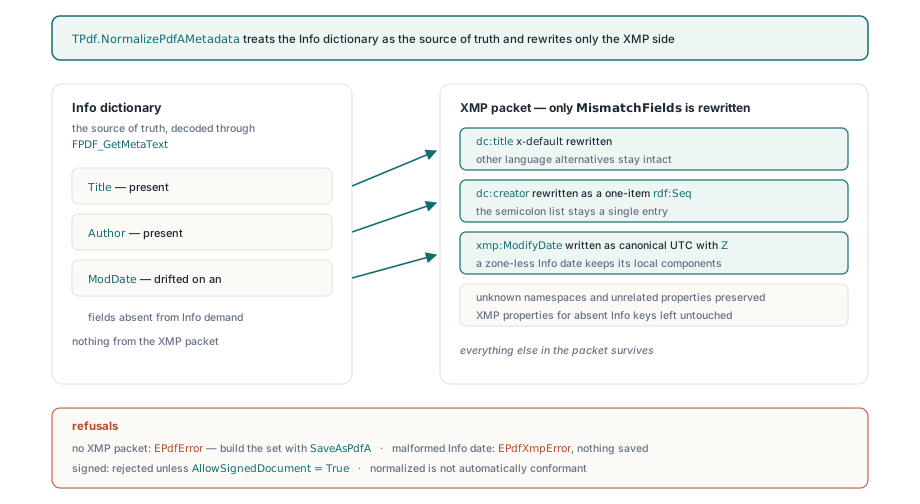
Die Verweigerungen sind Absicht. Ohne XMP-Paket wirft die Methode EPdfError, denn einen vollständigen PDF/A-Identifikations- und Metadatensatz zu bauen ist Sache von SaveAsPdfA, behandelt in PDF/A-Archivdateien erzeugen mit PDFium Component. Ein fehlerhaftes Info-Datum wirft EPdfXmpError, statt einen plausibel aussehenden falschen Wert zu schreiben, und gespeichert wird nichts. Signierte Dokumente werden abgelehnt, sofern der Aufrufer nicht AllowSignedDocument = True übergibt. Äquivalenz ist außerdem nur eine Regel von ISO 19005-1, eine normalisierte Datei ist also nicht automatisch eine konforme
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // bereits konsistent, Datei in Ruhe lassen
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // fehlerhaftes Info-Datum oder unlesbares Paket
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Den Vergleich auf dem eigenen XMP-Paket ausführen
ComparePdfAInfoAndXmp und SynchronizePdfAInfoToXmp sind schlichte Funktionen in FPdfPdfa, die auf einem TPdfXmpPacket arbeiten, ohne dass ein Dokument geladen ist – gut für Unit-Tests und Pipelines, die XMP aus einem Template zusammensetzen. Die eine Falle ist Present: Ein mit Default(TPdfAMetadataValues) initialisierter Record hat ein leeres Set, jedes Feld meldet dann pamsNotRequired, und der Vergleich läuft hohl durch, ganz gleich, welche Werte Sie eingetragen haben
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present entscheidet, welche Felder Pflicht sind; Werte allein werden ignoriert
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate ist jetzt 2026-08-27T01:36:59Z, dc:creator ein ein-elementiges rdf:Seq
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Wenn Ihre Pipeline Dokumente archiviert, die andere Systeme weiter bearbeiten, koppeln Sie einen nächtlichen InspectPdfAMetadata-Durchlauf mit NormalizePdfAMetadata für die Dateien, die driften, und lassen Sie ValidatePdfA als Gate, bevor irgendetwas in die Langzeitarchivierung geht. Der typisierte Report, der Reparaturpfad und der Rest des PDF/A-Werkzeugs kommen mit der PDFium Component für Delphi und C++Builder