Sucht man in einem gescannten PDF nach einer Rechnungsnummer, findet die Suche den Treffer, doch die Markierung sitzt ein halbes Zoll links der gedruckten Ziffern und ein halbes Zoll unter ihnen. Ein halbes Zoll sind 36 Points, und die betreffende Seite hat eine CropBox von [36 36 576 756]. Wer diese Textebene gebaut hat, hat Pixelpositionen in Seitenpositionen umgerechnet, indem er durch die Bitmap-Breite teilte und mit der Seitenbreite multiplizierte, was unterstellt, dass der sichtbare Bereich im Ursprung beginnt. Auf einer Seite mit /Rotate 90 treibt dieselbe Formel größeren Unsinn: Die x-Achse der Bitmap läuft dann längs der y-Achse der Seite, und die Wörter landen komplett im falschen Seitenteil
Was eine unsichtbare Textebene eigentlich ist
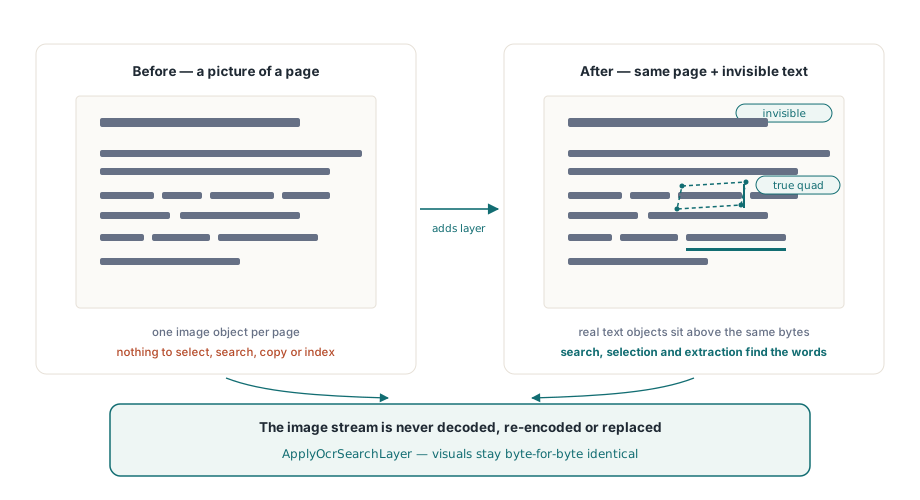
Eine gescannte Seite ist ein einziges großes Bild, das der Content Stream malt. Es gibt nichts zu markieren, zu durchsuchen, zu kopieren oder zu indizieren. Eine durchsuchbare Textebene legt gewöhnliche Textobjekte über dieses Bild und setzt ihren Text-Rendermodus auf 3, was ISO 32000-1 in §9.3.6 (Tabelle 106) als weder Füllung noch Kontur definiert: Die Glyphen existieren für Markierung, Suche und Extraktion, und ein Viewer zeichnet für sie nichts. Sauber gemacht, sieht der Leser den originalen Scan, und Strg+F findet die Wörter genau dort, wo sie gedruckt sind
In PDFium Component ist die ganze Aufgabe ein einziger Aufruf: TPdf.ApplyOcrSearchLayer. Er rendert jede ausgewählte Seite, übergibt die Pixel an einen OCR-Provider, filtert die erkannten Wörter nach Konfidenz und schreibt die Überlebenden als unsichtbare Textobjekte zurück. Das Seitenbild bleibt, wie es ist: Der Scan wird nicht dekodiert, neu kodiert oder ersetzt, daher behält ein JBIG2- oder CCITT-G4-Bild exakt die komprimierten Bytes, mit denen er angekommen ist. Die Methode gehört zu den Editionsvarianten Small Business und Enterprise, das Projekt braucht also Lib\SmallBusiness im Suchpfad und FPdfSmallBusiness in einer uses-Klausel; ohne diese Unit löst der Aufruf EPdfSmallBusinessRequired aus
Einen IPdfOcrProvider schreiben
Die Erkennung selbst steckt hinter einem Interface. IPdfOcrProvider.RecognizePage erhält ein TPdfOcrImage (Seitennummer, Breite, Höhe, Stride, DPI, Pixelformat und einen TBytes-Puffer mit BGRA-Zeilen von oben nach unten), dazu ein Abbruch-Token, und gibt ein Array aus TPdfOcrWord-Records zurück: Unicode-Text, eine Konfidenz zwischen 0 und 1 und ein Quad mit vier Eckpunkten in Bildpixeln. Die Edition liefert einen fertigen Provider mit, CreatePdfTesseractOcrProvider aus FPdfOcrTesseract, der an eine Tesseract-Bibliothek und ein mitgeliefertes traineddata-Verzeichnis gebunden wird. Jede andere Engine, eine Cloud-API oder ein kommerzielles SDK, steigt über eine Klasse wie diese ein:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // Die Engine-Routinen unten stehen für die Anbindung der eigenen OCR-Engine
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // einen Abbruch als Abbruch melden

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // Viele Engines melden 0..100; die Ebene erwartet 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Wer Tesseracts 87.5 unverändert durchreicht, bekommt jedes Wort verworfen. Tesseract meldet die Wortkonfidenz nämlich als Prozentwert, und der mitgelieferte Adapter teilt ihn herunter, bevor er zurückgibt; ein eigener Provider muss dasselbe tun, denn ApplyOcrSearchLayer wertet eine Konfidenz über 1 als ungültige Eingabe. Das Symptom ist unverkennbar, sobald man danach sucht: Report.RejectedWordCount gleicht Report.DetectedWordCount, und die gespeicherte Datei enthält überhaupt keinen Text
Aus einem anderen Grund zählt der Token-Aufruf. Stellt der Provider den Abbruch fest und gibt einfach False zurück, wird die Seite als popsFailed in den Bericht geschrieben, mit der Meldung, die man gesetzt hat. Ruft man stattdessen ThrowIfCancelled auf, fliegt EPdfOperationCancelled, den die Ebene fängt und als popsCancelled verbucht, mit gesetztem Report.Cancelled und angehaltener Schleife. Innerhalb eines Providers ist der Token nie nil; übergibt der Aufrufer keinen, kommt ein nie abgebrochener zum Einsatz
Quads und Wörter, die die Ebene zurückweist
Scans stehen selten gerade zur Seite, daher belegt ein Wort auf einem leicht schief eingescannten Blatt ein Parallelogramm. TPdfOcrQuad trägt für genau diesen Fall die Punkte TopLeft, TopRight, BottomRight und BottomLeft, und FromRectangle baut die achsenparallele Variante für Engines, die nur Rechtecke melden. Ein Wort wird übersprungen und in RejectedWordCount gezählt, wenn sein Text leer oder länger als MaxWordCharacters ist, wenn seine Konfidenz NaN ist, unter MinConfidence oder über 1 liegt, wenn eine Ecke aus der Bitmap fällt oder wenn das Quad nach der Abbildung zu einem schmaleren Streifen als 0.01 pt kollabiert
Warum proportionale Skalierung OCR-Wörter falsch platziert
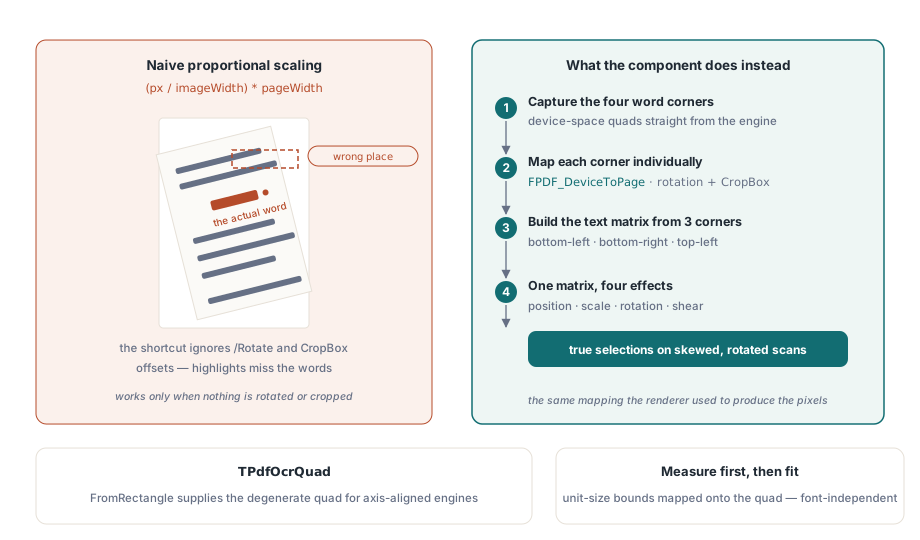
Proportionale Skalierung ist nur korrekt, wenn die Seite keinen /Rotate-Eintrag hat und ihre CropBox bei (0, 0) beginnt. Viele Scans verfehlen mindestens eine dieser Bedingungen: Ein Querformat-Blatt wird oft als Hochformat-Seite mit gesetztem /Rotate gespeichert, und Crop-Boxen verschieben sich, wenn jemand in einem Editor die Ränder beschneidet. Das Eingangsbeispiel zeigt den milden Fall; mit Rotation hört der Fehler auf, ein Versatz zu sein, und wird zu einer vertauschten Achse
ApplyOcrSearchLayer schickt jede der vier Ecken durch FPDF_DeviceToPage, mit derselben Bitmap-Größe und derselben Rotation, die auch die Pixel erzeugt hat, die der Provider gesehen hat. Rotation und Crop-Box-Versatz werden damit von derselben Transformation behandelt, die der Renderer benutzt hat. Auf dem Weg hinein werden die Ecken auf ganze Pixel gerundet, was bei den voreingestellten 300 DPI einem Quantisierungsschritt von 0.24 pt entspricht, weit unter allem, was eine Auswahlmarkierung anzeigen kann
Aus den abgebildeten Punkten definieren die untere linke, die untere rechte und die obere linke Ecke eine affine Matrix. Drei Punkte genügen, um Position, Skalierung, Rotation und Scherung auszudrücken, deshalb dient die vierte Ecke nur der Validierung, nie der Anpassung. Das Textobjekt wird mit Schriftgröße 1 erzeugt, seine tatsächlichen Grenzen werden gemessen, und die Matrix bildet diese gemessenen Grenzen auf das Ziel-Quad ab. Eine Punktgröße aus der Quad-Höhe zu schätzen, würde mit Ober- und Unterlänge jeder Schrift driften; erst messen macht die Passform unabhängig von der Schrift, die Options.FontName nennt
Die Schrift bleibt auch für die Extraktion relevant, obwohl nichts gezeichnet wird. TPdfOcrOptions.Default stellt sie auf Arial. Lässt sich diese Schrift nicht laden, fällt die Ebene auf Standard-Helvetica zurück, eine der 14 Standardschriften, deren eingebaute Kodierung nur lateinischen Text abdeckt. Für kyrillische, griechische oder CJK-Ausgabe setzt man FontName auf eine installierte Schrift, die das gewünschte Skript abdeckt
Die Ebene laufen lassen und den Bericht lesen
ApplyOcrSearchLayer gibt nur dann True zurück, wenn keine Seite scheiterte und nichts abgebrochen wurde. Dieser Rückgabewert ist das falsche Kriterium fürs Speichern. Lässt man ContinueOnError auf dem Standard True, liefert ein 300-Seiten-Job mit einer unlesbaren Seite False, während 299 Seiten eine korrekte Ebene tragen, und die gescheiterte Seite wurde längst in ihren alten Zustand zurückversetzt. Das Speichern hängt man besser an den Bericht:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // dort ablegen, wo ein Abbrechen-Button ihn erreicht
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0,5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
Nach einem Abbruch nicht zu speichern ist eine Abwägung, und zwar die, die hier getroffen wird. Ein abgebrochener Job hinterlässt eine Datei, die im ersten Teil durchsuchbar ist und im Rest leer, und nichts im PDF verrät dem nächsten Leser, wo die Ebene endet. Das ganze Dokument später erneut zu verarbeiten ist billiger, als ein halb indiziertes Archiv erklären zu müssen
SkipPagesWithText steht auf True und prüft, ob die Seite bereits extrahierbare Zeichen hergibt. Das hält born-digitale Seiten aus der OCR heraus, verhindert eine zweite Ebene bei zuvor verarbeiteten Dateien und macht einen wiederholten Lauf über dieselbe Ausgabe zum No-Op. Die Kehrseite: Ein einziges echtes Zeichen genügt. Ein Scan mit einer Bates-Nummer als echtem Text wird als popsSkippedExistingText gemeldet und erhält keine Ebene. So aufgebaute Archive brauchen SkipPagesWithText := False und einen sorgfältig gesetzten Seitenbereich über FirstPage und LastPage, sonst bekommen zuvor verarbeitete Seiten eine doppelte Ebene und die Extraktion liefert jedes Wort zweimal
Pixel-Budgets, Abbruch und Rollback pro Seite
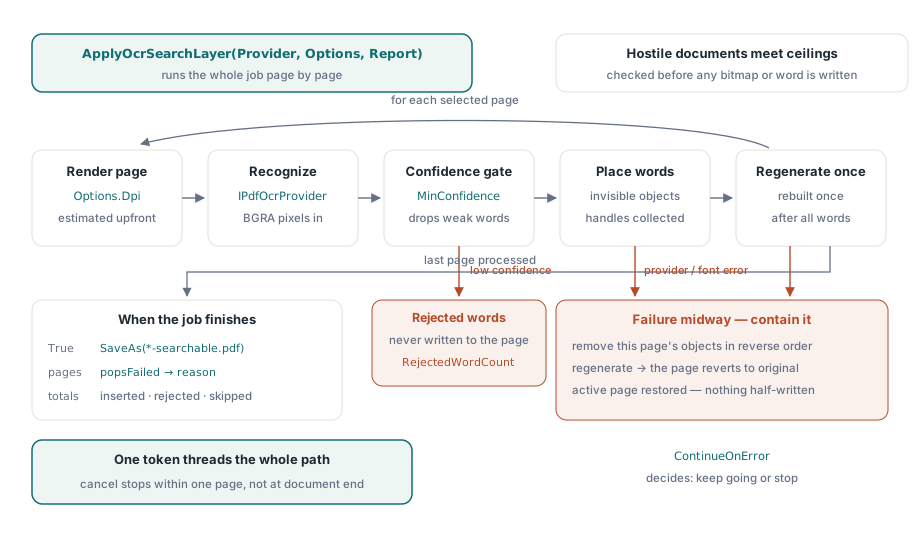
Jede Größe, die ein feindseliges oder schlicht nur riesiges Dokument aufblähen kann, hat in TPdfOcrOptions eine Obergrenze, und die Pixel-Prüfungen laufen, bevor irgendeine Bitmap zugewiesen wird. Die Rendergröße beträgt Ceil(PageWidth * Dpi / 72) mal Ceil(PageHeight * Dpi / 72), die Zahlen lassen sich also im Voraus ausrechnen:
| Seite bei 300 DPI | Bitmap | Pixel |
|---|---|---|
| US Letter, 612 × 792 pt | 2550 × 3300 | 8,415,000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8,702,320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17,415,167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139,493,228 |
Die Voreinstellungen liegen bei 100 Millionen Pixeln pro Seite und 1 Milliarde für den gesamten Job. Eine A0-Zeichnung mit 300 DPI übersteigt MaxPixelsPerPage damit im Alleingang. Das jobweite Budget ist früher erschöpft als das seitenseitige: Bei 8,415,000 Pixeln pro Letter-Seite passen 118 Seiten unter 1 Milliarde, Seite 119 scheitert mit einer Meldung, die MaxTotalPixels nennt, und jede danach ebenso. Für lange gescannte Archive erhöht man MaxTotalPixels wie im Beispiel oben oder teilt die Arbeit über FirstPage und LastPage in Bereiche. Übersprungene Seiten werden nie gerendert und zählen nicht. Der mitgelieferte Tesseract-Adapter schraubt eine eigene Grenze obendrauf, TPdfTesseractOptions.MaxPixels, die auf 16,777,216 steht; ein A3-Blatt mit 300 DPI liegt knapp darüber, weshalb A3-Batches die Adaptergrenze anheben oder die DPI senken
DPI muss zwischen 36 und 1200 liegen. Eine Verdopplung von 300 auf 600 vervierfacht die Bitmap, und jedes Pixel kostet 4 Byte, sodass eine Letter-Seite von rund 34 MB BGRA auf rund 135 MB anwächst. Bei gewöhnlichen Office-Scans wägt 300 DPI den Ausgleich zwischen Erkennungsqualität und Speicher; 600 lohnt sich für Kleingedrucktes und Fußnoten, nicht für ganze Archive. Wortzahlen begrenzen MaxWordsPerPage und MaxTotalWords, und ein Provider, der mehr Wörter liefert als die Seite erlaubt, scheitert mit der Seite, statt abgeschnitten zu werden
Das Abbruch-Token erreicht das fortschreitende Rendering, den Provider-Aufruf und die Schleife, die Wörter einfügt. Wer bei der Erkennung von Seite 212 einer 400-Seiten-Datei abbricht, stoppt auf Seite 212, sofern der Provider den ihm gereichten Token respektiert. Der Tesseract-Adapter geht einen Schritt weiter und registriert einen Cancel-Callback bei der Engine, dazu standardmäßig ein Timeout von 60,000 ms pro Seite
Die Schadensbegrenzung läuft pro Seite. Die Ebene behält das Handle jedes eingefügten Textobjekts und ruft FPDFPage_GenerateContent einmal auf, nachdem das letzte Wort der Seite platziert ist. Schlägt zwischendrin etwas fehl, etwa eine Schrift, die ein Zeichen verweigert, oder ein Abbruch mitten in der Schleife, werden die auf dieser Seite bereits eingefügten Objekte in umgekehrter Reihenfolge entfernt und der Seiteninhalt neu erzeugt, sodass die Seite wieder nur führt, was sie vorher hatte. Die Schleife läuft danach gemäß ContinueOnError weiter oder stoppt, und die Seite, die vor dem Aufruf aktiv war, ist es hinterher wieder
Das Ergebnis prüfen
Zwei Prüfungen decken das meiste ab, was schiefgehen kann. Die erste ist visuell: eine Seite aus der Originaldatei und dieselbe Seite aus der verarbeiteten Datei in derselben Größe mit TPdf.RenderPage rendern, dann die Bitmaps vergleichen. Erwartung: identisch, denn Modus 3 zeichnet nichts und der Bildstream wurde nicht angetastet; jeder Pixelunterschied bedeutet, dass etwas anderes als die Textebene die Seite verändert hat. Die zweite prüft, dass die Wörter existieren und dort sitzen, wo der Scan sie zeigt:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Man nehme ein Probewort, das man auf dem Scan mit bloßem Auge findet, eine Überschrift oder eine Summe, und vergleiche die gemeldeten Koordinaten mit seiner Position im gerenderten Bild. Auf der CropBox-Seite aus dem Eingangsbeispiel sollte der x-Wert bei 36 oder mehr beginnen, nie nahe null. Die Extraktionsseite behandelt Text aus PDF-Dokumenten extrahieren ausführlicher, das Rendern von Seiten für ein Ausrichtungs-Overlay PDF-Seiten in JPEG umwandeln, und das durchgängig genutzte Token-Muster abbrechbares fortschreitendes Rendering
OCR-Ebenen liegen neben Rendering, Textextraktion und Seitenbearbeitung auf demselben TPdf-Objekt, in Delphi, C++Builder und Lazarus. Editionen und die vollständige API-Liste finden sich auf der Produktseite PDFium Component für Delphi