Mit ausgeschalteter Überlaufprüfung evaluated 2000000000 + 2000000000 zu -294.967.296, wenn beide Operanden Delphi-Integer-Werte sind. Diese Zahl hört auf, Trivia zu sein, in dem Moment, in dem ein Container-Parser aus einem Record-Header einen Offset und eine Länge liest und sie addiert, um zu sehen, ob eine eingebettete PDF in den Puffer passt. Die Summe läuft negativ über, der Vergleich gegen Length(Data) besteht, und die nächste Zeile nimmt die Adresse eines Bytes, das grob zwei Gigabyte hinter dem Ende des Arrays liegt. Eine PDF aus der Mitte eines größeren Puffers zu laden braucht eine Bereichsprüfung, die nie addiert, und eine klare Antwort darauf, wem die Bytes gehören, sobald das Dokument offen ist
Dieser Artikel behandelt Dokumente, die bereits im RAM liegen, an einem bekannten Offset innerhalb von etwas anderem. Dokumente, die zu groß für den Speicher sind, sind ein anderes Problem, gelöst durch das Ziehen von Blöcken von der Platte bei Bedarf, wie in Streaming großer PDF-Dateien bei Bedarf mit PDFium VCL beschrieben. Der letzte Abschnitt zieht die Grenze
Eine eingebettete PDF an bekanntem Offset
Ein Mail-Store hält Nachrichtenköpfe und Anhänge in einem Record. Ein Archivcontainer konkateniert ein Manifest, ein paar Bilder und eine PDF. Ein eigenes Wire-Protokoll rahmt ein Dokument hinter einem Längenpräfix-Header. Angenommen, der Record ist 40 MB groß, die PDF beginnt bei Byte 1.182.336 und läuft 312 KB lang. Der gewohnte Code ruft Copy(Data, Index, Count), um ein Slice zu schneiden, und reicht dieses Slice an einen Loader weiter, der es erneut in seinen eigenen Puffer kopiert. Mit dem Container gerechnet existieren dieselben 312 KB jetzt dreimal, und ein Postfach-Scan wiederholt das für jede Nachricht
Die PDFium-Komponente adressiert das Fenster direkt. TPdf deklariert LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True), wobei Index eine nullbasierte Byte-Position ist und Count eine Byte-Länge. Die Methode validiert beide Zahlen, berechnet einen einzigen Zeiger und delegiert an die Zeiger-Form LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean), die das Dokument über FPDF_LoadMemDocument64 öffnet. Die Ganzarray-Form LoadDocument(const Data: TBytes; Buffered: Boolean) ist ein einzeiliger Aufruf der Byte-Range-Form mit 0 und Length(Data), sodass jede TBytes-Last durch dieselbe Validierung läuft
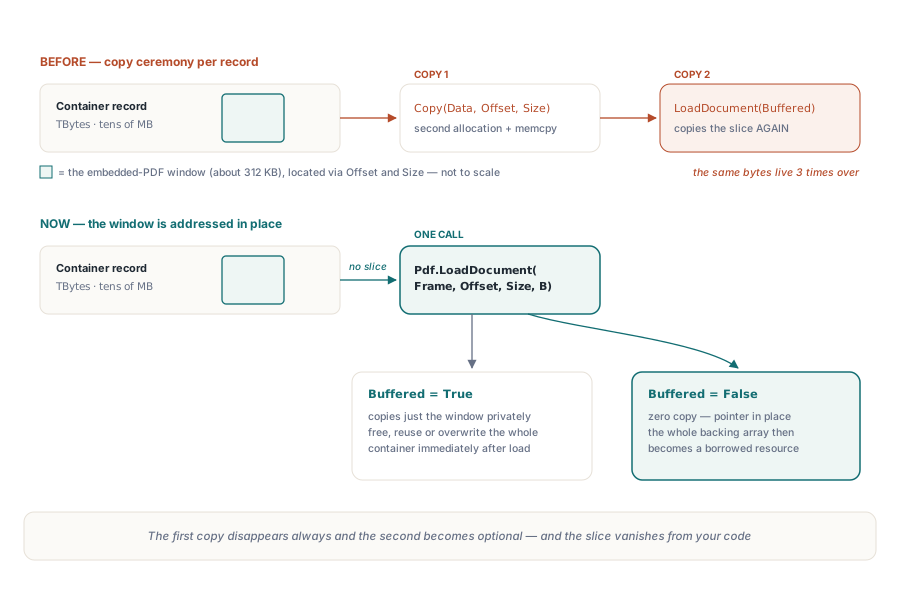
Im Code verschwindet das Slice einfach. LocateEmbeddedPdf steht für Ihren eigenen Container-Parser
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // der ganze Container-Record, etliche Megabytes
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // Ihr Parser, nicht Teil der Komponente

  Pdf := TPdf.Create(nil);
  try
    // Kein Copy(Frame, Offset, Size): das Fenster wird an Ort und Stelle adressiert
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered ist standardmäßig True
    Frame := nil;  // hier in Ordnung: nur das PDF-Fenster wurde kopiert
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // schließt das Dokument
  end;
end;
Solange das globale EnableV8Engine noch False ist und die PDFium-Bibliothek noch nicht geladen wurde, scannen die Speicher-Loader die ankommenden Bytes nach XFA-Markern und schalten EnableV8Engine an, wenn sie welche finden, damit die V8-fähige DLL geladen wird. Beim Byte-Range-Aufruf sieht dieser Scan nur das Fenster. Ein Manifest oder ein zweites Dokument anderswo im selben Record kann ihn nicht auslösen
Warum lässt Index plus Count die Grenzprüfung überlaufen?
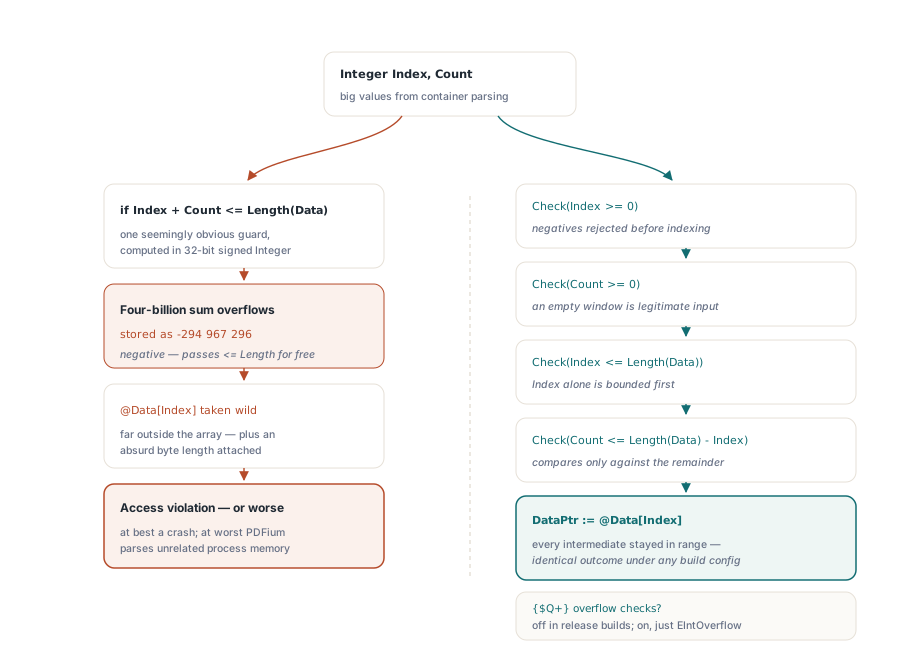
Weil Index und Count beide 32-Bit-Integer mit Vorzeichen sind, und die Addition zweier großer positiver Werte nicht zuverlässig ein großes positives Ergebnis produziert. Wo Offset und Länge aus einem Datei-Header kommen, kontrollieren ein Angreifer oder ein korrupter Record beide. Dieselbe Falle lauert in Ihrem eigenen Container-Parser, der diese Zahlen zuerst berechnet
// Ein Helfer für Ihren eigenen Container-Parser (Vorschlag, nicht Teil der Komponente)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // FALSCH: Index + Count wird als Integer ausgewertet und kann negativ umbrechen
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // RICHTIG: Vorzeichen abweisen, Index für sich begrenzen, dann Count
  // gegen den Rest vergleichen; die einzige Arithmetik ist eine Subtraktion, die nicht umbrechen kann
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;
Man rechne den fehlschlagenden Fall durch. Mit Index = 2000000000 und Count = 2000000000 ist die wahre Summe vier Milliarden, aber 32-Bit-Ganzzahlarithmetik mit Vorzeichen speichert sie als -294.967.296. Dieser Wert liegt bequem unter jedem Length(Data), also besteht die falsche Prüfung, und @Data[Index] zeigt weit außerhalb des Arrays, mit einer Zwei-Gigabyte-Länge angehängt. Ein Crash ist der gute Ausgang. Der schlechte ist PDFium, das ebendort lebenden Prozessspeicher parst
Die korrekte Reihenfolge addiert nie. Negative Werte werden zurückgewiesen, bevor irgendetwas indiziert wird. Index wird dann allein gegen Length(Data) begrenzt, was garantiert, dass Length(Data) - Index ein nicht-negativer Integer ist, und erst danach wird Count gegen diesen Rest verglichen. Delphi evaluated and standardmäßig mit Short-Circuit-Logik ({$B-}), jeder spätere Term läuft also erst, wenn die früheren halten. Lehnen Sie sich nicht an {$Q+} als Sicherheitsnetz: Release-Builds werden routinemäßig mit ausgeschalteter Überlaufprüfung ausgeliefert, und mit eingeschalteter haben Sie nur ein Speichersicherheitsloch gegen ein EIntOverflow getauscht, das mitten aus einer Validierungsroutine entweicht
Das Byte-Range-LoadDocument fährt dieselben vier Tests in derselben Reihenfolge und wirft EPdfError mit einer Meldung, die die verletzte Regel nennt: „PDF byte range index cannot be negative“, „PDF byte range count cannot be negative“, „PDF byte range index exceeds data length“ und „PDF byte range exceeds data length“. Jede davon lässt sich mit einem Vier-Byte-Array reproduzieren. Index = 5, Count = 0 löst die dritte Meldung aus, Index = 2, Count = 3 die vierte, und nach jeder Zurückweisung ist Pdf.Active weiterhin False. Die Behandlung nicht vertrauenswürdiger Längen über die native Grenze hinaus wird breiter behandelt in Härtung der PDFium-VCL-ABI und Speichersicherheit in Delphi
Ein Fenster der Länge null ist trotzdem ein legaler Aufruf
Ein leeres Fenster übergibt einen nil-Zeiger, denn @Data[Index] ist nicht für jeden von der Validierung akzeptierten Index ein legaler Ausdruck. Index = Length(Data) mit Count = 0 ist ein wohlgeformtes leeres Fenster am Ende des Puffers, und ein leeres TBytes ergibt Index = 0 bei einem Array, das gar kein Element null hat. Die Adresse in beiden Fällen zu nehmen, indiziert über das Ende hinaus oder dereferenziert ein nil-dynamisches Array, und mit eingeschalteter Bereichsprüfung wirft Delphi ERangeError, bevor der Loader überhaupt läuft
Die Byte-Range-Überladung verzweigt daher: Count = 0 ergibt nil, jede andere Count ergibt @Data[Index]. Die Zeiger-Überladung akzeptiert nil nur zusammen mit einer Größe von null, PDFium lehnt dann ab, einen leeren Puffer zu öffnen, und der Aufruf endet in einer gewöhnlichen EPdfError mit PDFiums letzter Fehlermeldung, oder „Cannot load PDF document“, wenn PDFium keine meldet. Ein Header, der einen Null-Byte-Anhang behauptet, bekommt dieselbe abfangbare Exception wie jede andere fehlerhafte Eingabe. In Ihrem eigenen Parser abzuweisen, mit der Record-Nummer in der Meldung, liest sich in einem Support-Log trotzdem besser
Buffered entscheidet, wem die Bytes gehören
Buffered ist hier der einzige Parameter, dessen Konsequenzen den Aufruf überdauern. Mit Buffered = True kopiert die Komponente das ausgewählte Fenster, und nur das Fenster, in ihren eigenen Puffer, bevor geladen wird. Im 40-MB-Beispiel werden 312 KB kopiert und der Container bleibt unangetastet. Sobald LoadDocument zurückkehrt, dürfen Sie den Container sofort freigeben, wiederverwenden oder überschreiben
Mit Buffered = False geht @Data[Index] direkt an FPDF_LoadMemDocument64, und PDFium liest durch diesen Zeiger weiter, solange das Dokument offen ist. Das gesamte zugrunde liegende TBytes wird geliehen. Es muss lebendig und unverändert bleiben, bis Sie Active := False setzen oder das TPdf freigeben. Das ganze Array zählt, nicht nur das Fenster: Ein Delphi-dynamisches Array ist als ein Block referenzgezählt, sodass das Fallenlassen der letzten Referenz irgendwo im eigenen Code den Speicher freigibt, den PDFium noch liest. SetLength ist genauso fatal. Eine Reallokation kann den Block verschieben
Zwei Delphi-Details machen das leichter falsch zu bekommen, als es aussieht. Dynamische Arrays haben kein Copy-on-Write, anders als Strings, sodass Other := FFrame; Other[0] := 0; genau in die Bytes schreibt, die PDFium parst. Und ein Empfangspuffer, den Ihre Netzwerk-Code für den nächsten Frame wiederverwendet, wird unter dem offenen Dokument überschrieben. Ein Funktionsergebnis direkt durchzureichen, wie in Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False), lässt das Array von einem versteckten Temporary gehalten, das mit der aufrufenden Routine stirbt, während das Dokument weiterlebt
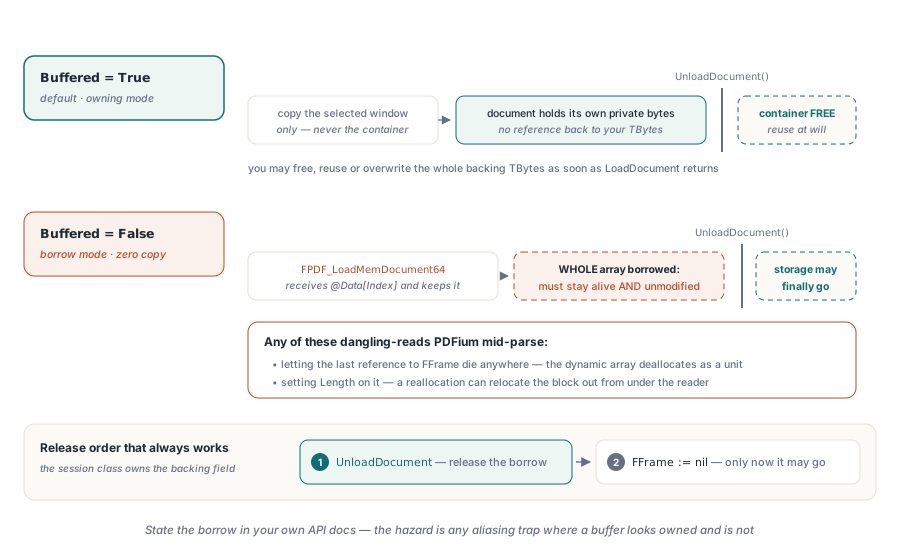
Halten Sie Buffered = True für alles, was einen Thread kreuzt, einen Netzwerk-Puffer oder irgendetwas mit unklarer Lebensdauer; die Kopie ist der Preis für einen frei implementierbaren Aufrufer. Der Modus zum Borgen zahlt sich aus, wenn derselbe Frame wiederholt geöffnet wird oder die Kopie den Anwendungs-Speicherbestand spürbar sprengen würde
type
  TFrameSession = class
  private
    FFrame: TBytes;   // besitzt den dahinterliegenden Speicher, solange FPdf ein Dokument offen hat
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // teilt das Array; niemand sonst darf jetzt hineinschreiben
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // erst jedes frühere Fenster schließen
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame muss dieses Dokument überleben
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. das Borg freigeben
  FPdf.Free;
  FFrame := nil;         // 2. erst jetzt darf der Speicher gehen
  inherited;
end;
Der Konstruktor teilt das Array des Aufrufers, statt es zu kopieren, der Aufrufer muss also aufhören, hineinzuschreiben. Kann man das nicht versprechen, reicht man Copy(AFrame) an den Konstruktor, und man ist wieder bei einer Kopie, einmal pro Session statt einmal pro Ladevorgang
Prüfen, ob das Fenster bei %PDF- beginnt
Ein Fenster, das um ein paar Bytes daneben liegt, ist der subtile Fehlschlag, denn das Dokument kann trotzdem öffnen. ISO 32000-1 §7.5.4 definiert jeden Cross-Reference-Eintrag als Byte-Offset vom Dateianfang, und §7.5.2 setzt den %PDF--Header an den Anfang. Zählt Ihr Parser ein Präfix falsch und das Fenster beginnt acht Bytes zu früh, liegen diese Offsets um acht Bytes daneben. PDFium sucht den Header in den ersten 1024 Bytes und gleicht führenden Müll aus; ein Fenster, das spät beginnt oder früh endet, kann es dazu drängen, die Cross-Reference-Tabelle aus den Objektmarkern, die es findet, neu zu bauen. In beiden Fällen sieht die Seitenzahl richtig aus. Der Offset in Ihrem Parser ist trotzdem falsch, und der nächste Reader dieses Records ist vielleicht weniger nachsichtig
Die Überladung LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) macht das sichtbar. Report.HeaderOffset ist die Stelle, an der %PDF- in den ersten 1024 Bytes des Fensters gefunden wurde, oder -1, wenn nicht. Report.UsedRecovery ist True, wenn PDFium die Cross-Reference-Tabelle nicht als gültig akzeptiert hat. Alle Offsets im Report zählen vom ersten Byte des Fensters, nicht vom Container. Ein zu kurzes Count schneidet das abschließende %%EOF ab, und TPdfLoadOptions.Default(plmStrict) schaltet RequireFinalEndOfFileMarker ein, sodass der strenge Modus dieses Fenster rundheraus ablehnt
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning ist Ihre eigene Logging-Routine
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
Die Prüfung hinter diesen Feldern hat eine Kosten, die bei geliehenen Ladevorgängen zählt. Passt das Fenster innerhalb von Options.AuditByteLimit (256 MB als Vorgabe), liest die Prüfung eine temporäre Kopie des Fensters, also ist Buffered = False kombiniert mit einem Report während des Ladens nicht mehr kopiefrei. AuditByteLimit auf 0 überspringt Prüfung und Kopie und lässt HeaderOffset bei -1. Fahren Sie die geprüfte Form, während Sie den Container-Parser entwickeln und gegen neue Record-Quellen; wechseln Sie zur schlichten Überladung, sobald den Offsets zu vertrauen ist. Den Rest des Reports behandelt Abfangen von PDF-Ladefehlern mit einem PDFium-Load-Report
Wenn ein Bytebereich das falsche Werkzeug ist
Die Byte-Range-Überladung setzt voraus, dass der ganze Container bereits im Speicher liegt, und weil Count ein Integer ist, kann ein Fenster MaxInt Bytes nicht überschreiten. Ein 6-GB-Archiv auf der Platte oder ein Socket, den man nicht zurückspulen kann, passt nicht in diese Form, und alles in TBytes zu lesen, nur um ein Fenster darin zu adressieren, verfehlt den Zweck. Für diese Fälle lässt LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) PDFium Blöcke aus einem seekbaren Stream bei Bedarf ziehen. Ein kleiner eigener TStream-Nachfahre, der zu jedem Seek den Start-Offset der PDF addiert, präsentiert das eingebettete Dokument, als begänne es bei Position null, wie der Artikel zum On-Demand-Streaming zeigt
Die andere Fehlanpassung ist Inhalt, der noch keine schlichte PDF ist. Sind die eingebetteten Bytes komprimiert, vom Container verschlüsselt oder in einer anderen Kodierung verpackt, ist eine transformierte Kopie unvermeidbar, und das Laden des neuen Arrays mit der Vorgabe Buffered = True ist die geradlinige Antwort. Der Bytebereich zahlt sich in genau einer Form aus: zusammenhängende, unveränderte PDF-Bytes, bereits resident, an einem Offset, den Ihr Parser ohne Addition validiert hat
Der Byte-Range-Aufruf sitzt neben Datei-, Stream-, Rohzeiger- und On-Demand-Laden in derselben TPdf-Komponente. Die Produktseite der PDFium-Komponente listet die unterstützten Delphi- und C++Builder-Versionen, Lizenzoptionen und den Rest der Lade-API