Öffnen Sie dasselbe Rechnungs-PDF auf Windows und auf einem Telefon, und die Zeilenumbrüche, Fonts und das Logo landen an identischen Stellen. Eine PDF-Datei ist eine Menge nummerierter Objekte plus ein Byte-Offset-Index, und ein Reader wie die PDFium-Engine in PDFium Component öffnet sie vom Ende: startxref, Xref-Tabelle, Katalog, Seitenbaum, Content Streams, dann Pixel
Was also ist eine PDF-Datei, und warum sieht sie überall gleich aus? Word- und RTF-Dokumente speichern Text und Stile und überlassen das Layout der Maschine, die sie öffnet, also fließt ein fehlender Font oder ein anderer Druckertreiber die Seiten neu um. PDF speichert stattdessen das fertige Ergebnis. Jeder Glyph und jede Zeile hat eine absolute Position in einem Koordinatenraum, gemessen in Punkt, die Font-Programme reisen in der Datei mit, und Bilder tragen ihre eigenen Farbdaten und Kompressionsfilter. Nichts wird zur Betrachtungszeit layoutet, weshalb jeder konforme Renderer auf jedem Betriebssystem dieselbe Seite malt. Das Format begann als PDF 1.0 mit Acrobat 1993, gebaut auf dem PostScript-Imaging-Modell, und jede Revision ergänzte einen Teil der Maschinerie, die unten beschrieben wird:
- PDF 1.1 bis 1.4 brachten Verschlüsselung, interaktive Formulare, digitale Signaturen mit logischer Struktur und Transparenz
- PDF 1.5 ergänzte Object Streams und Cross-Reference-Streams; PDF 1.6 ergänzte AES-Verschlüsselung
- PDF 1.7 wurde ISO 32000-1:2008, und PDF 2.0 wurde ISO 32000-2:2017, überarbeitet 2020
- PDF/A (ISO 19005), PDF/X (ISO 15930) und PDF/UA (ISO 14289) beschränken diese Basis für Archivierung, Druckproduktion und Barrierefreiheit
Was passiert, wenn ein Reader eine PDF-Datei öffnet?
Ein PDF zu öffnen ist eine Kette von Nachschlägen, die an den letzten Bytes der Datei beginnt und mit einer Bitmap endet. Fast jedes Glied in dieser Kette ist ein Dictionary, einer der Basisobjekttypen in ISO 32000-1 §7.3, und Dictionaries zeigen mit indirekten Referenzen wie 7 0 R (Objekt 7, Generation 0) aufeinander. Die Datei verhält sich also wie ein Graph von Objekten statt wie eine Folge von Seiten. Header, Body, Cross-Reference-Tabelle und Trailer sind in der Übersicht der PDF-Dateistruktur dargelegt, und ein minimales PDF, Zeile für Zeile kommentiert zeigt, wie obj, endobj und stream in einem Texteditor aussehen. Hier ist die Reihenfolge, der jeder Reader folgt
- Ans Ende der Datei springen und den Byte-Offset lesen, der hinter dem
startxref-Schlüsselwort geschrieben steht - Die Cross-Reference-Daten an jenem Offset laden, die jede Objektnummer auf eine Position in der Datei abbilden
- Den Trailer lesen und
/Rootzum Dokumentkatalog folgen - Dem
/Pages-Eintrag des Katalogs den Seitenbaum hinunter zum angefragten Seitenobjekt folgen - Den Content Stream der Seite dekodieren und seine Operatoren der Reihe nach interpretieren
- Die Fonts, Bilder und Form XObjects, die jene Operatoren nennen, über
/Resourcesauflösen - Pfade, Glyphen-Umrisse und Bilder bei der Geräteauflösung in Pixel rastern
Schritt eins: startxref und die Cross-Reference-Tabelle
Ein Reader scannt ein PDF nie von oben. Eine wohlgeformte Datei endet mit dem Schlüsselwort startxref, einer Dezimalzahl wie 48211 und %%EOF, und jene Zahl ist der Byte-Offset der Cross-Reference-Daten. Eine naive Rückwärtssuche nach xref hält in startxref an, suchen Sie also nach dem vollen Schlüsselwort. Die klassische Tabelle benutzt Einträge fester Breite (§7.5.4), was einem Reader erlaubt, zum Eintrag jeder Objektnummer zu springen, ohne die anderen zu parsen; das Byte-Layout jedes Eintrags behandelt die Strukturübersicht. Der Trailer hinter der Tabelle nennt /Size, /Root und optional /Encrypt, /ID und /Prev
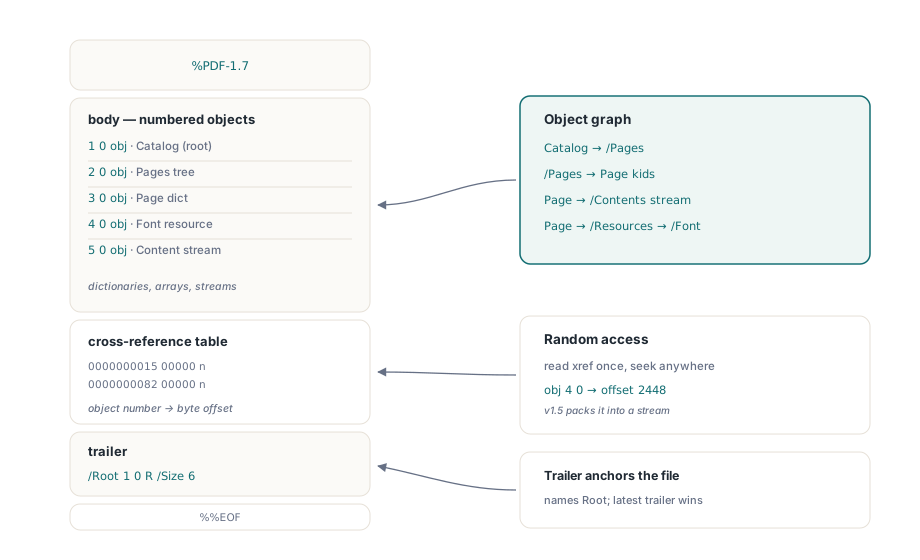
Jeder Eintrag ist eine absolute Byte-Position, also lässt alles, was Bytes verschiebt, etwa ein Editor, der Zeilenenden umschreibt, den Index auf falsche Stellen zeigen. Reader mit Reparaturdurchlauf bauen ihn neu, indem sie nach obj-Schlüsselwörtern scannen; Reader ohne einen weisen die Datei zurück, weshalb ein beschädigtes PDF im einen Viewer aufgeht und im anderen scheitert. Was am startxref-Offset sitzt, sagt Ihnen, welcher Fall vorliegt: das Schlüsselwort xref für eine klassische Tabelle, ein N 0 obj-Header für einen PDF-1.5-Cross-Reference-Stream, und alles andere für einen veralteten Offset. Der Helfer unten ist Ihr eigener Code, gebaut auf schlichten RTL-Streams
uses
  System.SysUtils, System.Classes;

// Eigener Helfer: Offset ist die Zahl, die hinter startxref geschrieben steht.
// Ordnet ein, was der Reader an jener Position finden wird
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
Ein Cross-Reference-Stream (§7.5.8) ist ein komprimiertes Objekt mit /Type /XRef, einem /W-Array mit der Byte-Breite jeder Spalte und binären Zeilen, die entweder auf einen Byte-Offset oder in einen Object Stream zeigen (§7.5.7). Die Trailer-Schlüssel wandern in sein Dictionary, die Datei hat also gar kein trailer-Schlüsselwort. HotPDF schreibt diese Form, wenn UseXRefStream auf THotPDF gesetzt ist. Für Dateien, die Ihre Kontrolle verlassen, etwa Mail-Anhänge oder Uploads an Druckereien, bleibt die klassische Tabelle die sicherere Wahl, denn Reader aus der Zeit vor PDF 1.5 parsen sie noch. PDF/A-1 entscheidet die Frage für Archive: ISO 19005-1 baut auf PDF 1.4 auf, und sein §6.1.4 stellt fest, dass Cross-Reference-Streams nicht benutzt werden dürfen, also schreibt HotPDF eine klassische Tabelle, wann immer ein PDF/A-1-Profil aktiv ist
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
Von /Root zur richtigen Seite: Katalog und Seitenbaum
Der /Root des Trailers zeigt auf den Dokumentkatalog, und der /Pages des Katalogs auf die Wurzel des Seitenbaums. Jeder Zwischen-/Pages-Knoten trägt ein /Count der Blattseiten unter sich, also subtrahiert ein Reader, der Seite 5000 sucht, Zähler beim Abstieg und überspringt ganze Teilbäume ungeöffnet. ISO 32000-1 §7.7.3 verlangt keinen balancierten Baum; ein einzelnes /Kids-Array mit 10000 Einträgen ist legal, nur langsamer zu durchsuchen. Code, der nur das Blatt liest, fällt in eine Falle. /Resources, /MediaBox, /CropBox und /Rotate sind vererbbar (§7.7.3.4), also ist eine Seite ohne eigenes /MediaBox weiterhin gültig, weil der Wert bei einem Vorfahren lebt
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
Die Media Box setzt den Koordinatenraum für alles, was auf der Seite gezeichnet wird: Ursprung unten links, Y läuft nach oben, eine Einheit entspricht 1/72 Zoll, sofern kein /UserUnit aus PDF 1.6 sie skaliert. PDFium Component vollzieht den ganzen Abstieg, wenn Sie eine Seite per Nummer anfragen. TPdf.PageMetrics liefert die Seitengröße in Punkt mit bereits aufgelösten geerbten Boxen, dazu die Seitenrotation, das Listing unten meldet also korrekte Größen auch für Dateien, deren Blattseiten keine eigene Box tragen
uses
  System.SysUtils, PDFium;

// Druckt die Seitenzahl und die Größe jeder Seite in Punkt
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // parst die Xref-Daten, den Trailer und den Katalog
    if not Pdf.Active then        // ein fehlgeschlagener Ladevorgang lässt Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // 1-basiert; lädt die Seite durch den Baum
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
Wie zeichnet ein PDF eine Seite auf dem Bildschirm?
Der sichtbare Inhalt einer Seite ist ein kleines Programm: Postfix-Operatoren in einem oder mehreren Content Streams, der Reihe nach interpretiert, nachdem der Reader den in /Filter genannten Dekodierer laufen ließ, meist /FlateDecode. BT öffnet ein Textobjekt, Tf wählt eine Font-Ressource und Größe, Td verschiebt die Textposition, Tj malt einen String, und ET schließt das Objekt. Pfade werden mit m, l, c und re gebaut, dann mit f gefüllt oder mit S gestrichen. Der Graphics State (§8.4) hält, was jene Operatoren implizit lesen, etwa die Transformationsmatrix, Farben und den Clipping-Pfad. q schiebt eine Kopie, Q poppt sie, eine im Paar gesetzte Transformation kann also nicht in späteren Content lecken
q
1 0 0 1 72 700 cm     % Ursprung nach (72, 700) verschieben
BT
  /F1 12 Tf           % Font-Ressource F1 mit 12 Punkt
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % Stroke-Farbe, durch q/Q begrenzt
0 -6 m 140 -6 l S
Q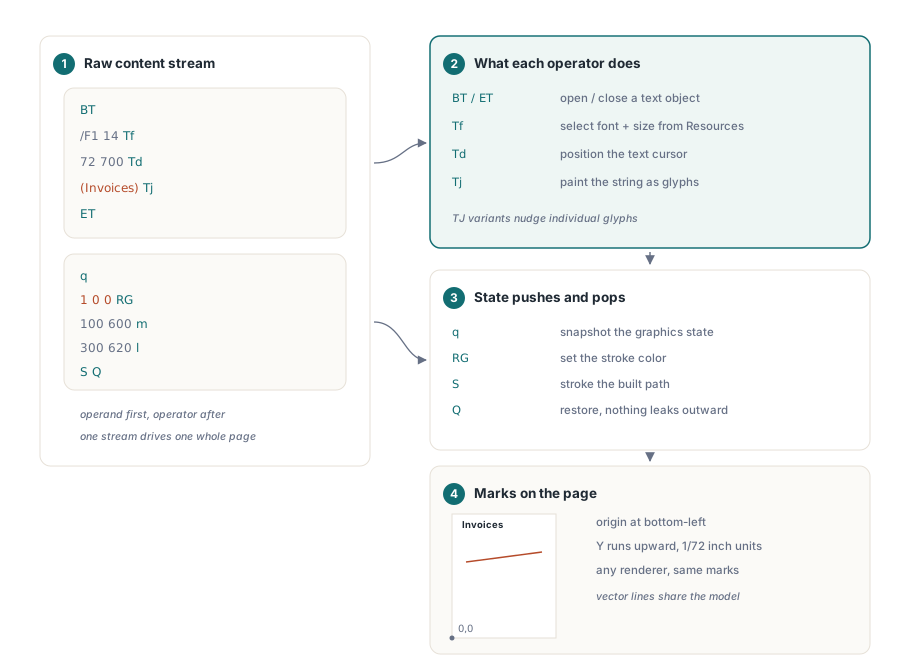
Namen wie /F1 sind Schlüssel in die /Resources der Seite. Ein Font-Dictionary führt über seinen Font Descriptor (§9.8) zum eingebetteten Font-Programm, und ein Bild wird mit einem einzigen Do gemalt, sobald seine JPEG- oder Flate-Daten dekodiert sind. Die Rasterung kommt zuletzt. Der Renderer wendet die Transformationsmatrix auf jeden Pfad und jeden Glyphen-Umriss an, mappt Punkte auf Gerätepixel und füllt das Ergebnis mit Anti-Aliasing. Weil die Seite an jenem Punkt noch Vektordaten sind, führt das Zoomen auf 400 Prozent den Content Stream in größerem Maßstab erneut aus, statt eine Bitmap zu dehnen. Die Zielauflösung wählt der Aufrufer: 96 oder 150 Pixel pro Zoll für einen Bildschirm, 300 oder mehr für den Druck. In PDFium Component ist jene Stufe TPdf.RenderPage, das die Ausgabegröße in Pixeln entgegennimmt
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// Rendert Seite 1 von FileName bei Dpi Pixel pro Zoll und sichert sie als BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // 1-basiert
    // PageWidth und PageHeight sind in Punkt (1/72 Zoll)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // die Funktionsform liefert eine neue Bitmap
    end;
  finally
    Pdf.Free;
  end;
end;
Warum liefert Copy-Paste Müll, obwohl die Seite gut aussieht?
Copy-Paste scheitert, wenn die Datei festhält, welcher Glyph zu zeichnen ist, aber nicht, für welches Zeichen er steht. Rendern braucht nur Glyphenformen aus dem eingebetteten Font-Programm. Extraktion braucht Unicode, der aus einer Standard-Kodierung oder einer /ToUnicode-CMap am Font-Dictionary kommt (§9.10.3). Ein Composite Font mit /Encoding /Identity-H schreibt rohe Glyph-IDs in den Content Stream, und ohne ToUnicode-Map haben jene IDs keine definierte Beziehung zu irgendeinem Zeichen. Der Bildschirm sieht perfekt aus, während sich die Zwischenablage mit Symbolen füllt. Subset-Fonts machen das wahrscheinlicher, denn sie behalten nur die Glyphen, die das Dokument benutzt, und sind leicht am sechsstelligen Präfix in Namen wie /BaseFont /AAAAAA+ArialMT zu erkennen (§9.6.4). Der Leitfaden zur PDF-Font-Behandlung behandelt CJK-Fonts und kaputte Extraktion in der Tiefe
Inkrementelle Updates und der Signatur-Byte-Range
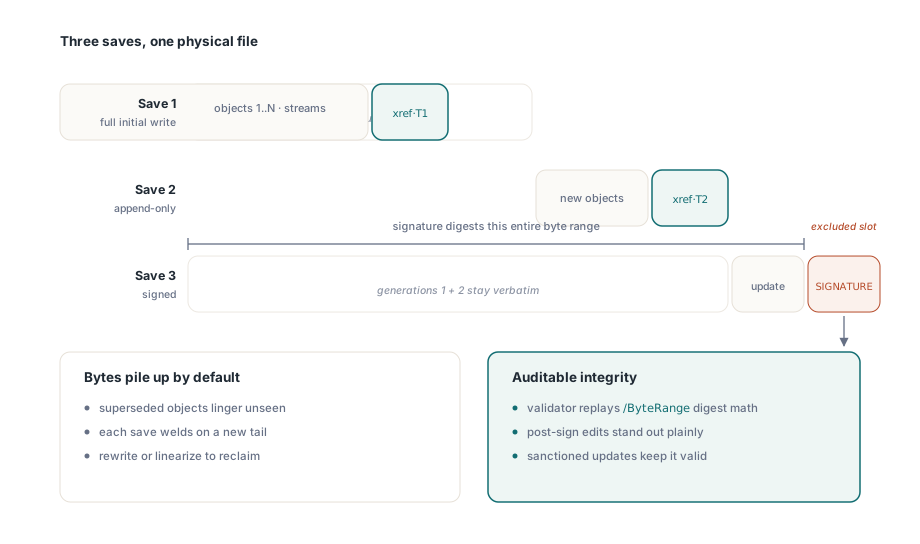
Signaturen leben von der nur-anhängen-Art, wie PDFs bearbeitet werden: Ein inkrementelles Update (§7.5.6) ergänzt Objekte und einen neuen Cross-Reference-Abschnitt hinter dem letzten %%EOF, und die Strukturübersicht erklärt die /Prev-Kette und warum gelöschter Content in früheren Revisionen überlebt. Der /ByteRange eines Signature-Dictionary, geschrieben als [0 a b c], hasht alles außer dem /Contents-Hex-String, der die CMS-Signatur hält, die signierte Revision endet also bei Byte b + c, und ein Validierer baut sie nach, indem er die Datei dort abtrennt. Spätere Revisionen landen hinter jenem Punkt, während ein vollständiges Neuschreiben, ein Linearisierer oder ein Optimier-Durchlauf Bytes verschiebt, die der Signierer gehasht hat, und jede vorhandene Signatur auf einmal invalidiert
Wenn eine Delphi- oder Lazarus-Anwendung diese ganze Pipeline braucht, vom Parsen der Cross-Reference-Daten und dem Durchlaufen des Seitenbaums bis zu Rendering und Textextraktion, wickelt die PDFium Component for Delphi and Lazarus sie in die TPdf-Dokumentkomponente ein, die in den Listings oben benutzt wird, und das TPdfView-Viewer-Control zur Bildschirmanzeige